· 158 min read
论文解读:BEVFormer,用时空 Transformer 从环视相机里长出鸟瞰图
TL;DR BEVFormer 是南京大学、上海 AI Lab 等提出的纯视觉 BEV 感知框架[1]。它不预测深度:把 BEV 平面铺成 个可学习的 query,每个 query 先沿高度方向立成一根「柱子」,用标定好的相机内外参投影到 6 个环视相机里,只在真正看得见它的 1 到 2 个视角上做可变形采样(空间交叉注意力);再把上一帧 BEV 按自车运动对齐后,用时序自注意力融合进来。检测头和地图分割头直接接在这张统一的 BEV 特征上。nuScenes 测试集 56.9 NDS / 48.1 mAP,比 DETR3D 高 9.0 NDS;速度误差 mAVE 从 0.845 降到 0.378 m/s,和 LiDAR 的 SSN(56.9 NDS)打平。nuScenes val 51.7 NDS,地图分割 lane IoU 25.7。代码和检测权重开源(Apache-2.0),BEVFormer v2 也在同一仓库里。
- 论文:BEVFormer: Learning Bird’s-Eye-View Representation from Multi-Camera Images via Spatiotemporal Transformers,Zhiqi Li、Wenhai Wang、Hongyang Li、Enze Xie、Chonghao Sima、Tong Lu、Yu Qiao、Jifeng Dai,南京大学 / 上海 AI Lab / 香港大学,ECCV 2022(arXiv 首版 2022 年 3 月,本文读的是 7 月的 v2)。
- 代码:github.com/fundamentalvision/BEVFormer,Apache-2.0;BEVFormer v2 的配置在
projects/configs/bevformerv2/。 - 预备知识:本文假定读者知道 Transformer 的注意力、DETR 式的 object query,以及相机内参/外参的基本含义;不假定读过 BEV 系列。站内可以先看 BEVFusion 解读,它从「融合空间」的角度讲了另一条 BEV 路线。
一、动机:相机 3D 感知卡在「表示」上
自动驾驶的 3D 感知要回答两个问题:周围有什么(检测),路在哪里(地图分割)。LiDAR 直接给出三维点云,几何精度高,但贵、重、远距离稀疏;相机便宜、分辨率高、能读红绿灯和车道线,所以纯视觉路线一直有人做。真正难的不是「看到」,而是把 6 张不同视角的透视图像变成一份统一的三维表示。
1.1 三条路线的天花板
单目路线(FCOS3D[2]、PGD[3]、DD3D[4])逐张图像预测 3D 框,再把不同相机的框做后处理融合。问题是网络内部没有跨相机交互:同一辆车在两个相机的重叠区各预测一次,融合只能靠 NMS 或启发式规则;深度是单目估计的,误差会一路传下去。
深度提升路线(LSS[5]、VPN[6]、Lift-Splat)先给每个像素预测一个深度分布,把像素特征沿射线「抬」到三维,再拍扁到 BEV。这条路把多相机放进同一个表示里,但深度是瓶颈:深度分布不准,BEV 特征就会被拉到错误的位置。BEVDet[7]、M²BEV[8] 分别用截断每格点数和均匀深度来近似加速,本质上还是在和深度误差做交易。
稀疏 query 路线(DETR3D[9])把一组 3D object query 投影到 2D 特征图上采样,直接回归 3D 框。它绕开了深度,但 query 是物体中心的:只关心「物体在哪里」,不产生稠密的 BEV 特征图,因此做不了地图分割这类需要背景语义的任务;而且它没有利用视频时序。
三条路线有一个共同盲区:能不能不预测深度、直接学出一张稠密的 BEV 特征图? 如果 BEV 特征本身可以由网络「问」出来,那么检测和分割就都变成 2D 任务,时序也可以在这个空间里做。
1.2 本文的答案与贡献
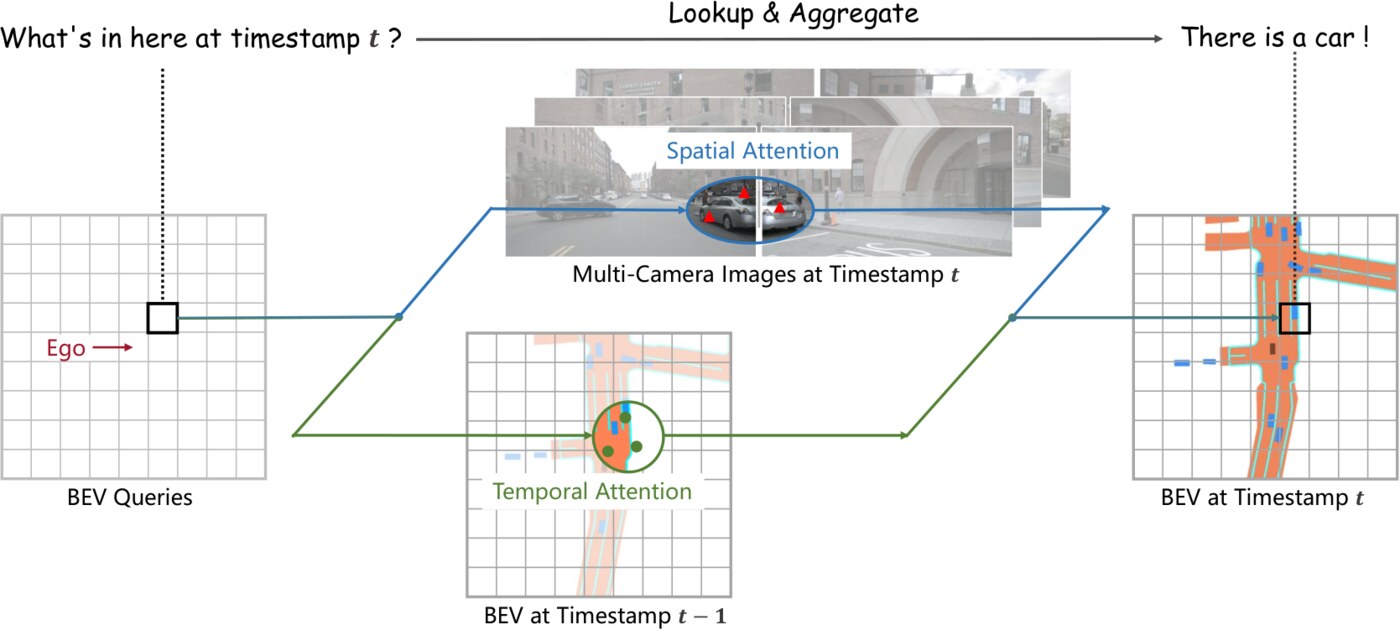
BEVFormer 的答案是把 BEV 平面铺成一张可学习的 query 网格。每个格子问一个问题:「这个位置在图像里长什么样?」几何(相机内外参)只负责告诉网络去哪里看,看什么、怎么加权则由注意力自己学。这样既不需要显式的深度分布,又保留了稠密的 BEV 表示。
论文的贡献可以概括成三条:
- 一个时空 Transformer 编码器:输入多相机图像和/或历史 BEV,输出统一的 BEV 特征,同时支持 3D 检测和地图分割。
- 两个关键设计:空间交叉注意力(每个 BEV query 只和看得见它的相机交互)和时序自注意力(把历史 BEV 当 RNN 的隐状态,按自车运动对齐后循环融合)。
- 在 nuScenes 和 Waymo 上验证:nuScenes 测试集 56.9 NDS,比 DETR3D 高 9.0;最难的 lane 分割比 Lift-Splat 高 5 个点以上;同时给出了空间/时序设计的逐项消融。
二、预备知识:看懂 BEVFormer 需要的三块积木
这一节把后面要用到的三件事讲清楚:相机投影、BEV 网格、可变形注意力。已经熟悉的读者可以跳到第三节,遇到符号再回来查。
2.1 相机模型:一个世界点如何落到像素
设世界(或自车)坐标系里有一个点 。相机的内参矩阵 描述焦距和主点,外参 描述相机相对自车的位置和朝向。针孔模型把它投到像素:
其中 就是 BEVFormer 代码里的 lidar2img(实现上用 的齐次形式)。 是点在相机坐标系下的深度:它大于 0,点才在相机前方; 落在图像宽高内,点才真的出现在这张图里。这两条判断就是后面「命中视角」的来源。
这里要区分两件事:几何决定去哪里采样,特征由注意力聚合。LSS 用几何 + 深度分布把特征搬到 BEV;BEVFormer 只用几何算出一个 2D 参考点,真正的特征读取是可变形注意力。前者依赖深度估计,后者把「这个点是什么」交给网络。
下面的部件把论文式 (4) 的投影画出来:拖三个滑块移动世界点,左图是它落到图像上的像素,右图是俯视的相机、视锥和点。点「自动绕圈」让点沿椭圆运动,观察它在图像里画出什么轨迹。
2.2 BEV:为什么鸟瞰图适合驾驶感知
BEV(bird’s-eye view,鸟瞰图)是把自车周围的地面当成一张俯视的规则网格:每个格子对应固定大小的真实区域,格子里的特征描述「这个位置及上方」的场景。它有三个好处:
- 尺度一致:不管物体在图像里近大远小,到了 BEV 里都是一样的米制尺寸,检测头不用处理透视畸变。
- 任务天然对齐:3D 框的中心、速度、地图的 lane/road 本来就在地面平面上,BEV 是这些输出的自然坐标系。
- 可融合:LiDAR、相机、毫米波都可以变到同一张网格上(BEVFusion 就是这条路)。
先看「尺度一致」。 下面的部件把同一辆车放进前视相机和 BEV:拖动距离,图像里的车按深度迅速变小,BEV 里的车始终是 4.5 m × 1.8 m;拖动横向偏移,看它在两个坐标系里怎么移动。
BEVFormer 的网格是 ,每个格子 m,覆盖自车周围 m 的正方形。格子下标 和世界坐标 的关系是
反过来,给定世界坐标,格子下标是 、。自车在网格中心 。每个格子有一个 维的可学习向量,整张网格就是 的 BEV queries 。论文还会给每个 query 加一个可学习的位置编码,让网络知道「我在网格的哪个位置」。
格子多大合适? 0.512 m 不是随便定的。下面的部件放大 10.24 m × 10.24 m 的一小块 BEV:切换格子边长,看车、lane 线和行人各占多少格,以及 query 数怎么随格子边长平方增长。
2.3 可变形注意力:少看几个点,但要看得准
标准注意力的计算量是 query 数乘 key 数。6 个相机、每张特征图 个 token,如果每个 BEV query 都和所有 token 做注意力, 个 query 要乘上百万个 token,显存和计算都不可接受。Deformable DETR[10] 的做法是:每个 query 只在一个参考点 周围采样 个点,偏移 和权重 都由 query 自己预测:
逐项读: 是 query 向量; 是参考点(二维坐标); 是在特征图上做双线性插值取到的特征; 是注意力头, 是采样点; 是第 个头第 个点的偏移; 是对应的注意力权重(对 做 softmax); 是投影矩阵。每个 query 只读 个点,计算量从「乘所有 token」变成「乘一个很小的常数」。
在 BEVFormer 里,参考点 不是学出来的,而是几何算出来的:BEV 格子 → 世界坐标 → 柱子上的 3D 点 → 相机投影。网络只学偏移和权重。这是它和 Deformable DETR 最大的区别,也是「不预测深度」的关键:几何给一个粗位置,注意力在这个位置周围自己找特征。
下面的部件把一个 query 的采样过程画出来:特征图上的亮区是一辆车的响应,红叉是参考点,8 个圆点是 。拖动红叉,或者点「偏移旋转」,看采样点怎么移动,以及有几个点落在车上。
三、核心方法
3.1 总体架构
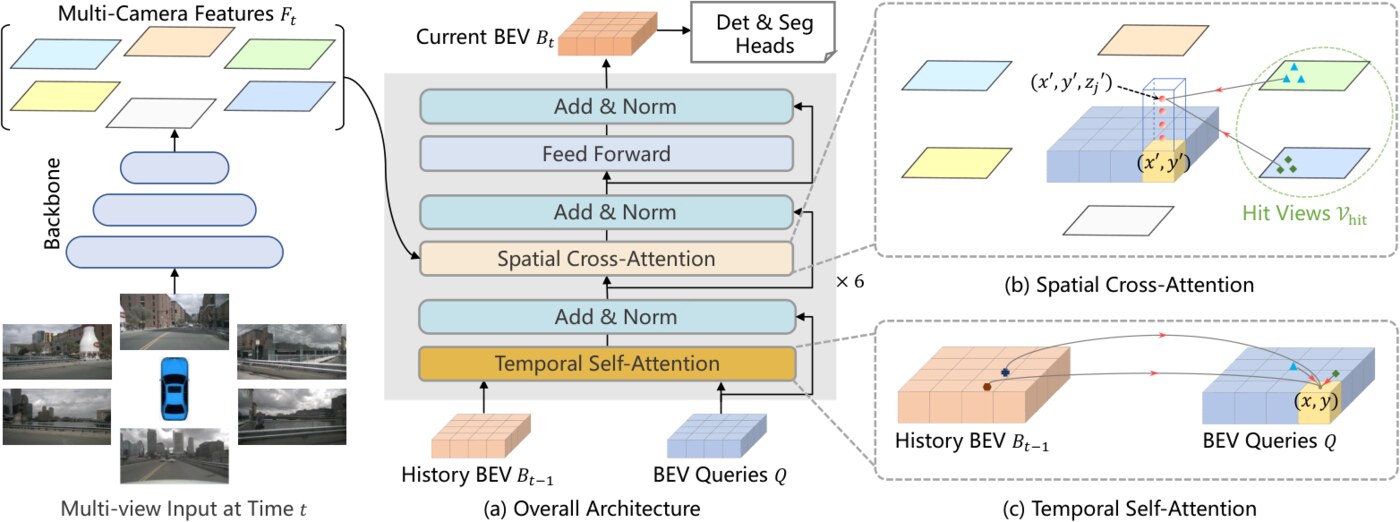
骨干网络是 ResNet-101-DCN 或 VoVNet-99,接 FPN,输出 、、 三个尺度的特征,通道统一到 256。编码器堆 6 层,每层的顺序是:
- 时序自注意力(temporal self-attention,TSA):当前 BEV query 和上一帧 BEV 交互。
- 空间交叉注意力(spatial cross-attention,SCA):当前 BEV query 和多相机图像特征交互。
- 前馈网络(FFN):逐 token 的两层 MLP。
每个子层都有残差连接和 LayerNorm。6 层之后得到 ,送给检测头或分割头。
一个容易忽略的细节:每一层的输入 query 都是同一张 (加上位置编码),层与层之间通过残差和 LayerNorm 更新的是 query 的内容,而不是换一张网格。可以把 想成 40000 个「位置固定的问题」,6 层是 6 轮「去图像和历史里找答案」。
下面的部件把整条数据流拆成 6 步,点「下一步」或「自动播放」逐段看形状怎么变。
3.2 BEV queries:把问题铺成网格
BEV queries 是 的可学习参数。每个格子 的 query 是一个 256 维向量,负责描述这个格子对应的真实区域。它和 DETR 的 object query 有两点不同:
- 数量与位置固定:DETR 的 query 是「可能有一个物体」的抽象槽位,数量少(几百个),位置由内容决定;BEVFormer 的 query 和网格一一对应,数量多(40000 个),位置先验就是「我在 (x,y)」。
- 输出是稠密特征图:object query 输出一组框,BEV query 输出一张特征图,所以可以接任意 2D 稠密头(检测、分割)。
40000 个 256 维向量本身就有约 1000 万个参数,加上 6 层注意力和 FPN,基础模型训练显存约 28.5 GB。这也是后来很多工作要压缩 BEV 分辨率的原因。
下面的部件放大 20.48 m × 20.48 m 的一小片网格:点任意格子看它的 query 向量;点「车辆移动」,看车开到哪、是哪个格子的 query 在响应。
3.3 空间交叉注意力:每个格子只问看得见它的相机
这是 BEVFormer 最核心的模块。给定一个 BEV query ,它要回答「真实世界位置 上方有什么」。做法分五步:
第一步:格子变世界坐标。 用式 (3) 把网格下标 换成米制的 。
第二步:立一根柱子。 一个 BEV 格子不是一个点,而是一根从地面往上延伸的柱子。论文在 m 内均匀取 个高度 (实际代码取的是 m 左右的格点),得到 4 个 3D 参考点 。为什么要多个高度?因为同一个 BEV 格子可能站着行人、轿车、卡车,它们在图像里的投影位置随高度变化;只取地面一个点,会把高物体的特征采偏。
第三步:投影到每个相机。 对每个相机 ,用 把 4 个 3D 点投到像素:
这里 是点在相机坐标系下的深度(不是高度), 是像素坐标。如果 且 落在图像内,这个高度就「命中」了相机 。一个 BEV 格子通常只被 1 到 2 个相机看到;相邻相机的重叠区可能同时命中 2 个。
第四步:在命中的视角上做可变形采样。 对每个命中的相机、每个高度 ,以投影像素 为参考点,用式 (1) 的 DeformAttn 在相机特征图 上采样 个点,加权求和。
第五步:对命中视角取平均。 把所有命中相机的贡献加起来,除以命中相机数:
逐项读: 是「至少有一个高度投影落在图像内且深度为正」的相机集合; 通常是 1 或 2;; 是第 个高度在第 个相机里的像素; 是第 个相机的特征图。代码里 SpatialCrossAttention 先把 query 按相机重新分组(每个相机只处理自己能看到的 query),跑完可变形注意力后再求和、除以 bev_mask 的计数,和式 (2) 一致。
下面的部件把前两步和投影画出来。拖动格子位置,或者直接点左图,看世界坐标、4 个高度锚点、它们投到当前相机里的像素,以及哪些相机命中了这个格子。
这个部件里最值得玩的是「命中」这件事。把格子拖到两个相机视场的交界处(大约 30° 方向),|V_hit| 会变成 2;拖到单个相机正前方,只剩 1。真实模型里也是这个逻辑:一个 BEV 格子通常只有 1 到 2 个相机能看见它,所以 SCA 的计算量远小于「所有 query 看所有相机」。
为什么用可变形注意力而不是全局注意力?论文在 BEVFormer-S(去掉时序的静态版本)上做了对比(表 5):
| 空间注意力 | NDS↑ | mAP↑ | mATE↓ | mAOE↓ | 参数 | FLOPs | 显存 |
|---|---|---|---|---|---|---|---|
| 全局注意力(global) | 0.404 | 0.325 | 0.837 | 0.442 | 62.1M | 1245.1G | ~36G |
| 只采样参考点(point) | 0.423 | 0.351 | 0.753 | 0.442 | 68.1M | 1264.3G | ~20G |
| 局部可变形(local,默认) | 0.448 | 0.375 | 0.725 | 0.391 | 68.7M | 1303.5G | ~20G |
全局注意力让每个 query 和所有相机的所有 token 交互,显存直接翻到 36G,NDS 反而最低——因为它没有利用「这个格子只可能出现在少数视角」的先验,学起来更难。只采样参考点(去掉偏移和权重,类似 DETR3D 的 point interaction)感受野太小,NDS 42.3。局部可变形在参考点周围采样,既保留了先验,又有一定的容错空间,NDS 44.8。这个对比是论文设计 SCA 的直接依据。
下面的部件把三种感受野画出来。点按钮切换,看一个 query 在相机特征图上到底读了多少个格子。
3.4 时序自注意力:把上一帧的 BEV 当记忆
单帧图像很难判断速度:一辆车在两张图里都出现,你知道它在哪,但不知道它下一秒去哪;被遮挡的物体在单帧里甚至完全看不到。视频里有这些信息,问题是怎么便宜地把它带进来。最直接的做法是把过去几帧的 BEV 特征堆在一起(BEVFormer-S 的 baseline 也可以这样理解),但堆叠的窗口固定、显存线性增长,而且不同帧的特征没有对齐。
BEVFormer 的做法是 RNN 式的循环:只保留上一帧的 BEV 特征 ,把它当作隐状态,和当前 query 做一次注意力,得到 。这样计算量与帧数无关,理论上可以一直往前传。公式是
其中 是按自车运动对齐到当前时刻的上一帧 BEV。对齐很重要:上一帧的自车在别的位置,同一个真实地点在两张 BEV 里的格子下标不同。设两帧之间自车平移 、旋转 ,当前格子 在上一帧里的对应位置是
实现上,代码从 can_bus 里取两帧的位移和偏航角,把上一帧 BEV 张量旋转 ,并把 TSA 的参考网格平移 (近似实现了式 (5) 的对齐)。论文式 (5) 写的是对两路输出求和,代码里用 output.mean(-1) 取平均,只差一个常数缩放。如果当前帧是第一帧,没有历史, 用当前的 复制一份代替,TSA 退化成普通的自注意力。
有一个细节值得强调:TSA 的偏移和权重是用 和 拼接后预测的(代码里 torch.cat([prev_bev, query], -1)),而不是只看 query。这样网络能同时看到「我想找什么」和「上一帧这里有什么」,消融里这比只用 query 预测高 0.4 NDS(表 8 的 #3 与 #4:51.3 vs 51.7)。
下面的部件把「对齐」画出来。拖动自车速度和横摆角速度,看上一帧的同一辆车在当前坐标系里跑到了哪里;开关运动补偿,看查询在上一帧 BEV 里采样到的窗口是否对得上。
3.5 任务头:检测与地图分割
BEV 特征 是一张 的二维特征图,所以后面可以接任何 2D 稠密头。
3D 检测头基于 Deformable DETR[10] 的 decoder。它维护 900 个 object query,每层做一次自注意力和一次可变形交叉注意力(在 BEV 特征上采样),最后一层输出 3D 框。每个框 10 个参数:尺寸 、中心 、朝向的 、速度 。回归只用 损失,分类用 focal loss;推理时保留置信度最高的 300 个框,不需要 NMS。速度是 BEV 时序特征带来的直接好处:单帧方法几乎估不准速度,BEVFormer 的 mAVE 从 0.845 降到 0.378。
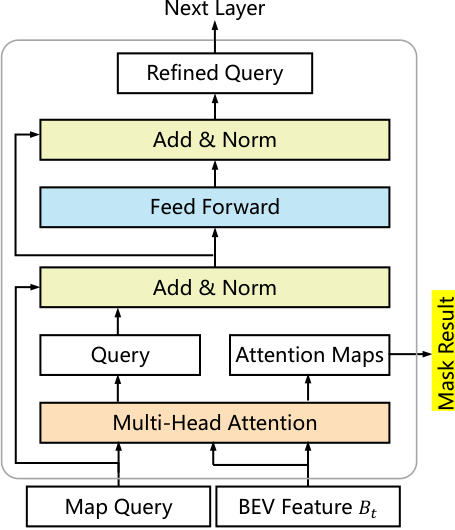
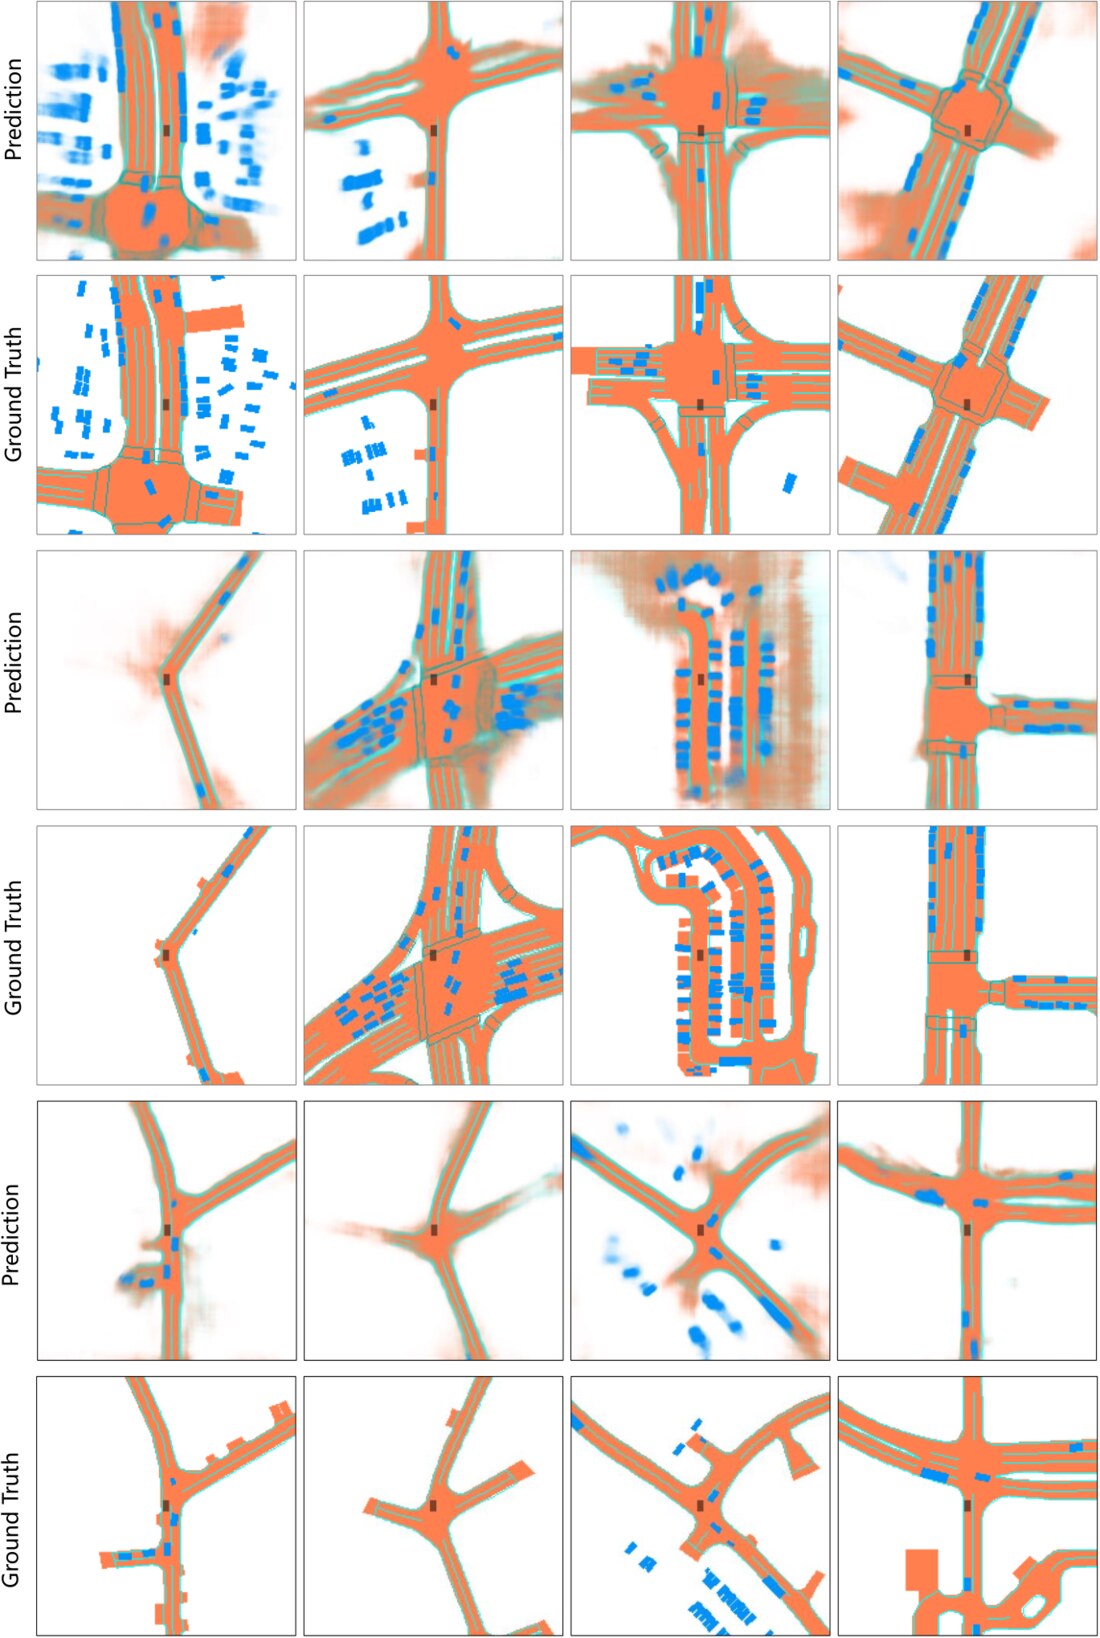
地图分割头基于 Panoptic SegFormer[11] 的 mask decoder(图 5)。每个地图类别(car、vehicles、road/drivable area、lane)有一组固定的 query,decoder 通过 mask attention 生成每个类别的二值 mask。类别之间可以重叠(人行横道是 road 的子集),所以不是多分类,而是每个类别独立分割。因为 BEV 特征本身就是稠密的,这个头几乎不用改就能接上。
下面的部件在同一张 BEV 上切换两个头:点检测框看它的 10 个回归量,或者切到分割看不同类别的 mask 怎么叠在一起。
3.6 训练与推理细节
训练。每个样本取当前时刻 ,并从过去 2 秒的连续帧里随机采样 3 帧作为历史(按时间顺序记为 ,是采样序号,不是等间隔帧),连同当前帧共 4 帧。前三帧只用来循环生成 ,不传梯度;到 帧才把 送进检测/分割头算损失。这样做相当于把时序编码器展开 4 步做截断的 BPTT,既让网络学会「怎么用历史」,又不让显存随历史长度爆炸。随机采样历史帧(而不是固定取连续帧)是一种数据增强,消融里比固定采样高 0.4 NDS(51.7 vs 51.3)。
推理。按时间顺序逐帧跑,保存上一帧的 ,用 can_bus 算两帧间的位移和偏航角,做对齐。因为只保留一帧历史,推理显存和单帧模型差不多;论文说推理速度和其他相机方法可比(但绝对值并不快,见 4.4)。
超参。24 epochs,8 张 GPU,每张 batch size 1(6 张图),AdamW,基础学习率 ,骨干网络乘 0.1,余弦退火,weight decay 。R101-DCN 用 FCOS3D 的检测权重初始化,VoVNet-99 用 DD3D 的权重初始化。
下面的部件对比训练和推理的时间线:训练时随机抽 3 帧历史、前三帧不传梯度;推理时只保留上一帧。
四、实验结果
4.1 数据集与指标
nuScenes[12]:1000 个场景,每个场景 20 秒,6 个相机覆盖 360°,关键帧 2 Hz 标注,约 140 万个 3D 框,10 个类别。检测指标是 nuScenes 的 NDS:
其中 mAP 用地面平面上的中心距离(2 m 阈值)匹配,而不是 3D IoU; 是 5 个 True Positive 指标:mATE(平移)、mASE(尺度)、mAOE(朝向)、mAVE(速度)、mAAE(属性)。每个指标越低越好,所以 NDS 越高越好。这个协议对相机方法相对友好:中心距离不要求框的尺寸和朝向完全对齐,但 mATE 仍然能反映定位精度。
Waymo[13]:798 个训练序列、202 个验证序列,5 个相机约 252° 视场,但标注是 360°;训练/验证时去掉在图像里完全看不到的框,验证集每 5 帧取一帧。用 Waymo 的 APH(IoU 0.5/0.7,LEVEL_1/2)和 nuScenes 指标两套评价。
4.2 nuScenes 3D 检测
下面的部件把表 1(test)、表 2(val)和表 4(多任务)做成交互条形图。切换数据集和指标,看 BEVFormer 在哪个指标上领先最多。
从表里能读出三件事:
- 时序是最大的增量。同样 R101 骨干,BEVFormer-S 46.2 NDS、BEVFormer 53.5,涨 7.3;换成 V2-99,49.5 → 56.9,涨 7.4。涨得最多的是 mAVE(0.925 → 0.435,0.842 → 0.378),这正是「单帧看不到速度」的直接证据。
- 相机方法已经接近 LiDAR 的入门线。BEVFormer 56.9 和 SSN 的 56.9 持平,但仍低于 PointPainting 58.1;而且 LiDAR 方法在 mATE 上通常更好(PointPainting 0.388 对 BEVFormer 0.582),说明几何定位仍是相机路线的短板。
- 骨干网络的预训练很重要。V2-99 在深度估计任务上用额外数据预训练过,BEVFormer 用 V2-99 比 R101 高 3.4 NDS;这不是架构本身的差距,比较时要注意条件。
4.3 Waymo 与多任务
Waymo 验证集(表 3,车辆类):
| 方法 | 模态 | IoU 0.5 L1 APH | IoU 0.5 L2 APH | IoU 0.7 L1 APH | IoU 0.7 L2 APH | NDS† | AP† | ATE↓ |
|---|---|---|---|---|---|---|---|---|
| PointPillars | LiDAR | 0.866 | 0.801 | 0.638 | 0.557 | 0.685 | 0.838 | 0.143 |
| DETR3D | 相机 | 0.220 | 0.216 | 0.055 | 0.051 | 0.394 | 0.388 | 0.741 |
| BEVFormer | 相机 | 0.280 | 0.241 | 0.061 | 0.052 | 0.426 | 0.440 | 0.679 |
| CaDDN* | 相机 | 0.175 | 0.165 | 0.050 | 0.045 | – | – | – |
| BEVFormer* | 相机 | 0.308 | 0.277 | 0.077 | 0.069 | – | – | – |
* 表示只用前相机、只考虑前相机视场内的标注;† 表示把 ATE/AAE 设为 1 计算的 NDS。BEVFormer 在 IoU 0.5 上比 DETR3D 高 6 个 APH,但在 IoU 0.7 上只有 0.061/0.052——相机方法在严格 IoU 下仍然很难,论文自己也说 IoU 指标对相机方法「太苛刻」,所以同时报告了 nuScenes 指标。
多任务部分(表 4)见上面的部件。BEVFormer 联合训练 52.0 NDS / 41.2 mAP,比只训检测的 51.7 / 41.6 在 NDS 上略高、mAP 略低;分割的 car/vehicles 从 BEVFormer-S 的 44.3/44.4 提到 46.8/46.7,但 road 从 80.1(单独训分割)降到 77.5、lane 从 25.7 降到 23.9。作者的结论是:检测和车辆分割有正迁移,road/lane 有负迁移。这个现象在后面的多任务工作里很常见,说明「一张 BEV 特征 + 多个头」并不是免费的。
4.4 消融:每个设计值多少
空间交叉注意力。表 5 已经说明:全局 40.4、点采样 42.3、局部可变形 44.8,显存从 36G 降到 20G。值得一提的是 global 模型为了省显存用了 fp16 和 100×100 的 BEV,所以这个对比不是严格同容量;但 point 和 local 的对比是同容量的,差距 2.5 NDS 可以归因于「围绕参考点采样」带来的感受野和容错。
时序。表 7 是训练帧数:
| #Frame | NDS↑ | mAP↑ | mAVE↓ |
|---|---|---|---|
| 1 | 0.448 | 0.375 | 0.802 |
| 2 | 0.490 | 0.388 | 0.467 |
| 3 | 0.510 | 0.410 | 0.423 |
| 4 | 0.517 | 0.416 | 0.394 |
| 5 | 0.517 | 0.412 | 0.387 |
1 帧到 4 帧,NDS 涨 6.9、mAVE 从 0.802 降到 0.394;4 帧到 5 帧,NDS 不再涨,mAVE 只降 0.007,所以默认 4 帧。这个「4 帧饱和」和训练成本、历史长度都有关系。
对齐与预测方式。表 8:
| # | A. 自车对齐 | R. 随机采样 | B. 用 Q+B 预测偏移 | NDS↑ | mAP↑ |
|---|---|---|---|---|---|
| 1 | ✗ | ✓ | ✓ | 0.510 | 0.410 |
| 2 | ✓ | ✗ | ✓ | 0.513 | 0.410 |
| 3 | ✓ | ✓ | ✗ | 0.513 | 0.404 |
| 4 | ✓ | ✓ | ✓ | 0.517 | 0.416 |
对齐(51.0 → 51.7)、随机采样(51.3 → 51.7)、用 query 和历史一起预测偏移(51.3 → 51.7)各贡献 0.4 左右。但三项全开只比全关的 #1 高 0.7(51.0 → 51.7),说明这些增益有重叠,不能简单相加。
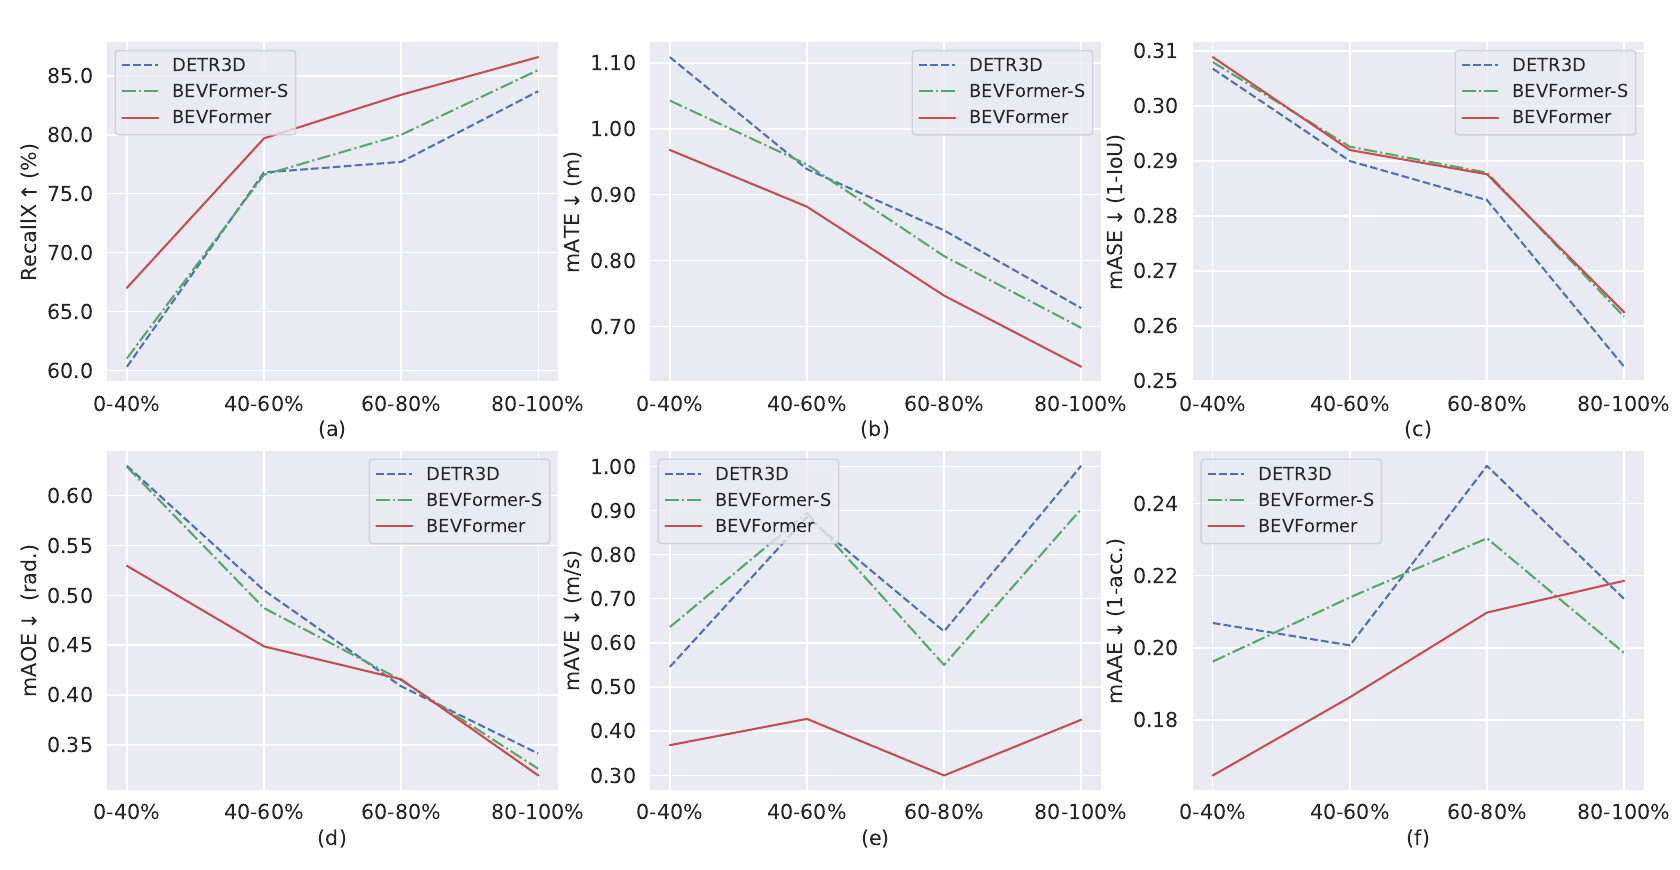
可见度。图 3 把 nuScenes val 按物体可见比例分成 0–40%、40–60%、60–80%、80–100% 四组,看每组上的召回和误差:
模型规模与延迟。表 6(V100,输入 900×1600,R101-DCN):
| 配置 | 多尺度 | BEV | 层数 | 延迟 骨干/编码器/头 (ms) | FPS | NDS↑ | mAP↑ |
|---|---|---|---|---|---|---|---|
| 默认 | ✓ | 200×200 | 6 | 391 / 130 / 19 | 1.7 | 0.517 | 0.416 |
| A | ✗ | 200×200 | 6 | 387 / 87 / 19 | 1.9 | 0.511 | 0.406 |
| B | ✓ | 100×100 | 6 | 391 / 53 / 18 | 2.0 | 0.504 | 0.402 |
| C | ✓ | 200×200 | 1 | 391 / 25 / 19 | 2.1 | 0.501 | 0.396 |
| D | ✗ | 100×100 | 1 | 387 / 7 / 18 | 2.3 | 0.478 | 0.374 |
这张表最重要的信息不是「BEVFormer 快」,而是骨干网络才是瓶颈:默认配置里 391 ms 在骨干,BEV 编码器只有 130 ms。把编码器从 6 层压到 1 层,BEV 部分从 130 ms 降到 25 ms,NDS 只掉 1.6;把 BEV 从 200×200 降到 100×100、层数降到 1、再去掉多尺度,BEV 编码器只要 7 ms,NDS 掉 3.9。所以如果要做实时部署,先想清楚骨干怎么换,而不是只盯着 BEV 编码器。
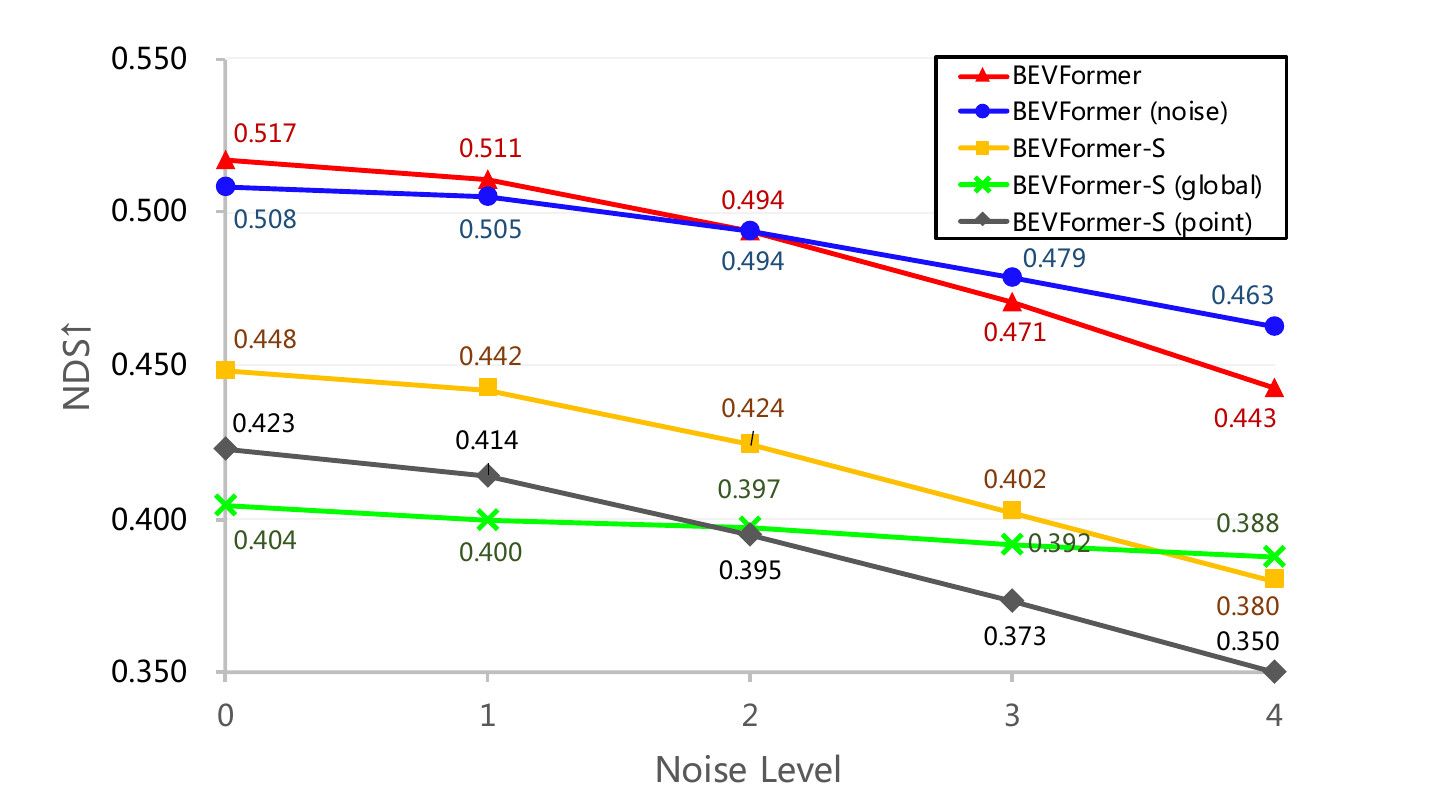
相机外参鲁棒性。图 6 给相机外参加噪声:第 级噪声的旋转标准差是 度、平移标准差是 厘米。4 级噪声下,BEVFormer-S(可变形)掉 15.2%,BEVFormer 掉 14.3%,只采参考点的 BEVFormer-S (point) 掉 17.3%;全局注意力版本只掉 4.0%(40.4 → 38.8),因为它根本不用外参选 ROI,但它的干净 NDS 本来就最低,属于「稳但弱」。用噪声外参训练(BEVFormer (noise))可以把掉点压到 8.9%,说明数据增强是有效的。
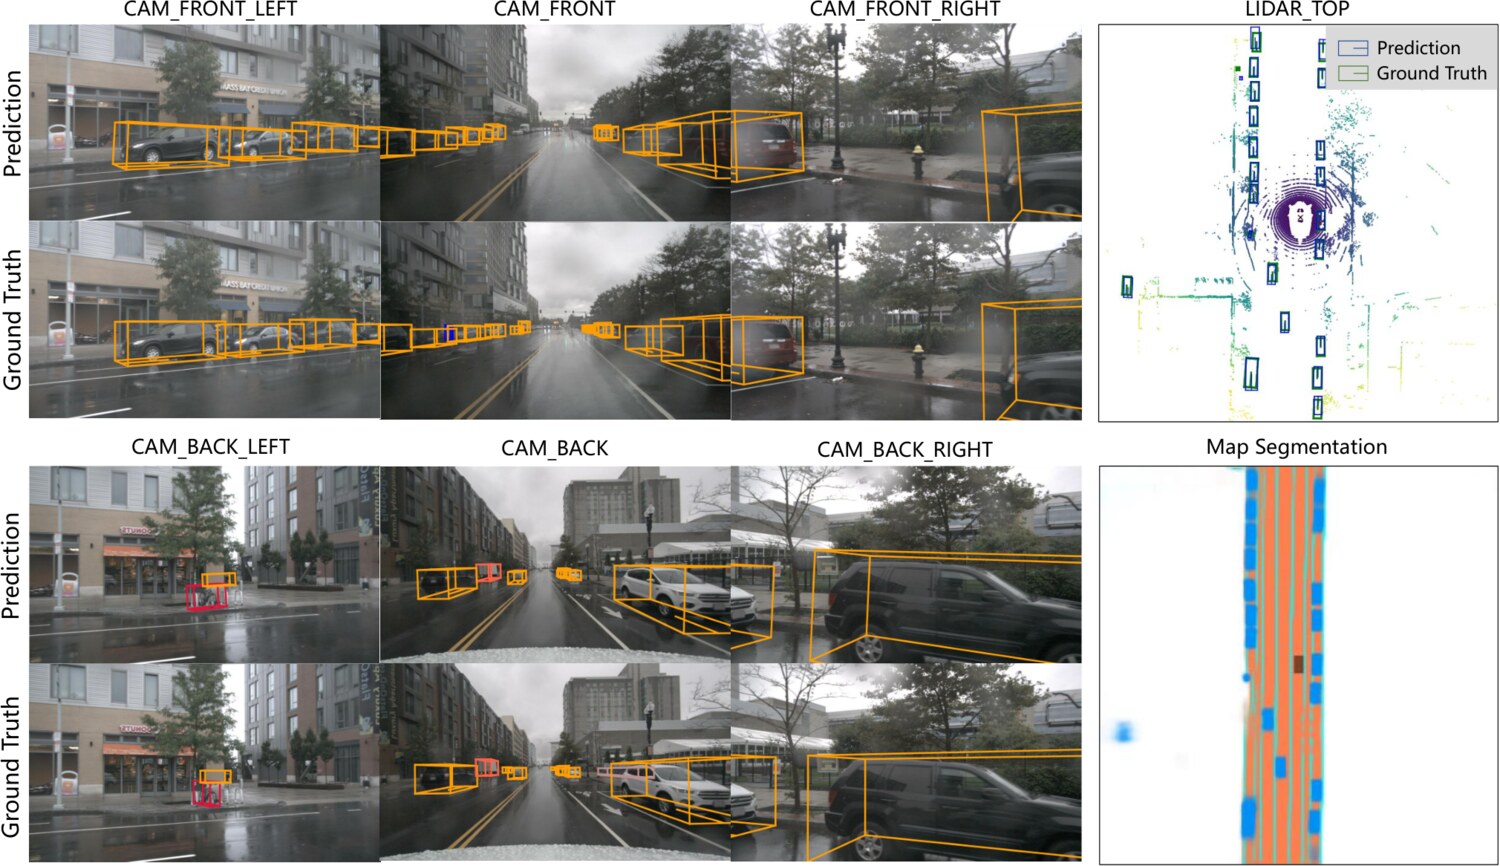
4.5 定性结果
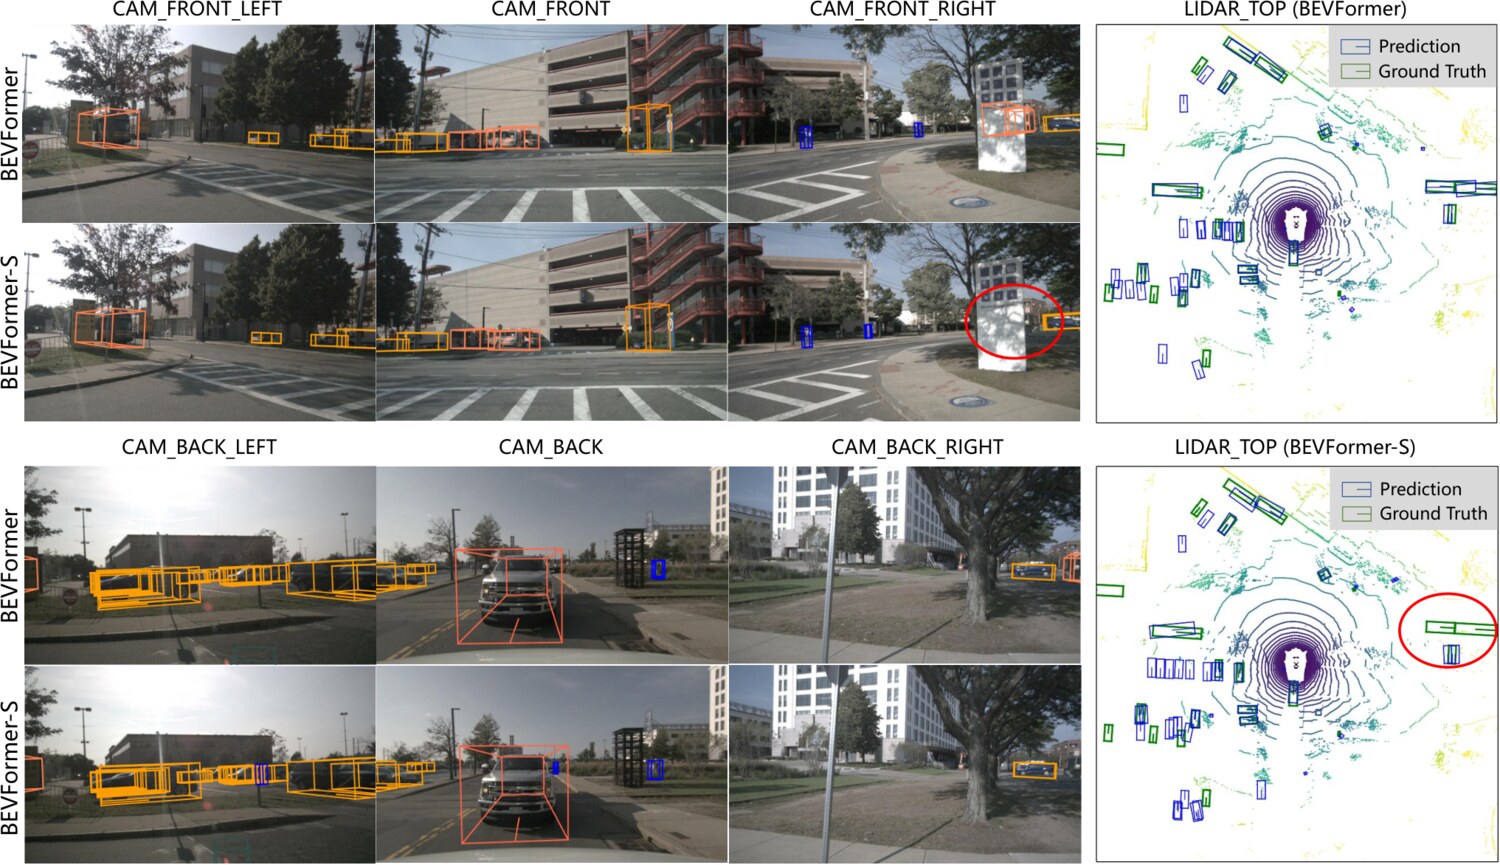
五、局限性
5.1 论文承认的
论文在讨论部分只写了一条:相机方法和 LiDAR 方法在效果和效率上仍有差距,从 2D 图像精确推断 3D 位置是一个长期难题。 这句话很克制,也确实概括了 BEVFormer 的边界:它解决了「表示」的问题,但没有解决「深度」的问题。
5.2 我自己再补几条
-
它没有完全摆脱几何。「不预测深度」不等于「不用几何」:SCA 的参考点、命中 mask 全都依赖标定好的内参和外参。外参噪声实验说明,标定误差会直接掉点(4 级噪声下 BEVFormer 掉 14.3%,BEVFormer-S 掉 15.2%);
can_bus的位移/偏航角如果噪声大,时序对齐也会受影响。真正「无标定」的 BEV 方法不在本文范围内。 -
算力和显存都不便宜。基础模型 28.5 GB 训练显存、1.7 FPS(V100)推理;骨干占 391 ms,编码器 130 ms。论文的「7 ms」是配置 D(100×100、1 层、单尺度、R101-DCN)的 BEV 编码器时间;「2.3 FPS」是同一配置完整模型的吞吐。两者都不是默认配置的端到端实时性。拿 BEVFormer 做产品要先解决骨干和 BEV 分辨率的取舍。
-
BEV 网格是固定的。200×200、0.512 m、±51.2 m 是一个硬先验:超出范围的物体、极远处的小目标、细长的 lane 都会被分辨率限制。地图分割 lane IoU 只有 25.7 也说明这一点。柱子的 4 个高度是粗离散(-5 到 3 m),对很高的卡车或很低的障碍物不是最优。
-
时序只补偿自车运动。对齐用的是
can_bus的刚体变换,运动物体的历史位置还要靠网络自己学;推理只保留一帧历史,长时序的误差累积、遮挡恢复的极限没有系统分析。训练用 4 帧、推理用 1 帧历史,是一种截断近似。 -
分割代码和权重没有随检测一起发布。官方 README 的 Catalog 把「BEV Segmentation checkpoints/code」列为待办,模型 zoo 里只有检测权重。表 4 的分割结果可以复现思路,但不能直接拿官方权重跑;做分割要自己训头。这一点对复现很重要。
-
时代变了。BEVFormer 是 2022 年的 SOTA,之后的 BEVFormer v2[14]、BEVDepth[15]、StreamPETR 等工作在精度、速度或监督信号上各有改进,很多已经超过它。今天把 BEVFormer 当「强 baseline / 教学架构」是合适的,当「最强方法」就不合适了。
-
消融的公平性有小瑕疵。表 5 的 global 版本为了省显存用了 fp16 和 100×100,和 local 不是同容量;表 6 的延迟是在 V100 上、不包含后处理;这些数字看趋势可以,做严格对比要自己重跑。
六、结论与展望
6.1 一句话总结
BEVFormer 的核心不是「又用了一个 Transformer」,而是把 BEV 当成一组可学习的问题:几何告诉你每个问题该去图像里的哪个位置找答案,注意力决定从周围取哪些特征,时序注意力再把上一帧的答案当成记忆。三件事合起来,得到了一张不依赖深度估计、支持检测和分割、还能利用视频的 BEV 特征图。
6.2 给实践者的建议
- 先跑 base,再谈优化:
bevformer_base.py(R101-DCN,200×200,51.7 NDS)是论文的主配置;显存约 28.5 GB,建议 32 GB 以上的卡。想快速看效果可以用bevformer_tiny.py(R50,50×50,35.4 NDS,6.5 GB)。 - 预训练权重别省:R101-DCN 用 FCOS3D 的检测权重初始化,V2-99 用 DD3D 的权重;从头训 24 epoch 很难达到论文数字。
- 时序对齐依赖
can_bus:数据准备时一定要解压can_bus.zip并放到data/can_bus/,否则create_data.py生成的时序 pkl 不完整;推理时video_test_mode和prev_bev的维护要按simple_test的流程来。 - 评测用 1 张 GPU 可能更高:官方文档说多 GPU 评测会截断连续视频,1 GPU 评测的分数略高;论文默认报 8 GPU 的分数。
- 要做分割,准备自己训头:官方检测权重可以复用骨干和 BEV 编码器,但分割头和权重没有发布,需要按表 4 的协议自己训。
6.3 后续工作
BEVFormer 开启的路线后来分成了几条:
- 更好的监督:BEVFormer v2[14] 在图像空间加透视 3D 头做辅助监督,让现代骨干(InternImage 等)也能训 BEV;BEVDepth[15] 用 LiDAR 深度显式监督 LSS 式的深度分布。两条路分别从「监督信号」和「深度质量」补 BEVFormer 的短板。
- 更强的时序:StreamPETR 等把时序做成流式 query 传播,不再只保留一帧 BEV;BEVFormer v2 也重新设计了时序编码器。
- 多传感器与占用:BEVFusion 把相机 BEV 和 LiDAR BEV 拼在一起;Occupancy 系列把 BEV 扩展到三维体素,回答「每个体素是否被占据」,比 BEV 更接近真正的 3D 场景。
- 效率和部署:BEV 分辨率、骨干、可变形注意力的 CUDA 实现都是瓶颈;后续的 BEVDet 等工作在这一块做了很多工程优化。
如果用一句话给 BEVFormer 定位:它是「相机 BEV 感知」从深度估计范式转向注意力范式的那篇论文,后面的很多工作都可以看成在这张 BEV 特征图上继续加监督、加时序、加模态。
七、上手
7.1 安装
官方安装文档给的是 2022 年的老栈,版本要严格对上(Python 3.8 / torch 1.9.1+cu111 / mmcv-full 1.4.0 / mmdet 2.14.0 / mmseg 0.14.1 / mmdet3d v0.17.1):
安装命令(Python 3.8 + CUDA 11.1 旧栈)
conda create -n open-mmlab python=3.8 -y
conda activate open-mmlab
pip install torch==1.9.1+cu111 torchvision==0.10.1+cu111 \
  torchaudio==0.9.1 \
  -f https://download.pytorch.org/whl/torch_stable.html
pip install mmcv-full==1.4.0
pip install mmdet==2.14.0
pip install mmsegmentation==0.14.1

git clone https://github.com/open-mmlab/mmdetection3d.git
cd mmdetection3d
git checkout v0.17.1
python setup.py install
cd ..

pip install einops fvcore seaborn iopath==0.1.9 timm==0.6.13 \
  typing-extensions==4.5.0 pylint ipython==8.12 numpy==1.19.5 \
  matplotlib==3.5.2 numba==0.48.0 pandas==1.4.4 \
  scikit-image==0.19.3 setuptools==59.5.0
python -m pip install \
  'git+https://github.com/facebookresearch/detectron2.git'

git clone https://github.com/fundamentalvision/BEVFormer.git
cd BEVFormer && mkdir ckpts && cd ckpts
ckpt=https://github.com/zhiqi-li/storage/releases/download/v1.0
wget $ckpt/r101_dcn_fcos3d_pretrain.pth
这套依赖对 CUDA 版本很敏感;如果要在新卡(如 4090)上跑,通常需要自己升 torch/mmcv,并重新编译可变形注意力的 CUDA 算子,不能直接照抄。
7.2 数据
从 nuScenes 官网下载完整的 v1.0 数据集和 CAN bus 扩展包,解压 can_bus.zip 到 data/can_bus/,然后:
生成数据索引(create_data.py)
python tools/create_data.py nuscenes \
  --root-path ./data/nuscenes \
  --out-dir ./data/nuscenes \
  --extra-tag nuscenes \
  --version v1.0 \
  --canbus ./data
会生成 nuscenes_infos_temporal_train.pkl 和 nuscenes_infos_temporal_val.pkl。目录结构是 data/nuscenes/{maps,samples,sweeps,v1.0-trainval,v1.0-test} 加上这两个 pkl。
7.3 权重、训练与评测
| 规模 | 骨干 | NDS | mAP | 显存 | 权重 |
|---|---|---|---|---|---|
| tiny | R50 | 35.4 | 25.2 | 6500M | bevformer_tiny_epoch_24.pth |
| tiny_fp16 | R50 | 35.9 | 25.7 | – | bevformer_tiny_fp16_epoch_24.pth |
| small | R101 | 47.9 | 37.0 | 10500M | bevformer_small_epoch_24.pth |
| base | R101 | 51.7 | 41.6 | 28500M | bevformer_r101_dcn_24ep.pth |
表中 small / base 的 R101 骨干带可变形卷积(DCN)。权重都在 zhiqi-li/storage 的 v1.0 release 下。训练和评测命令(8 卡):
训练与评测命令(8 卡)
# 训练 base
./tools/dist_train.sh \
  ./projects/configs/bevformer/bevformer_base.py 8

# FP16 训练 tiny(普通训练脚本不支持 FP16)
./tools/fp16/dist_train.sh \
  ./projects/configs/bevformer_fp16/bevformer_tiny_fp16.py 8

# 评测
./tools/dist_test.sh \
  ./projects/configs/bevformer/bevformer_base.py \
  ./ckpts/bevformer_r101_dcn_24ep.pth 8
可视化用 tools/analysis_tools/visual.py。如果想先跑 BEVFormer v2,配置在 projects/configs/bevformerv2/,权重和 log 在 README 里有链接(部分在 Google Drive/Baidu 网盘)。
7.4 配置与论文概念的对应
| 配置项 | 论文概念 | 默认值(base) |
|---|---|---|
bev_h_, bev_w_ | BEV 网格 | 200, 200 |
point_cloud_range | BEV 覆盖范围(含高度) | [-51.2, -51.2, -5.0, 51.2, 51.2, 3.0] |
num_points_in_pillar | 柱子上的高度锚点数 | 4 |
queue_length | 训练时每个序列的帧数 | 4 |
num_layers | 编码器层数 | 6 |
num_points(SpatialCrossAttention) | 每个参考点的采样点数 | 8(论文写 4) |
num_levels(SpatialCrossAttention) | FPN 尺度数 | 4(论文写 3) |
video_test_mode | 推理时维护 prev_bev | True |
rotate_prev_bev, use_shift | 用 can_bus 做时序对齐 | True, True |
最后一个细节:论文正文说 SCA 每个参考点采 4 个点、FPN 用 3 个尺度(1/16、1/32、1/64),开源 base 配置里是 num_points=8、num_levels=4(FPN 多一个 1/8 尺度)。机制完全一样,数字不同;复现论文表格时以配置和权重为准,读论文时以公式为准。这种「论文 vs 代码」的小差异在 2022 年的工作里很常见,不必把它当成矛盾。
参考
- Li, Wang, Li, Xie, Sima, Lu, Qiao, Dai. BEVFormer: Learning Bird's-Eye-View Representation from Multi-Camera Images via Spatiotemporal Transformers. ECCV 2022. arXiv · 代码
- Wang, Zhu, Pang, Lin. FCOS3D: Fully Convolutional One-Stage Monocular 3D Object Detection. ICCV Workshops 2021. arXiv · 代码
- Wang, Pang, Lin. Probabilistic and Geometric Depth: Detecting Objects in Perspective. CoRL 2021. arXiv · 代码
- Park, Ambrus, Guizilini, Li, Gaidon. Is Pseudo-Lidar needed for Monocular 3D Object Detection?. ICCV 2021. arXiv · 代码
- Philion, Fidler. Lift, Splat, Shoot: Encoding Images from Arbitrary Camera Rigs by Implicitly Unprojecting to 3D. ECCV 2020. arXiv · 代码
- Pan, Sun, Leung, Andonian, Zhou. Cross-view Semantic Segmentation for Sensing Surroundings. IEEE RA-L 2020. arXiv · 代码
- Huang, Huang, Zhu, Ye, Du. BEVDet: High-performance Multi-camera 3D Object Detection in Bird-Eye-View. arXiv 2112.11790, 2021. arXiv · 代码
- Xie, Yu, Zhou, Philion, Anandkumar, Fidler, Luo, Alvarez. M²BEV: Multi-Camera Joint 3D Detection and Segmentation with Unified Bird's-Eye View Representation. arXiv 2204.05088, 2022. arXiv
- Wang, Guizilini, Zhang, Wang, Zhao, Solomon. DETR3D: 3D Object Detection from Multi-view Images via 3D-to-2D Queries. CoRL 2021. arXiv · 代码
- Zhu, Su, Lu, Li, Wang, Dai. Deformable DETR: Deformable Transformers for End-to-End Object Detection. ICLR 2021. arXiv · 代码
- Li, Wang, Xie, Yu, Anandkumar, Alvarez, Lu, Luo. Panoptic SegFormer: Delving Deeper into Panoptic Segmentation with Transformers. CVPR 2022. arXiv · 代码
- Caesar, Bankiti, Lang, Vora, Liong, Xu, Krishnan, Pan, Baldan, Beijbom. nuScenes: A Multimodal Dataset for Autonomous Driving. CVPR 2020. arXiv · 代码
- Sun, Kretzschmar, Dotiwalla, Chouard, Patnaik, Tsui, Guo, Zhou, Chai, Caine, et al. Scalability in Perception for Autonomous Driving: Waymo Open Dataset. CVPR 2020. arXiv · 代码
- Yang, Chen, Tian, Tao, Zhu, Zhang, Huang, Li, Qiao, Lu, Zhou, Dai. BEVFormer v2: Adapting Modern Image Backbones to Bird's-Eye-View Recognition via Perspective Supervision. CVPR 2023. arXiv · 代码
- Li, Ge, Yu, Yang, Wang, Shi, Sun, Li. BEVDepth: Acquisition of Reliable Depth for Multi-view 3D Object Detection. AAAI 2023. arXiv · 代码