· 88 min read
论文解读:D2-Net,一张特征图同时做描述子与检测器
TL;DR D2-Net[1] 把局部特征的两步顺序倒了过来:先用一个 VGG16 把图像变成 conv4_3 特征图,再把同一张特征图同时当作描述子(每个像素的 512 维通道向量)和检测器(每个通道是一张响应图,在通道与空间两个维度取局部极大)。它不需要关键点标注,只用 MegaDepth 的像素级对应和带软检测权重的 triplet loss 训练。结果:微调后的 D2 在 Aachen Day-Night 的 0.5m/2° 下达到 44.9%(对比 SuperPoint 42.8%、RootSIFT 36.7%),InLoc Direct PE(D2 MS)在 0.25m 下 27.7%(对比 RootSIFT 18.5%),HPatches 在 6.5px 以上阈值整体最好,三维重建与 RootSIFT / GeoDesc 持平。代码已开源,权重可下载。
- 论文:D2-Net: A Trainable CNN for Joint Description and Detection of Local Features,Mihai Dusmanu、Ignacio Rocco、Tomas Pajdla、Marc Pollefeys、Josef Sivic、Akihiko Torii、Torsten Sattler,ENS/Inria、ETH Zurich、CTU Prague、Microsoft、Tokyo Tech、Chalmers,CVPR 2019。
- 代码:github.com/mihaidusmanu/d2-net(PyTorch 实现,含训练、特征提取与权重下载)
- 前作 / 后继:SuperPoint、DISK、R2D2、LoFTR。
一、动机:检测器才是那条短腿
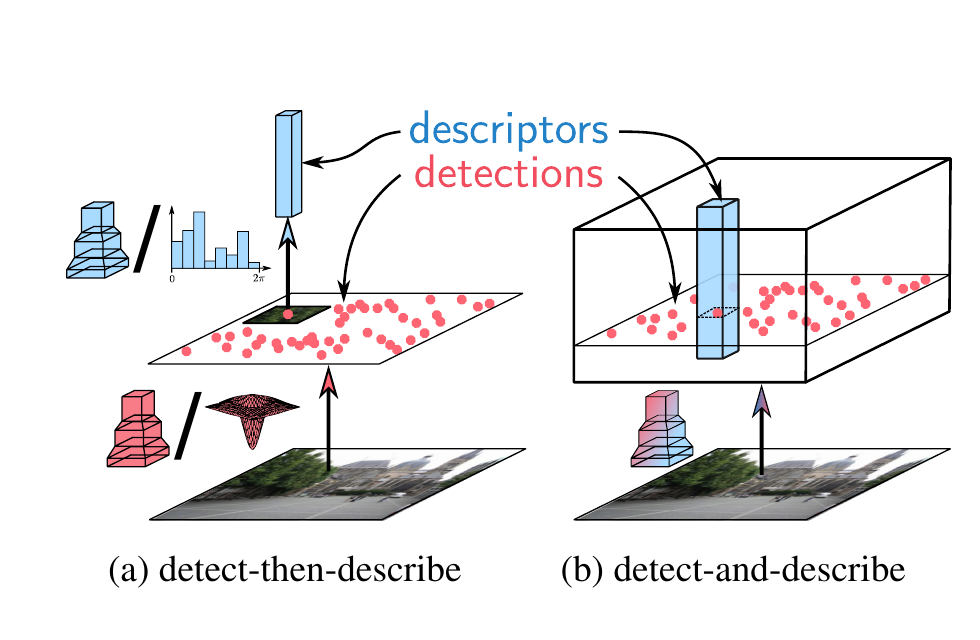
图像匹配是三维视觉的地基:SfM 要三角化,视觉定位要 2D-3D 对应,SLAM 要帧间跟踪,都先得在两张图之间找到像素级对应点。2019 年之前,这条流水线的主流写法是 detect-then-describe:先用一个检测器找关键点,再在关键点周围取 patch、算描述子。SIFT[2] 用 DoG 找斑块状结构,SURF[3] 用 Hessian 的 box filter 加速,之后还有 Harris、Hessian Affine、RootSIFT[4] 等一系列变体;LF-Net[5] 则把检测器和描述子都换成可学习的网络,但仍然是「先检测、后描述」的两段式。
这条路线有一个被长期接受的假设:检测器应该看低层信息。角点和斑块在图像里定位精确,对视角变化也相对稳定;描述子则看更大的 patch,负责编码更高层的外观。两者分工明确,SfM 的精度也建立在这个分工上。
问题在于,低层信息恰恰是最怕外观变化的东西。白天到黑夜、夏天到冬天、晴天到雨天,像素强度和局部对比度会整体改变,DoG/Harris 的响应位置随之漂移;在弱纹理的室内场景,角点本身就不存在。检测器一旦漏检,后面的描述子再好也没有机会出场。Sattler 等人的 Aachen Day-Night 基准[6] 和 Taira 等人的 InLoc 室内基准[7] 都把这件事摆到了台面上:在剧烈光照变化和弱纹理场景里,传统局部特征的定位成功率会大幅下降。
SuperPoint[8] 是这一时期最有代表性的学习式方案:一个共享编码器接两个解码头,一个出关键点热图,一个出描述子;检测头用合成形状预训练再做单应性适应,描述头用正负样本的对比损失,两个损失分别优化。它已经证明「检测和描述共享卷积特征」可行,但两者仍是独立的头、独立的损失、独立的监督——检测头只关心「哪里像关键点」,描述头只关心「描述子像不像」。D2-Net 的出发点是:如果描述子本身就能告诉你哪里值得检测,为什么还要一个独立的检测头?
另一条路是稠密描述:不做检测,直接在每个像素(或每个网格单元)上算 CNN 描述子,再稠密匹配。DenseSfM[6] 和 DELF[9] 都走了这条路:前者把稠密匹配直接用在定位上,在 Aachen Day-Night 上证明了它的鲁棒性,代价是更高的内存和计算;后者用注意力在稠密描述子上选少量关键点,但它是为图像检索设计的,不是为了给 SfM 提供可三角化的稀疏特征。
D2-Net 想取两者的中间态:保留稀疏特征的存储和匹配效率,但把检测推迟到描述之后。它先算一张 CNN 特征图,再把这张图的每个像素向量当作描述子,把每个通道当作一张检测响应图;检测器不是另一个网络头,而是描述子特征图自身的局部极大值。论文把这种顺序称为 describe-and-detect。
这个顺序是反直觉的。传统上,检测要早做,因为低层结构的定位准;等到高层特征再检测,位置会变粗。D2-Net 接受了这个代价:它的关键点确实不如 SIFT 精确,在 HPatches 的严格阈值下也不如 detect-then-describe 方法;但在外观剧烈变化时,它检测到的是「描述子局部独特」的位置,而不是「低层角点」的位置,因而更稳。论文的贡献可以概括为四条:
- 提出 describe-and-detect:一个 CNN、一张特征图,同时承担描述和检测,不需要单独的关键点检测器;
- 设计了一个联合损失:在 triplet margin ranking loss 上乘以软检测得分,让检测和描述在同一个目标里优化;
- 不需要关键点标注,只用 MegaDepth[10] 的像素级对应训练;
- 在 Aachen Day-Night 和 InLoc 上取得当时最好的稀疏特征结果,在 HPatches 和三维重建上与 SOTA 持平。
还有一条同样重要、但更像实验观察的事实:不微调也能用。直接用 ImageNet 预训练的 VGG16 conv4_3,配上这套检测规则,Aachen 0.5m/2° 已经有 41.8%(单尺度)和 43.9%(多尺度),微调后是 44.9%。也就是说,大部分收益来自「把检测定义在描述特征上」这件事本身,而不是靠大规模关键点监督。
二、核心方法
2.1 一张特征图,两种读法
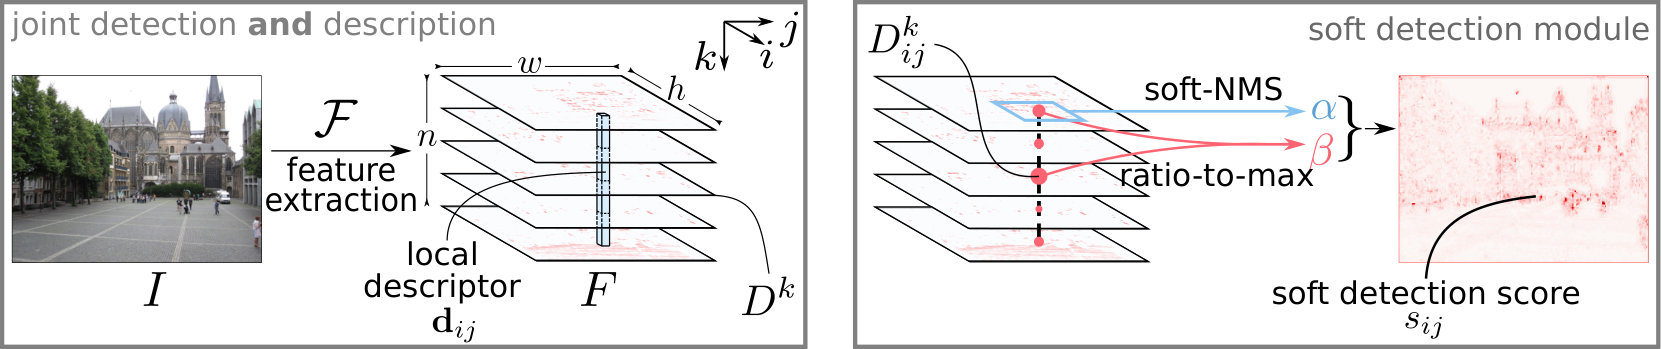
设输入图像为 ,特征提取网络为 ,输出一个三维张量
其中 是特征图的空间分辨率, 是通道数。D2-Net 用的是 VGG16 的 conv4_3,所以 ;训练时特征图是输入的 分辨率(256×256 的 crop 得到 32×32),测试时通过膨胀卷积提高到 (1200×1600 的图得到 300×400)。
关键就在于,这同一个张量可以有两种读法:
- 按通道读:固定空间位置 ,取出 维向量 ,它就是该像素的描述子;比较两张图的描述子,就是比较这些向量。实际使用前做 L2 归一化,。
- 按空间读:固定通道 ,取出二维响应图 ,它就是这个通道对应的「检测器」响应; 个通道就是 张检测图,每张图都可以独立地产生检测。
论文把 类比于 SIFT 的 DoG 响应图或 Harris 的角点响应图:它们都是二维的「这里像不像一个特征点」的分数。区别在于,D2-Net 有 512 张这样的响应图,而且这些响应图和描述子来自同一组卷积权重。没有单独的检测头,没有单独的检测损失,也没有关键点热图监督。
官方代码里,特征提取部分就是「VGG16 截到 conv4_3,冻结全部参数,只放开最后一层」:
代码:特征提取主干(官方 lib/model.py,原文照录)
class DenseFeatureExtractionModule(nn.Module):
    def __init__(self, finetune_feature_extraction=False, use_cuda=True):
        super(DenseFeatureExtractionModule, self).__init__()

        model = models.vgg16()
        vgg16_layers = [
            'conv1_1', 'relu1_1', 'conv1_2', 'relu1_2',
            'pool1',
            'conv2_1', 'relu2_1', 'conv2_2', 'relu2_2',
            'pool2',
            'conv3_1', 'relu3_1', 'conv3_2', 'relu3_2', 'conv3_3', 'relu3_3',
            'pool3',
            'conv4_1', 'relu4_1', 'conv4_2', 'relu4_2', 'conv4_3', 'relu4_3',
            'pool4',
            'conv5_1', 'relu5_1', 'conv5_2', 'relu5_2', 'conv5_3', 'relu5_3',
            'pool5'
        ]
        conv4_3_idx = vgg16_layers.index('conv4_3')

        self.model = nn.Sequential(
            *list(model.features.children())[: conv4_3_idx + 1]
        )

        self.num_channels = 512

        # Fix forward parameters
        for param in self.model.parameters():
            param.requires_grad = False
        if finetune_feature_extraction:
            # Unlock conv4_3
            for param in list(self.model.parameters())[-2 :]:
                param.requires_grad = True

        if use_cuda:
            self.model = self.model.cuda()

    def forward(self, batch):
        output = self.model(batch)
return output这里有一个容易忽略的实现细节:vgg16_layers 列表在 conv4_3 之后还有 relu4_3,但 conv4_3_idx + 1 的切片到 conv4_3 就停了,所以主干输出的是 ReLU 之前的 conv4_3。检测模块在内部自己做了 F.relu(batch),而描述子用的是未过 ReLU 的特征。测试模型(lib/model_test.py)则相反:显式写出的卷积栈最后是 conv4_3,forward 里再按 use_relu 决定是否过 ReLU。论文附录 B 专门解释了这一点:ReLU 对 off-the-shelf 描述子伤害明显,对微调后的描述子影响不大,所以论文报告 off-the-shelf 结果时不用 ReLU,报告微调结果时用 ReLU。这个细节在复现时很容易踩坑。
2.2 硬检测:先在通道维竞争,再在空间维做 NMS
有了 张响应图,检测规则要回答两个问题:在哪个通道上检测,以及在什么空间范围内算局部极大。
论文的定义很简洁。对像素 ,先选出响应最大的通道
然后要求它在 上是一个局部极大值:
直观上,这相当于两层非极大值抑制:通道维用 argmax 选出「这个像素最像哪种特征」,空间维用局部极大值抑制掉邻域里的重复响应。和 SIFT 只有一张 DoG 响应图不同,这里每张 都是一个独立的检测器,一个像素可以在某个通道上很突出、在另一个通道上很平淡;只在最突出的那个通道上比较,才不会被通道之间的响应尺度差异干扰。
硬检测的输出是一个二值掩码:每个通道上,同时满足「该通道是通道最大」和「该通道在空间邻域内是局部最大」的位置被保留。官方实现还加了两件论文正文没展开的事:
- 边缘剔除:用 Hessian 矩阵的行列式和迹,把「一个方向响应强、另一个方向弱」的边缘响应去掉,阈值
edge_threshold=5。这是 SIFT 里常见的做法,目的是让检测点落在角点/斑块上,而不是长边缘上。 - 亚像素精化:在特征图层面上用 SIFT 的二次拟合求位移,再把描述子双线性插值到精化后的位置。论文 4.3 节提到「following the approach used in SIFT」,代码里的
HandcraftedLocalizationModule就是这件事。
代码:硬检测与空间 NMS(官方 lib/model_test.py,原文照录)
class HardDetectionModule(nn.Module):
    def __init__(self, edge_threshold=5):
        super(HardDetectionModule, self).__init__()

        self.edge_threshold = edge_threshold

        self.dii_filter = torch.tensor(
            [[0, 1., 0], [0, -2., 0], [0, 1., 0]]
        ).view(1, 1, 3, 3)
        self.dij_filter = 0.25 * torch.tensor(
            [[1., 0, -1.], [0, 0., 0], [-1., 0, 1.]]
        ).view(1, 1, 3, 3)
        self.djj_filter = torch.tensor(
            [[0, 0, 0], [1., -2., 1.], [0, 0, 0]]
        ).view(1, 1, 3, 3)

    def forward(self, batch):
        b, c, h, w = batch.size()
        device = batch.device

        depth_wise_max = torch.max(batch, dim=1)[0]
        is_depth_wise_max = (batch == depth_wise_max)
        del depth_wise_max

        local_max = F.max_pool2d(batch, 3, stride=1, padding=1)
        is_local_max = (batch == local_max)
        del local_max

        dii = F.conv2d(
            batch.view(-1, 1, h, w), self.dii_filter.to(device), padding=1
        ).view(b, c, h, w)
        dij = F.conv2d(
            batch.view(-1, 1, h, w), self.dij_filter.to(device), padding=1
        ).view(b, c, h, w)
        djj = F.conv2d(
            batch.view(-1, 1, h, w), self.djj_filter.to(device), padding=1
        ).view(b, c, h, w)

        det = dii * djj - dij * dij
        tr = dii + djj
        del dii, dij, djj

        threshold = (self.edge_threshold + 1) ** 2 / self.edge_threshold
        is_not_edge = torch.min(tr * tr / det <= threshold, det > 0)

        detected = torch.min(
            is_depth_wise_max,
            torch.min(is_local_max, is_not_edge)
        )
        del is_depth_wise_max, is_local_max, is_not_edge

return detected这段代码里,depth_wise_max / is_depth_wise_max 对应公式 (3) 的通道选择,F.max_pool2d(batch, 3, stride=1, padding=1) / is_local_max 对应空间局部极大,最后的 torch.min 把三个布尔条件取交集。注意它是逐通道返回掩码的:如果两个通道在同一像素上并列最大,这个像素可能在两个通道里都被保留;论文的公式写成「先选一个 」是更理想化的表述,实际代码允许并列。
硬检测没有阈值。它只回答「这个像素是不是它所在通道的局部极大」,不回答「这个检测有多强」。这带来一个实际问题:一张纹理丰富的图可能产生很多检测,一张平坦的图可能一个都没有;你没法用一个统一的分数阈值去控制关键点数量。软检测就是为了给「强弱」一个可微的度量。
2.3 软检测:把 argmax 和 max-pool 换成可微的近似
训练时不能用硬检测,因为 argmax 和 max-pool 都不可导。D2-Net 的做法是分别软化两个维度,再把它们乘起来。
空间维的软化:对每个通道 ,在像素 的 9 邻域 上做 softmax,
这就是「软局部极大」:如果 是邻域里的最大值, 接近 1;如果它只是平坦区域里的普通值, 接近 。它相当于把 max-pool 换成了 softmax-pool,保留了「局部竞争」的含义,同时对响应值可导。
通道维的软化:对每个像素,用当前通道响应除以所有通道的最大响应,
这就是 ratio-to-max:最大通道的 ,其他通道按比例缩小。它相当于把通道 argmax 换成了一个线性的「相对优势」;分母是逐像素的最大响应,所以不同像素的通道比较是独立的,不会像全局 softmax 那样被某个整体偏大的通道压住。
合并:对每个像素,取两个分数的乘积在所有通道上的最大值,
再做一次全图归一化,得到软检测得分
为什么是乘积而不是相加或取平均?因为两个条件缺一不可:只有 大,说明它在某个通道的邻域里突出,但可能不是该像素最突出的通道;只有 大,说明它是通道最大,但可能在空间上不是局部极大(比如一条长边缘上的每个点都是通道最大)。乘积把「空间局部性」和「通道选择性」绑在一起, 则保证每个像素只被它最自信的那个检测器打分。
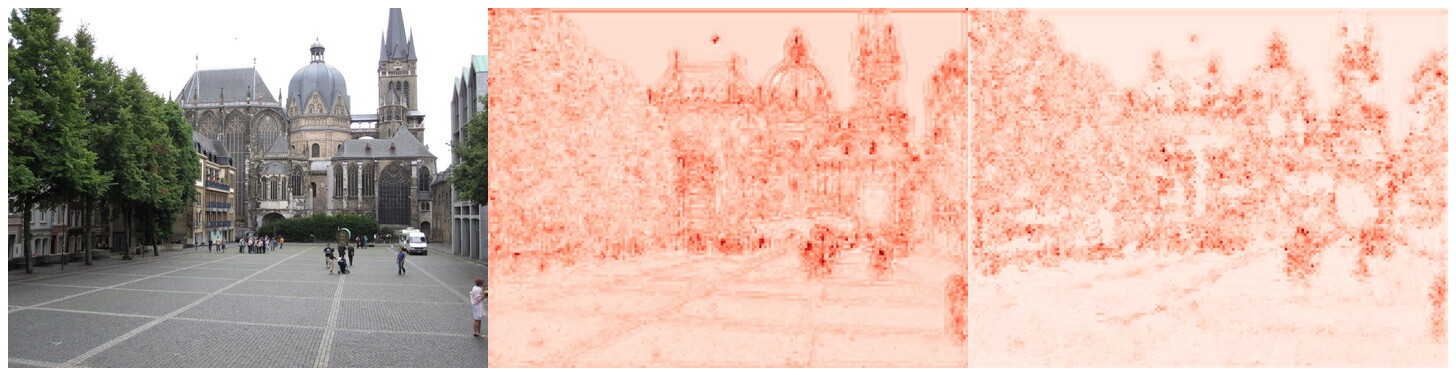
全图归一化让 成为一张概率分布:所有像素的得分加起来是 1。这个设计是为损失服务的—— 将作为每个对应点的权重,权重需要有一个统一的尺度。但它也意味着 是图内相对的:一张纹理丰富的图和一张平坦的图,最高分可能差很多,绝对阈值不能跨图比较。推理时用的是硬检测,不依赖这个阈值,所以这个问题主要影响训练权重和可视化。
下面这个部件把软/硬检测拆开给你看。左边四张是同一张玩具特征图的四个通道 ;下排左边是软得分 ,右边是每个像素的 argmax 通道 。拖动窗口半径和阈值,切换硬检测/软得分,看检测点怎么变。
这个玩具特征图不是真实网络输出,而是手工构造的:四个高斯峰分别落在不同通道,另有一组竖条纹落在通道 3。它想演示的是两个维度的竞争关系,不是真实 VGG 响应的分布。你可以注意两件事:第一,硬检测的点数和窗口大小强相关,窗口从 3×3 变成 7×7,点数会明显下降;第二,软得分是连续的,阈值低的时候几乎所有像素都有非零分数,阈值高的时候只剩几个尖峰。真实网络里,这两个维度都是 512 个通道、1/4 分辨率,计算量比这个 11×11 的玩具有几个数量级的差距,但机制是一样的。
代码:软检测模块(官方 lib/model.py,原文照录)
class SoftDetectionModule(nn.Module):
    def __init__(self, soft_local_max_size=3):
        super(SoftDetectionModule, self).__init__()

        self.soft_local_max_size = soft_local_max_size

        self.pad = self.soft_local_max_size // 2

    def forward(self, batch):
        b = batch.size(0)

        batch = F.relu(batch)

        max_per_sample = torch.max(batch.view(b, -1), dim=1)[0]
        exp = torch.exp(batch / max_per_sample.view(b, 1, 1, 1))
        sum_exp = (
            self.soft_local_max_size ** 2 *
            F.avg_pool2d(
                F.pad(exp, [self.pad] * 4, mode='constant', value=1.),
                self.soft_local_max_size, stride=1
            )
        )
        local_max_score = exp / sum_exp

        depth_wise_max = torch.max(batch, dim=1)[0]
        depth_wise_max_score = batch / depth_wise_max.unsqueeze(1)

        all_scores = local_max_score * depth_wise_max_score
        score = torch.max(all_scores, dim=1)[0]

        score = score / torch.sum(score.view(b, -1), dim=1).view(b, 1, 1)

        return score
对照公式和代码,有三处值得说明。第一,代码在取 exp 之前把响应除以了整张图的最大值 max_per_sample,而论文公式 (4) 写的是 。这一步让 exp 的输入落在 ,既防溢出,也相当于把 softmax 的温度设成了 max_per_sample——最大响应越大,分布越平。论文没有写这个温度,复现时应以代码为准。第二,sum_exp 前面乘了 soft_local_max_size ** 2,因为 avg_pool2d 算的是窗口平均,乘回去才是窗口求和;F.pad(..., value=1.) 让越界的邻居贡献 ,相当于把边界外当成零响应。第三,depth_wise_max 的分母没有加 epsilon,如果某个像素的 512 个通道全为 0, 会出现 0/0;真实 VGG 特征很少全零,但这是实现上的一个边界情况。
2.4 多尺度推理:金字塔融合与响应门控
CNN 描述子有一定的尺度鲁棒性(ImageNet 预训练时做了数据增强),但不是尺度不变的。视角变化大时,同一个点在两张图里的尺度可能差很多,单尺度匹配会失败。D2-Net 在测试时构造一个三层图像金字塔:
分别对应半分辨率、原分辨率、二倍分辨率。注意这里的 是图像的缩放因子, 表示把图像放大两倍再送进网络,得到更细的特征图,计算量也更大。
对每个尺度提取特征图 后,论文把粗尺度的特征图逐级加到细尺度上:
不同尺度的特征图分辨率不同,求和前用双线性插值把粗尺度图 resize 到当前尺度。这样,细尺度特征图既保留了细节,又吸收了粗尺度的高层上下文;检测在融合后的 上做。
多尺度检测还有一个问题:同一个物理特征会在多个尺度上被检测到。D2-Net 用一个响应门控(response gating)来去重:从最粗的尺度开始,记录已经检测到的位置;把这些位置用最近邻插值上采样到下一个尺度的分辨率,形成一个 banned 掩码;下一尺度落在掩码里的检测直接被忽略,剩下的检测再并入掩码,继续往细尺度传。效果上,一个特征只在它第一次被检测到的那个尺度上被保留(从粗到细),细尺度不会重复检测粗尺度已经占住的位置。
官方实现里,融合和门控就是下面这段:
代码:多尺度融合与响应门控(官方 lib/pyramid.py,原文节选)
        # Sum the feature maps.
        if previous_dense_features is not None:
            dense_features += F.interpolate(
                previous_dense_features, size=[h, w],
                mode='bilinear', align_corners=True
            )
            del previous_dense_features

        # Recover detections.
        detections = model.detection(dense_features)
        if banned is not None:
            banned = F.interpolate(banned.float(), size=[h, w]).bool()
            detections = torch.min(detections, ~banned)
            banned = torch.max(
                torch.max(detections, dim=1)[0].unsqueeze(1), banned
            )
        else:
            banned = torch.max(detections, dim=1)[0].unsqueeze(1)
        fmap_pos = torch.nonzero(detections[0].cpu()).t()
        del detections
这段代码只覆盖融合和门控;分数和尺度的处理在函数后面:每个尺度的检测得分会除以 (idx + 1),也就是粗尺度(idx=0)得满分,越细的尺度权重越低;关键点的 scale 存成 1/scale,遵循 COLMAP 的约定(scale 表示特征在原图中的相对大小,而不是图像被缩放的倍数)。这两点在复现时要和下游的 SfM/定位工具对齐,否则尺度字段的含义会反。
多尺度不是免费的。论文自己指出:多尺度提升了视角鲁棒性,但也引入了更多「长得像」的混淆描述子,对光照变化的鲁棒性反而可能下降。HPatches 上,D2 MS 比 D2 SS 多检测了约 60% 的特征(4.9K vs 3.0K),匹配数从 1.2K 涨到 1.7K;Aachen 上,off-the-shelf 的 MS 比 SS 在 0.5m/2° 下高 2.1 个点(43.9 vs 41.8),但微调后的 MS 在 1m/5° 下反而比 SS 低 2 个点(64.3 vs 66.3)。所以「多尺度一定更好」是错的,要看场景和阈值。
2.5 训练:像素级对应 + 带检测权重的 triplet loss
D2-Net 不需要关键点标注。它的检测器就是特征图自身的局部极大,所以监督信号只需要告诉网络「哪两个像素是同一个 3D 点」,网络自己会学出在哪里检测。训练数据来自 MegaDepth[10]:196 个场景、1,070,468 张互联网照片,其中 102,681 张有 COLMAP SfM 和 MVS 深度。论文的对应点生成流程是:
- 取所有重叠度至少 50% 的图像对;
- 把第二张图里有深度值的点投影到第一张图;
- 用第一张图的深度图做深度检查,去掉被遮挡的像素;
- 最终得到 327,036 个图像对;其中 18,149 对来自 78 个场景,作为验证集;剩下的 118 个场景用于训练。
这套流程的关键是像素级:不是「这张图里的关键点对应那张图里的关键点」,而是「这个像素对应那个像素」。因此,网络可以学到任意位置的描述子,而不只是标注过的关键点位置;检测器则通过损失里的得分权重,自己决定哪些位置值得被检测。
损失函数是 triplet margin ranking loss 的扩展。给定一对图 和一个对应 ,正样本距离是
负样本距离取两个方向里更难的那个:
其中 是 里离 的描述子最近的「困难负样本」, 是 里离 的描述子最近的困难负样本。
注意距离是平方的:描述子做了 L2 归一化,所以 ,代码里直接用这个形式算平方距离,避免了开方。
困难负样本怎么选:如果直接在整张图里找最近邻,最近的那个往往就是真值旁边的像素——它们属于同一个 3D 点,描述子本来就应该很像。把它当负样本,等于逼网络把真值推开,是假负样本。所以论文加了一个安全半径 :
同理。 是特征图上的 Chebyshev 距离;论文取 ,因为在 conv4_3 这一层,一个像素的感受野大约是输入图的 65×65,特征图上距离不超过 4 个像素的邻居,感受野重叠仍可能超过 50%,仍然可能是同一个 3D 点。排除它们,剩下的才是真正「长得像但不是一个点」的困难负样本。
margin loss 是
其中 是 margin,论文取 ;归一化描述子的平方距离最大是 4,所以这个 margin 是有意义的。
检测得分怎么进来:最终的损失是
其中 和 是对应点 、 的软检测得分。也就是说,每个对应点的 margin 项按两端的检测得分加权平均。这个加权有一个双向的效果:一方面,检测得分高的对应点在损失里占的权重大,网络会更认真地把它拉近;另一方面,为了让损失变小,网络倾向于把高分给那些 margin 小、本来就容易区分的对应点。论文的原话是:「most distinctive correspondences (with a lower margin term) will get higher relative scores and vice-versa」。检测和描述就这样被同一个目标绑在了一起,不需要额外的检测损失。
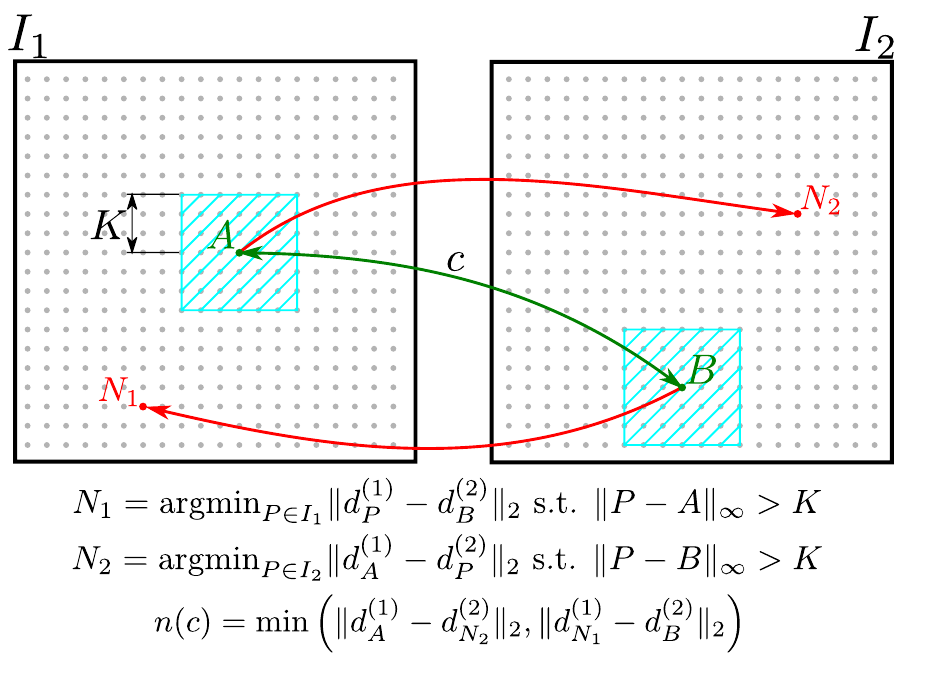
下面这个部件把 和 变成可拖的旋钮。两张 13×13 的网格代表两张图的特征图,A 和 B 是同一个 3D 点,虚线方框是安全半径;红点是当前选中的最难负样本。拖 看它怎么从「旁边的真值像素」换成「重复物体」,再拖 看 margin loss 怎么变。
这个玩具的距离模型是手写的:,同一物体邻域的描述子距离随空间距离线性增长,远处放了一个「重复物体」作为合法困难负样本。真实的 D2-Net 有 512 维描述子、整张特征图的候选负样本和真实的感受野重叠,数值不能直接对应;但 的作用——排除假负样本、保留真正的混淆点——是一样的。
代码:带检测权重的 triplet loss(官方 lib/loss.py,原文节选)
        # Descriptors at the corresponding positions
        fmap_pos2 = torch.round(
            downscale_positions(pos2, scaling_steps=scaling_steps)
        ).long()
        descriptors2 = F.normalize(
            dense_features2[:, fmap_pos2[0, :], fmap_pos2[1, :]],
            dim=0
        )
        positive_distance = 2 - 2 * (
            descriptors1.t().unsqueeze(1) @ descriptors2.t().unsqueeze(2)
        ).squeeze()

        all_fmap_pos2 = grid_positions(h2, w2, device)
        position_distance = torch.max(
            torch.abs(
                fmap_pos2.unsqueeze(2).float() -
                all_fmap_pos2.unsqueeze(1)
            ),
            dim=0
        )[0]
        is_out_of_safe_radius = position_distance > safe_radius
        distance_matrix = 2 - 2 * (descriptors1.t() @ all_descriptors2)
        negative_distance2 = torch.min(
            distance_matrix + (1 - is_out_of_safe_radius.float()) * 10.,
            dim=1
        )[0]

        all_fmap_pos1 = grid_positions(h1, w1, device)
        position_distance = torch.max(
            torch.abs(
                fmap_pos1.unsqueeze(2).float() -
                all_fmap_pos1.unsqueeze(1)
            ),
            dim=0
        )[0]
        is_out_of_safe_radius = position_distance > safe_radius
        distance_matrix = 2 - 2 * (descriptors2.t() @ all_descriptors1)
        negative_distance1 = torch.min(
            distance_matrix + (1 - is_out_of_safe_radius.float()) * 10.,
            dim=1
        )[0]

        diff = positive_distance - torch.min(
            negative_distance1, negative_distance2
        )

        scores2 = scores2[fmap_pos2[0, :], fmap_pos2[1, :]]

        loss = loss + (
            torch.sum(scores1 * scores2 * F.relu(margin + diff)) /
            torch.sum(scores1 * scores2)
)代码和公式的对应关系很直接:2 - 2 * (a @ b) 就是平方 L2 距离;position_distance > safe_radius 实现 Chebyshev 安全半径;(1 - is_out_of_safe_radius.float()) * 10. 给半径内的候选加 10,让它们在 torch.min 里不可能被选中;diff 是 ,F.relu(margin + diff) 是 ;最后按 scores1 * scores2 加权平均。函数开头还有一个容易被忽略的过滤:如果一对图的有效对应少于 128 个,直接跳过,不产生梯度;如果整个 batch 都没有有效样本,抛 NoGradientError,训练循环会跳过这一步。这是为了避免对应太少的图像对把 loss 带偏。
2.6 训练与测试的网络差异
论文的训练和测试用的是同一套 VGG16 权重,但特征图分辨率不同,原因很实际:显存。
训练时用标准的 VGG16 到 conv4_3,pool3 的 stride 是 2,所以特征图是输入的 1/8;256×256 的 crop 得到 32×32 的特征图,512 个通道。这个分辨率下,soft detection 的 exp、avg_pool 和 loss 里的距离矩阵都能放进显存。
测试时,pool3 从 MaxPool2d(2, stride=2) 换成 AvgPool2d(2, stride=1),特征图分辨率变成 1/4;后面的 conv4_1、conv4_2、conv4_3 换成 dilation=2 的膨胀卷积,保持感受野不变。这样 1200×1600 的图得到 300×400 的特征图,关键点更密、定位更细。论文附录 B 的 Table 3/4 把这两套结构逐层列了出来;官方代码里测试主干是显式写死的:
代码:测试时的特征提取主干(官方 lib/model_test.py,原文照录)
class DenseFeatureExtractionModule(nn.Module):
    def __init__(self, use_relu=True, use_cuda=True):
        super(DenseFeatureExtractionModule, self).__init__()

        self.model = nn.Sequential(
            nn.Conv2d(3, 64, 3, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(64, 64, 3, padding=1),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(2, stride=2),
            nn.Conv2d(64, 128, 3, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(128, 128, 3, padding=1),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(2, stride=2),
            nn.Conv2d(128, 256, 3, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(256, 256, 3, padding=1),
            nn.ReLU(inplace=True),
            nn.Conv2d(256, 256, 3, padding=1),
            nn.ReLU(inplace=True),
            nn.AvgPool2d(2, stride=1),
            nn.Conv2d(256, 512, 3, padding=2, dilation=2),
            nn.ReLU(inplace=True),
            nn.Conv2d(512, 512, 3, padding=2, dilation=2),
            nn.ReLU(inplace=True),
            nn.Conv2d(512, 512, 3, padding=2, dilation=2),
        )
        self.num_channels = 512

        self.use_relu = use_relu

        if use_cuda:
            self.model = self.model.cuda()

    def forward(self, batch):
        output = self.model(batch)
        if self.use_relu:
            output = F.relu(output)
        return output
训练超参:50 个 epoch,Adam,初始学习率 ,每 10 个 epoch 减半;batch size 为 1;每个场景每个 epoch 随机取 100 对图;每对图取一个以对应点为中心的 256×256 随机 crop;一对图至少要有 128 个对应才参与训练。官方 PyTorch 训练的默认 epoch 数是 10,而论文是 50;README 说明这份训练代码是原 TensorFlow 训练代码的 PyTorch 实现,复现论文数字时要显式改 --num_epochs。
三、实验结果
3.1 HPatches:严格阈值下不占优,宽松阈值下最好
HPatches[11] 是局部描述子的标准基准。论文用了 116 个序列中的 108 个(去掉分辨率超过 1200×1600 的),每个序列 6 张图,第一张对其余五张,共 540 对;其中 52 个序列只有光照变化,56 个只有视角变化。匹配协议是最近邻 + 双向最近邻过滤,匹配是否正确由单应性重投影误差是否小于阈值判断;指标是 MMA(mean matching accuracy),即每对图正确匹配比例的平均值。
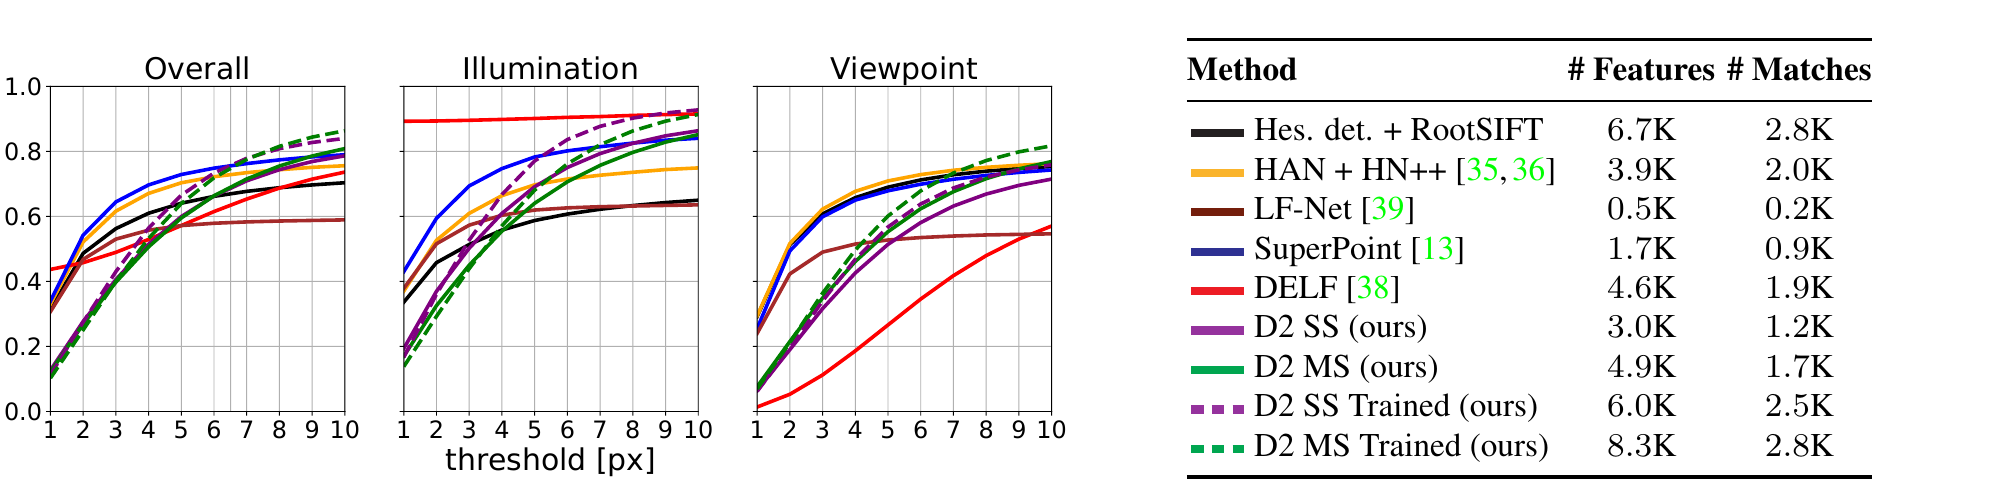
| 方法 | 平均特征数 | 平均匹配数 |
|---|---|---|
| Hessian + RootSIFT | 6.7K | 2.8K |
| HAN + HN++ | 3.9K | 2.0K |
| LF-Net | 0.5K | 0.2K |
| SuperPoint | 1.7K | 0.9K |
| DELF | 4.6K | 1.9K |
| D2 SS | 3.0K | 1.2K |
| D2 MS | 4.9K | 1.7K |
| D2 SS Trained | 6.0K | 2.5K |
| D2 MS Trained | 8.3K | 2.8K |
几个值得注意的点:
- 严格阈值下 D2 不占优。低层检测器(DoG/Hessian)在角点/斑块上的定位精度高于 conv4_3 的 1/4 分辨率特征;论文自己承认这一点,并把这归因于「高层特征更稳但更粗」。
- DELF 在极严格阈值下几乎完美,因为它不做关键点位置精化,检测到的像素位置和特征图网格完全对齐;但它在视角变化序列上表现很差,说明「位置准」和「匹配稳」不是一回事。
- LF-Net 增加关键点数量反而变差。论文尝试把 LF-Net 的关键点从默认的 500 增加,结果更差;作者怀疑是它的匹配没有强制双向最近邻。
- 微调显著增加检测数:D2 SS 从 3.0K 涨到 6.0K,D2 MS 从 4.9K 涨到 8.3K,匹配数也相应增加。这说明训练不仅改变了描述子,也改变了「在哪里检测」。
3.2 三维重建:定位精度差一截,但注册图像数持平
三维重建用的是 Local Feature Evaluation Benchmark 的三个场景:Madrid Metropolis(1344 张图)、Gendarmenmarkt(1463 张)、Tower of London(1576 张)。流程是 COLMAP SfM + MVS;指标包括注册图像数、稀疏点云大小、平均轨迹长度、平均重投影误差和稠密点云大小。baseline 是 RootSIFT 和 GeoDesc[12],两者都是 detect-then-describe。
| 数据集 | 方法 | 注册图像 | 稀疏点 | 轨迹长度 | 重投影误差 |
|---|---|---|---|---|---|
| Madrid Metropolis | RootSIFT | 500 | 116K | 6.32 | 0.60px |
| GeoDesc | 495 | 144K | 5.97 | 0.65px | |
| D2 MS | 501 | 84K | 6.33 | 1.28px | |
| D2 MS Trained | 495 | 144K | 6.39 | 1.35px | |
| Gendarmenmarkt | RootSIFT | 1035 | 338K | 5.52 | 0.69px |
| GeoDesc | 1004 | 441K | 5.14 | 0.73px | |
| D2 MS | 1053 | 250K | 5.08 | 1.19px | |
| D2 MS Trained | 965 | 310K | 5.55 | 1.28px | |
| Tower of London | RootSIFT | 804 | 239K | 7.76 | 0.61px |
| GeoDesc | 776 | 341K | 6.71 | 0.63px | |
| D2 MS | 785 | 180K | 5.32 | 1.24px | |
| D2 MS Trained | 708 | 287K | 5.20 | 1.34px |
结论是「可比,但不占优」:注册图像数和轨迹长度与 RootSIFT/GeoDesc 在同一水平,重投影误差大约是它们的两倍(1.2–1.35px vs 0.6–0.73px),稀疏点云和稠密点云都更小。论文的解释是 Lowe ratio test 过滤得太狠:D2 的匹配在 ratio test 下会丢掉 20%–25% 的正确匹配,而 SfM 又必须用 ratio test 来压住重复结构造成的错误注册,所以最后留下的点少。稠密点云也相应少 10%–20%(例如 Madrid:D2 MS 1.46M vs RootSIFT 1.82M)。
这个结果其实很重要:它说明 D2-Net 的定位精度虽然不如低层检测器,但足够支撑 SfM。注册图像数没有崩,轨迹长度也在同一量级(Madrid 略高,Gendarmenmarkt 和 Tower of London 更短),说明它的匹配在全局上基本一致;误差大一点,但没有大到让 bundle adjustment 失败。
3.3 Aachen Day-Night:严格位姿阈值下的明显优势
Aachen Day-Night[6] 是日间重建、夜间查询的长期定位基准:98 张夜间查询图,每张给最多 20 张已知位姿的日间图,先在日间图上做穷举匹配和三角化,得到局部 3D 模型,再把夜间图注册进去。评价指标是位姿误差在给定阈值内的查询比例;越严格的阈值越能反映定位精度。
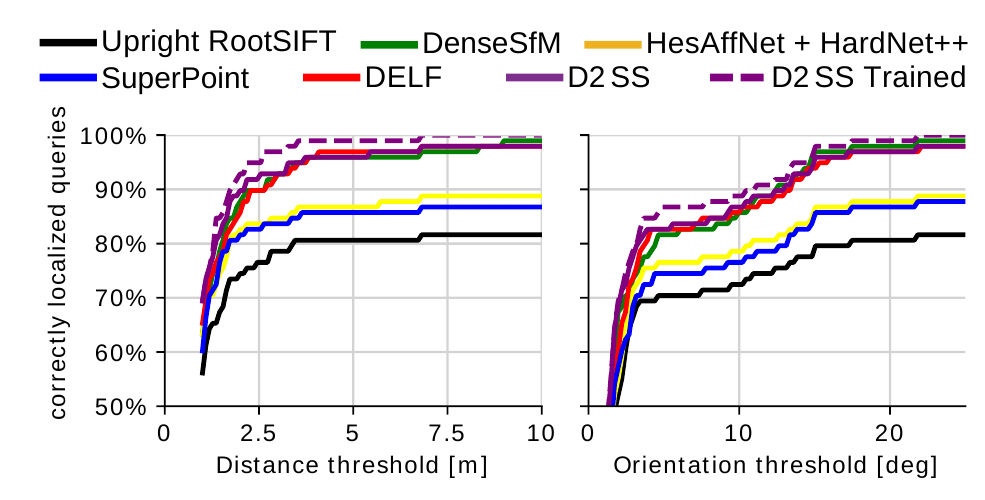
| 方法 | 0.5m, 2° | 1.0m, 5° | 5.0m, 10° | 10m, 25° |
|---|---|---|---|---|
| Upright RootSIFT | 36.7 | 54.1 | 72.5 | 81.6 |
| DenseSfM | 39.8 | 60.2 | 84.7 | 99.0 |
| HAN + HN++ | 39.8 | 61.2 | 77.6 | 88.8 |
| SuperPoint | 42.8 | 57.1 | 75.5 | 86.7 |
| DELF | 38.8 | 62.2 | 85.7 | 98.0 |
| D2 SS | 41.8 | 66.3 | 85.7 | 98.0 |
| D2 MS | 43.9 | 67.3 | 87.8 | 99.0 |
| D2 SS Trained | 44.9 | 66.3 | 88.8 | 100 |
| D2 MS Trained | 44.9 | 64.3 | 88.8 | 100 |
最硬的数字是 0.5m/2°:D2 SS Trained 和 D2 MS Trained 都是 44.9%,比 SuperPoint 的 42.8% 高 2.1 个点,比 RootSIFT 的 36.7% 高 8.2 个点,也比用稠密特征的 DenseSfM(39.8%)高。1.0m/5° 下 D2 MS 的 67.3% 是表里最高;5m/10° 和 10m/25° 下微调版达到 88.8% 和 100%。论文的结论是:在严格位姿阈值下,describe-and-detect 明显优于 detect-then-describe;宽松阈值下大家都会饱和,差距看不出来。
一个反直觉的细节:微调后的 D2 MS 在 1.0m/5° 下(64.3%)反而低于 D2 SS(66.3%),尽管它在更严格的 0.5m/2° 下持平、在更宽松的阈值下更好。这说明多尺度和微调的收益不是单调的,和 2.4 节提到的「多尺度引入混淆描述子」一致。
3.4 InLoc:稀疏特征逼近稠密方法
InLoc[7] 是室内定位基准:约 1 万张数据库图,覆盖两栋楼,查询图和数据库图之间有明显视角、光照和家具变化。论文把 D2 特征接进 InLoc 的两种流程:
- Direct PE:查询图只和检索到的 top-1 数据库图做匹配,然后估计位姿;
- Sparse PE:查询图和 top-100 数据库图匹配,做空间验证,选内点最多的那张估计位姿;
- Dense PE / Dense PV:InLoc 原方法的稠密匹配和稠密位姿验证,作为更强的 baseline。
| 方法 | 0.25m | 0.5m | 1.0m | 内存/图 |
|---|---|---|---|---|
| Direct PE - Aff. RootSIFT | 18.5 | 26.4 | 30.4 | — |
| Direct PE - D2 MS | 27.7 | 40.4 | 48.6 | — |
| Sparse PE - Aff. RootSIFT | 21.3 | 32.2 | 44.1 | 5MB |
| Sparse PE - D2 MS | 35.0 | 48.6 | 62.6 | 15MB |
| Dense PE | 35.0 | 46.2 | 58.1 | 44MB |
| Sparse PE - Aff. RootSIFT + Dense PV | 29.5 | 42.6 | 54.5 | — |
| Sparse PE - D2 MS + Dense PV | 38.0 | 54.1 | 65.4 | — |
| Dense PE + Dense PV(InLoc) | 41.0 | 56.5 | 69.9 | — |
| InLoc + D2 MS | 43.2 | 61.1 | 74.2 | — |
几个关键对比:
- Direct PE:D2 MS 在 0.25m 下 27.7% vs RootSIFT 18.5%,相对提升约 50%;在 1.0m 下 48.6% vs 30.4%。
- Sparse PE:D2 MS 35.0/48.6/62.6,全面超过 RootSIFT 的 21.3/32.2/44.1,而且在 0.5m/1.0m 上超过了 Dense PE 的 35.0/46.2/58.1(0.25m 持平),内存却只有 15MB/图 vs 44MB/图。
- 只有 InLoc 的 Dense PV 能压过 D2:Dense PE + Dense PV 是 41.0/56.5/69.9;但把 D2 的稀疏位姿和 InLoc 的 Dense PV 结合,得到 43.2/61.1/74.2,是这张表里的最好结果。
- 代价是内存:D2 的 512 维描述子每图 15MB,是 RootSIFT 5MB 的三倍;但相比稠密方法的 44MB,仍然小得多。
论文的结论是:稀疏特征可以在室内定位上接近稠密方法,尤其是在弱纹理场景里,D2 的「物体级」匹配(比如把不同场景里的同一款家具匹配起来)反而能提供稠密方法忽略的线索。
3.5 消融:为什么是 VGG16,为什么是 1/4 分辨率
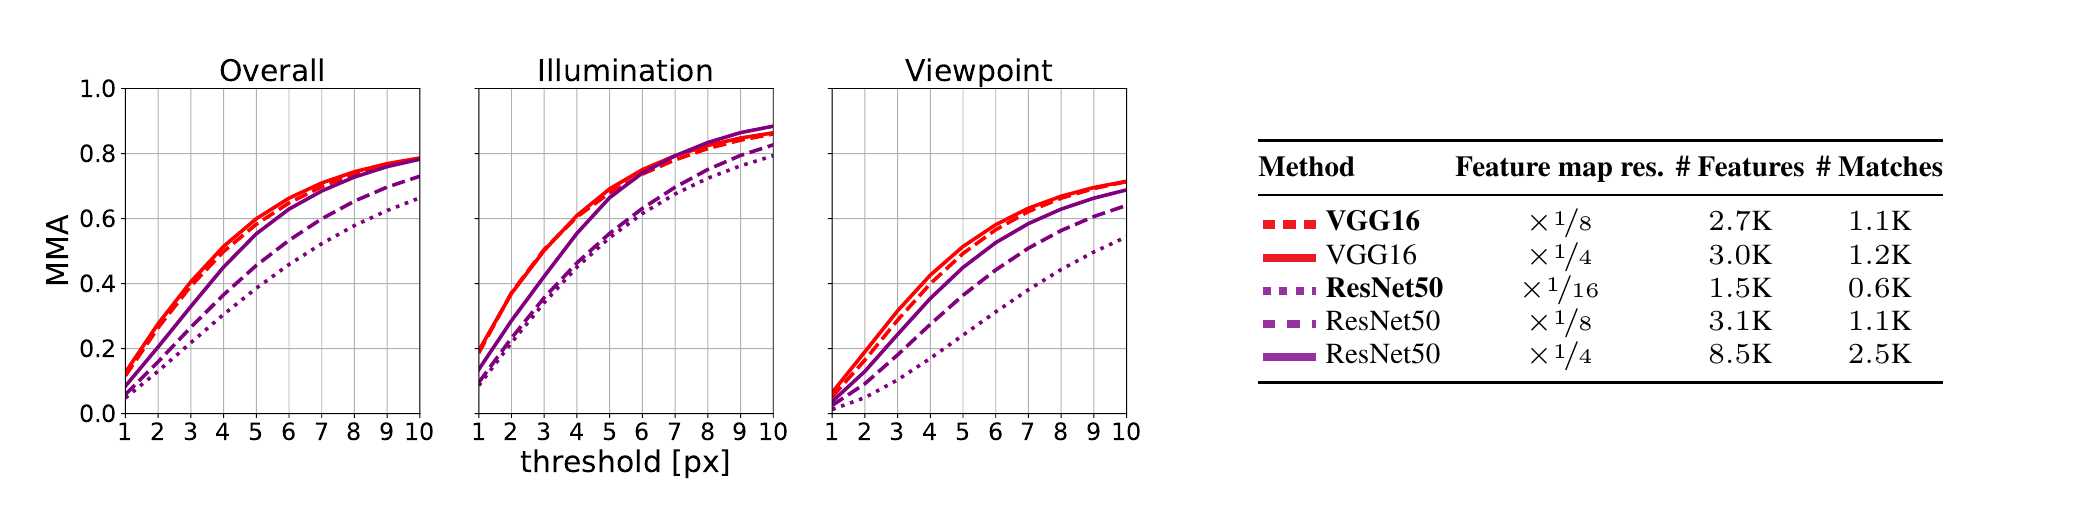
消融的要点:
- 膨胀卷积有用:VGG16 从 ×1/8 提到 ×1/4,特征数从 2.7K 涨到 3.0K,视角变化下的曲线明显改善;ResNet50 从 ×1/16 提到 ×1/4,特征数从 1.5K 涨到 8.5K,但视角变化仍然不如 VGG16。
- VGG16 比 ResNet50 更适合这个任务:即使特征图分辨率相同(×1/4),VGG16 的视角鲁棒性也更好;ResNet50 的优势主要在光照变化和宽松阈值。论文因此选了 VGG16。
- 微调的作用:HPatches 上特征数接近翻倍(SS 3.0K→6.0K,MS 4.9K→8.3K),Aachen 严格阈值提升 1–3 个点。但 off-the-shelf 已经很强,说明方法本身的设计比训练数据更关键。
- 多尺度的作用:见 2.4 节,提升视角鲁棒性,但可能牺牲光照鲁棒性;不是无脑开。
3.6 定性结果与失败案例
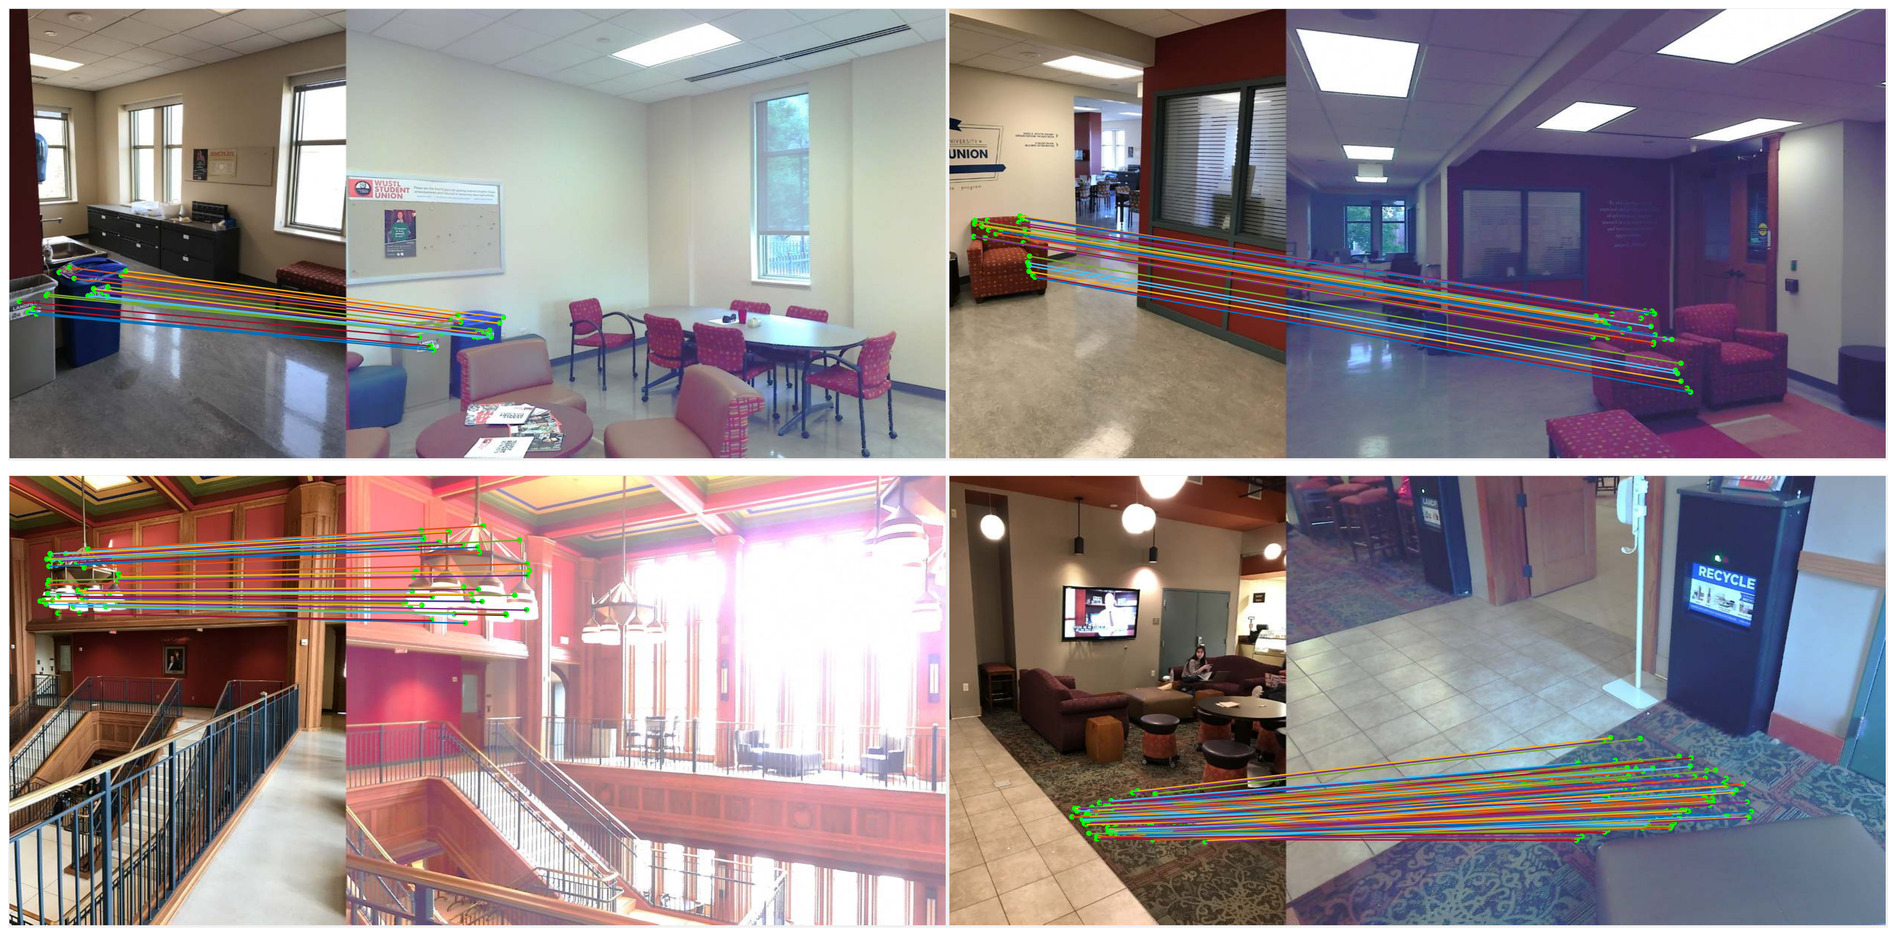
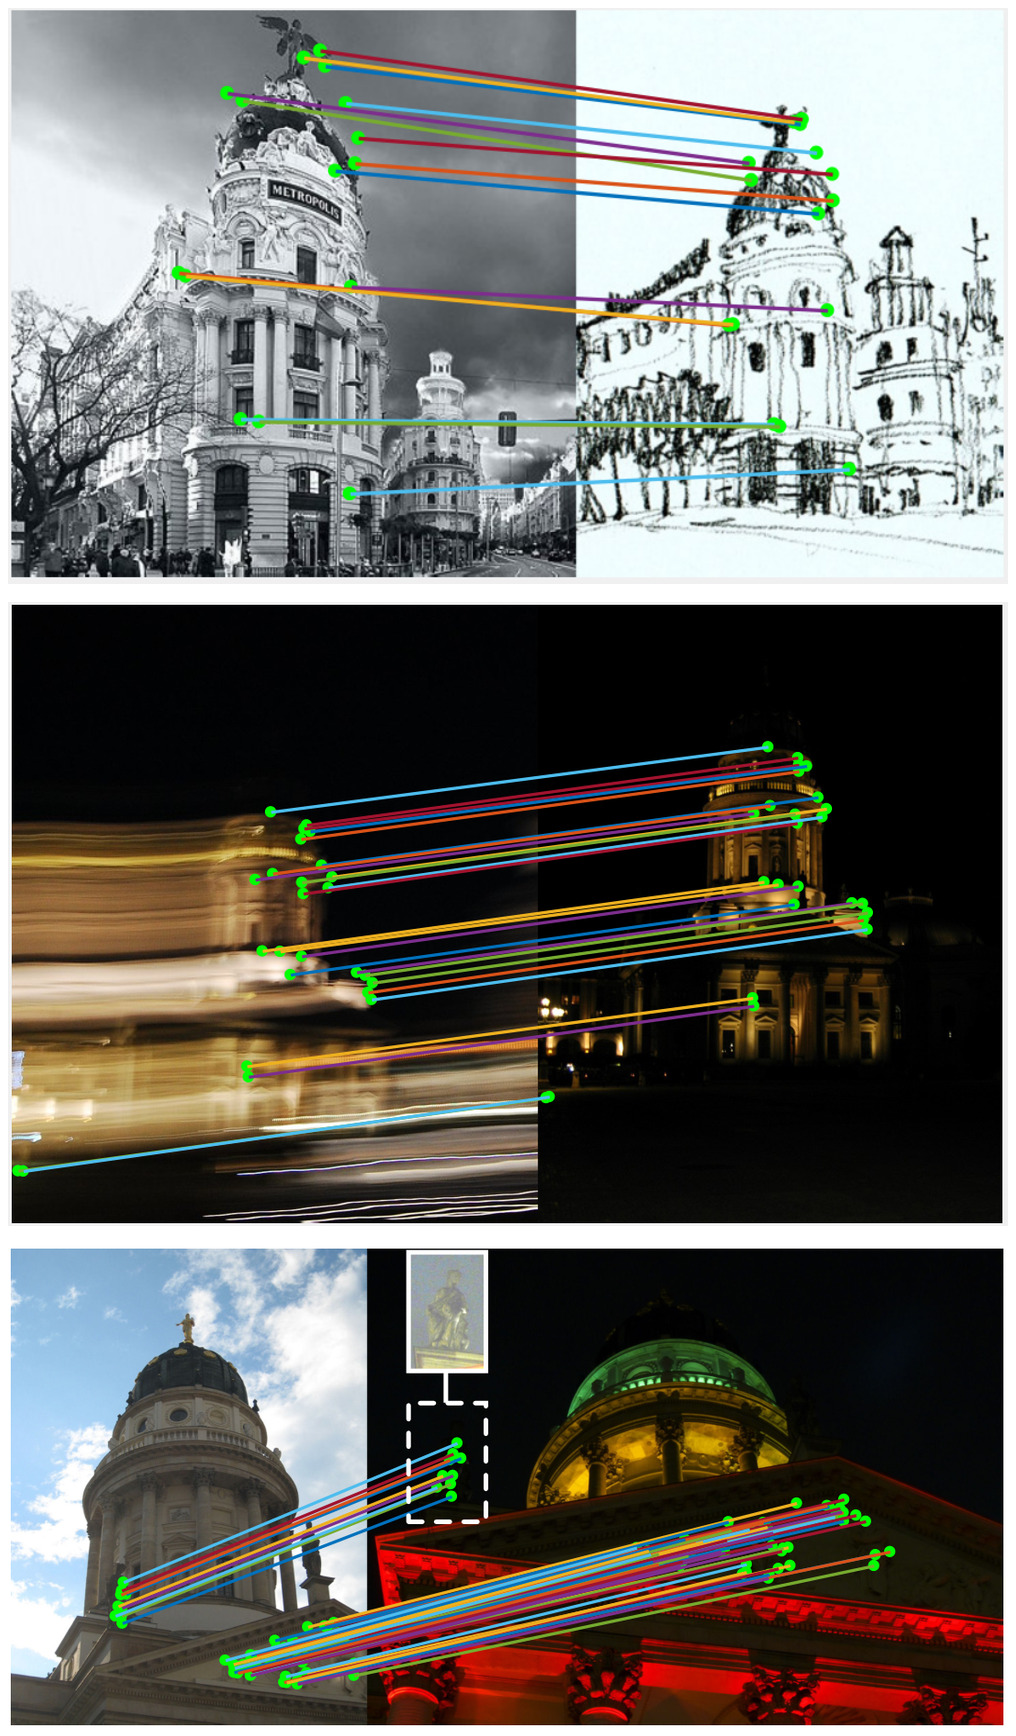
定性结果分两面看。好消息是,D2 在剧烈外观变化下确实能给出大量一致匹配:图 1 的线稿、运动模糊、日夜场景都是例子;InLoc 的正确匹配里,它甚至能把不同场景里的同款家具匹配起来,起到「物体匹配器」的作用。坏消息也正是从这里来的:同款家具、重复吊灯、地毯花纹在特征空间里几乎一样,匹配在几何上一致,但对应的不是同一个 3D 点。论文的 Figure 11 就是四组这样的例子。
附录 A 还量化了 ratio test 的问题:D2 的正确匹配和错误匹配在 ratio 分布上没有清晰的分界(SIFT 有),所以 Lowe ratio test 对 D2 不好用。论文用的阈值是 off-the-shelf 0.90、微调 0.95;即使这样,也会过滤掉 79.9%/74.4% 的错误匹配,但同时丢掉 23.3%/21.9% 的正确匹配。论文的建议很明确:在困难条件下的定位任务里,不要用 ratio test;在 SfM 里可以用,但要接受正确匹配的损失。
四、局限性
4.1 论文自己承认的
- 关键点定位精度不如低层检测器。D2 的检测建立在 conv4_3 的高层特征上,特征图只有 1/4 分辨率;在 HPatches 的严格阈值(1–6px)下,它不如 Hessian + RootSIFT、HAN + HN++。论文把这视为 describe-and-detect 的固有代价,并用 SIFT 式的局部精化来缓解,但没有完全消除。
- SfM 里 ratio test 会丢掉大量正确匹配。D2 的正确/错误匹配 ratio 分布重叠,ratio test 在过滤错误匹配的同时会丢掉 20%–25% 的正确匹配,导致稀疏点云和稠密点云都比 RootSIFT/GeoDesc 小。
- 多尺度可能伤害光照鲁棒性。多尺度提升了视角变化下的表现,但引入了更多混淆描述子;Aachen 上微调后的 MS 在 1m/5° 下反而低于 SS。
- 训练数据有视角偏差。MegaDepth 里约 90% 的图像对视角变化小于 20°,所以 D2 在视角变化大的序列上表现较差;这不是网络结构的问题,是数据分布的问题。
- 重复物体/图案是主要失败模式。同款家具、重复吊灯、地毯花纹会产生视觉上正确、几何上一致、但语义上错误的匹配;ratio test 也救不了。
4.2 我自己再补几条
- 软检测得分是图内归一的,不是跨图校准的。公式 (7) 让每张图的 加起来等于 1,所以一张纹理丰富的图和一张平坦的图,最高分的绝对值不可比。推理时用硬检测,不受影响;但如果想用 做跨图的关键点排序或阈值筛选,需要额外校准。
- 检测器没有显式的可重复性目标。软得分奖励的是「描述子独特」,这和「检测可重复」相关,但不是一回事。R2D2[13] 后来把可重复性(repeatability)和可靠性(reliability)拆成两张图分别监督,DISK[14] 用策略梯度直接优化关键点选择,都是在补 D2 的这个缺口。
- 训练和测试的特征统计不一致。训练用 1/8 分辨率、无膨胀卷积;测试用 1/4 分辨率、膨胀卷积。论文附录 B 说训练时不用膨胀卷积是显存限制,但没有分析这种不一致对性能的影响。微调后的模型在测试时见到的是它训练时没见过的感受野/分辨率组合,这可能是一部分「训练收益不稳定」的来源。
- 没有旋转不变性。D2 的检测和描述都在图像坐标系里做,金字塔只处理尺度,不处理平面内旋转;论文的评测也没有专门测大角度旋转。如果场景有 90°/180° 旋转或俯拍,D2 不是合适的选择。
- 2019 年的模型已经不是今天的 SOTA。在 MegaDepth-1500、ScanNet 这些现代匹配基准上,D2-Net 的成绩早就被 R2D2、DISK、LoFTR 和后续的稠密匹配器超过。今天读它,价值主要在「describe-and-detect」这个范式转换,以及它作为 R2D2/DISK 前身的历史位置,而不是把它当成一个现成的最强特征。
- 官方训练代码是 PyTorch 实现,默认训练轮数和论文不同。README 说明这份代码对应原 TensorFlow 训练流程,默认 10 个 epoch(论文 50 个),并且经历过数据预处理 bug 修复和数据集更新。复现论文数字时不能直接按默认脚本跑,要按论文的超参调整,并注意权重版本。
五、结论与展望
D2-Net 的核心贡献不是「又一个新的关键点检测器」,而是一个视角的倒转:检测不必是一个独立的任务,它可以是描述子特征图的一种读法。当描述子在一个像素上局部独特时,这个像素自然就应该被检测;检测和描述共享同一组参数、同一个损失、同一张特征图,于是「在哪里检测」和「描述得怎么样」不再由两个可能互相冲突的目标分别决定。
这条思路的历史位置很清楚:
- 它接在 SIFT/SURF/RootSIFT 的 detect-then-describe 之后,指出检测器是困难条件下的短板;
- 它和 SuperPoint 同期,但比 SuperPoint 更彻底:SuperPoint 还有独立的检测头和检测损失,D2 把检测完全并入描述张量;
- 它启发了 R2D2(把可重复性和可靠性显式建模)、DISK(用策略梯度处理离散关键点)、以及后续一系列联合检测-描述的工作;
- 再往后,LoFTR[15] 干脆取消了检测阶段,用稠密 Transformer 匹配把「关键点」这个中间表示也省掉——这是另一条路,但问题意识是一样的:检测器不该成为匹配的上限。
对今天的使用者,我的建议是:
- 要鲁棒、不要极限精度:D2-Net 仍然是一个合理的 baseline,尤其在日夜、季节、弱纹理场景;它的匹配数量大,适合做检索后的几何验证。
- 要亚像素精度:不要用 D2;HPatches 的严格阈值已经说明它不如低层检测器,SfM 里的重投影误差也大约是 RootSIFT 的两倍。
- SfM 里慎用 ratio test:如果非要用,按论文的 0.90/0.95 阈值,并接受 20%–25% 的正确匹配损失;定位任务里干脆别用。
- 多尺度按场景开:日夜/室内/视角变化大时开,追求速度或光照变化极端时先试单尺度。
- 权重和 ReLU 要对上:off-the-shelf 权重配
--no-relu,微调权重用默认 ReLU;这是论文附录 B 的结论,代码默认值和论文报告值不完全一致。
论文自己给出的未来方向是:提高关键点的空间分辨率、回归更精确的像素位置、把 ratio test 类的目标整合进损失。前两条后来被 R2D2/DISK 沿着做了,第三条在 SfM 社区里仍然是一个开放问题。
六、上手
官方仓库是 PyTorch 实现,包含特征提取、MegaDepth 预处理和训练。README 的安装命令用的是比较旧的 CUDA 10.0 栈,Python 3.6+;如果你用新环境,按自己的 CUDA 版本装 PyTorch 即可。
安装命令(README 的 conda 旧栈)
conda install pytorch torchvision cudatoolkit=10.0 -c pytorch
conda install h5py imageio imagesize matplotlib numpy scipy tqdm权重有三个版本:d2_ots.pth 是 off-the-shelf 的 Caffe VGG16 权重,d2_tf.pth 是在 MegaDepth 上微调过的权重,d2_tf_no_phototourism.pth 是去掉 PhotoTourism 场景后训练的版本(README 的更新说明里说初始结果显示性能相近)。
下载预训练权重
mkdir models
wget https://dusmanu.com/files/d2-net/d2_ots.pth -O models/d2_ots.pth
wget https://dusmanu.com/files/d2-net/d2_tf.pth -O models/d2_tf.pth
wget https://dusmanu.com/files/d2-net/d2_tf_no_phototourism.pth -O models/d2_tf_no_phototourism.pth
最小示例是准备一个 images.txt,每行一个图像路径,然后:
单尺度 / 多尺度特征提取
python extract_features.py --image_list_file images.txt
python extract_features.py --image_list_file images.txt --multiscale
输出是 .d2-net 文件(默认 npz),里面有三个数组:keypoints 是 N×3,列是 x, y, scale,坐标遵循 COLMAP 约定(X 向右、Y 向下);scores 是 N 维检测得分;descriptors 是 N×512,已经 L2 归一化。显存方面,README 说单尺度 1200×1600 的图不到 6GB,多尺度建议至少 12GB。
如果你用 kapture 格式的数据集,可以装 kapture 后用 extract_kapture.py,命令和 extract_features.py 类似:
kapture 数据集的特征提取
pip install kapture
kapture_download_dataset.py update
kapture_download_dataset.py list
kapture_download_dataset.py install "Extended-CMU-Seasons_slice22_*"
python extract_kapture.py --kapture-root pathto/yourkapturedataset --multiscale
训练需要先下载完整的 MegaDepth(包括 SfM 模型),用 COLMAP 做去畸变重建,再算图像重叠和相机参数:
MegaDepth 预处理与训练
python undistort_reconstructions.py --colmap_path /path/to/colmap/executable --base_path /path/to/megadepth
bash preprocess_undistorted_megadepth.sh /path/to/megadepth /path/to/output/folder
python train.py --use_validation --dataset_path /path/to/megadepth --scene_info_path /path/to/preprocessing/output
最后提醒两点:第一,训练脚本的默认 epoch 是 10,论文是 50,想复现论文数字要改 --num_epochs;第二,off-the-shelf 权重建议加 --no-relu,微调权重用默认的 ReLU,原因见 2.1 节和论文附录 B。官方的 extract_features.py 默认用 models/d2_tf.pth,也就是微调权重;如果你要复现论文里的 D2 SS / D2 MS(off-the-shelf)结果,记得显式换权重和 ReLU 设置。
参考
- Dusmanu, Rocco, Pajdla, Pollefeys, Sivic, Torii, Sattler. D2-Net: A Trainable CNN for Joint Description and Detection of Local Features. CVPR 2019. arXiv · 代码
- Lowe. Distinctive Image Features from Scale-Invariant Keypoints. IJCV 2004. DOI
- Bay, Tuytelaars, Van Gool. SURF: Speeded Up Robust Features. ECCV 2006. DOI
- Arandjelovic, Zisserman. Three things everyone should know to improve object retrieval. CVPR 2012. PDF
- Ono, Trulls, Fua, Yi. LF-Net: Learning Local Features from Images. NeurIPS 2018. arXiv · 代码
- Sattler, Maddern, Toft, Torii, Hammarstrand, Stenborg, Safari, Okutomi, Pollefeys, Sivic, Kahl, Pajdla. Benchmarking 6DOF Outdoor Visual Localization in Changing Conditions. CVPR 2018. arXiv
- Taira, Okutomi, Sattler, Cimpoi, Pollefeys, Sivic, Pajdla, Torii. InLoc: Indoor Visual Localization with Dense Matching and View Synthesis. CVPR 2018. arXiv · 代码
- DeTone, Malisiewicz, Rabinovich. SuperPoint: Self-Supervised Interest Point Detection and Description. CVPR Workshops 2018. arXiv · 代码
- Noh, Araujo, Sim, Weyand, Han. Large-Scale Image Retrieval with Attentive Deep Local Features. ICCV 2017. arXiv · 代码
- Li, Snavely. MegaDepth: Learning Single-View Depth Prediction from Internet Photos. CVPR 2018. arXiv · 代码
- Balntas, Lenc, Vedaldi, Mikolajczyk. HPatches: A Benchmark and Evaluation of Handcrafted and Learned Local Descriptors. CVPR 2017. arXiv · 代码
- Luo, Shen, Zhou, Zhu, Zhang, Yao, Fang, Quan. GeoDesc: Learning Local Descriptors by Integrating Geometry Constraints. ECCV 2018. arXiv · 代码
- Revaud, Weinzaepfel, De Souza, Pion, Csurka, Cabon, Humenberger. R2D2: Repeatable and Reliable Detector and Descriptor. NeurIPS 2019. arXiv · 代码
- Tyszkiewicz, Fua, Trulls. DISK: Learning Local Features with Policy Gradient. NeurIPS 2020. arXiv · 代码
- Sun, Shen, Wang, Bao, Zhou. LoFTR: Detector-Free Local Feature Matching with Transformers. CVPR 2021. arXiv · 代码