· 62 min read
半个像素的暗礁:grid_sample、align_corners 与视觉里的 ±0.5
TL;DR
- 像素既可以看成点(中心坐标),也可以看成单位小方块(角点坐标),两者差 0.5;本文所有 ±0.5 都是在这两个坐标系之间换。
align_corners=True把归一化坐标的 ±1 对准角像素的中心;False把它对准图像的外边缘。同一个 在两种模式下最多差半个像素,图像中心处完全重合。False加默认的零填充会让边界像素只拿到一半权重,所以连 identity grid 也会出现暗边。- hloc 的
(x+0.5)*s-0.5是 OpenCV resize 的精确逆映射;keypoints += 0.5是 OpenCV 中心系到 COLMAP 角点系的转换。- 半像素是系统偏差,不会被平均掉; 时 0.5 px 约 0.03°, 时 3.5 px 约 0.2°。最麻烦的是重投影误差看不出来。
一、一个像素,两种坐标
我第一次在 hloc 里看到这行代码时,盯着它看了很久:
pred["keypoints"] = (pred["keypoints"] + 0.5) * scales[None] - 0.5先加 0.5,再乘缩放,再减 0.5。为什么要绕这一圈?直接乘 scales 不是更自然吗?后来我才明白,这不是什么经验修补,而是在换坐标系:先走到像素的角点坐标系,在那里缩放是线性的,乘完再回到像素中心坐标系。
要看清这件事,先得接受一个事实:像素不是数学点,而是图像这个连续平面上的一小块单位面积。一张 的图,可以看成 个边长为 1 的小方块拼成的矩形。每个小方块有一个中心,也有四条边和四个角。于是同一张图至少有两种自然的坐标:
- 中心坐标系(center frame):像素 的中心就是 。OpenCV 的
KeyPoint.pt、PyTorch 里关键点张量、绝大多数检测器的输出都用它。图像的范围是 。 - 角点坐标系(corner frame):图像左上角是 ,像素 的中心是 。COLMAP 用它;
grid_sample(align_corners=False)的归一化坐标本质上也是它。
同一个物理点,在两种坐标下只差一个常数:
这不是插值,不是对齐误差,也不是“COLMAP 喜欢多数半个像素”。它只是同一把尺子的零点放在不同地方。图 1 把这件事画了出来:网格线一根没动,橙色的尺子从像素中心开始数,蓝色的尺子从图像角上开始数。
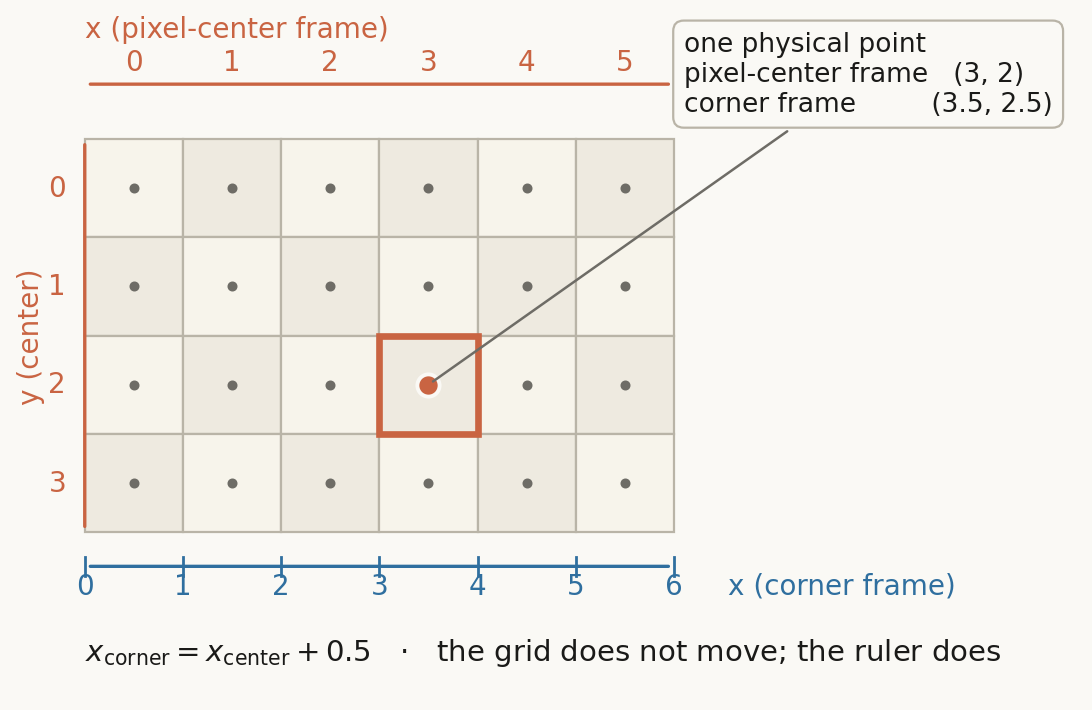
后面所有的 ±0.5,包括 grid_sample、resize、COLMAP、内参缩放,都是图 1 的推论。记住“网格不动、尺子动”,就不会再把它们当成魔法数字。
二、grid_sample 的两把尺子
grid_sample 的输入是一个 的张量,以及一个 的 grid。grid[...,0] 是 (横坐标),grid[...,1] 是 (纵坐标),它们被归一化到 。对每个 ,grid_sample 在输入图上做双线性插值,输出一个 维向量。
align_corners 决定的只有一件事: 和 到底指哪里。PyTorch 文档的原话是:
Geometrically, we consider the pixels of the input as squares rather than points. If set to
True, the extrema (-1 and 1) are considered as referring to the center points of the input’s corner pixels. If set toFalse, they are instead considered as referring to the corner points of the input’s corner pixels, making the sampling more resolution agnostic.[1]
翻成公式。输入宽为 、高为 ,同一个 对应的像素坐标是:
两式的来历可以直接从端点条件读出来:
True: 是左端像素的中心 , 是右端像素的中心 。两点确定一条直线,就是 。False: 是图像的左外边缘 , 是右外边缘 。两点确定一条直线,就是 。
把两式相减:
这个差在图像中心 为零,越往边界越大:在四条边的中点,一个方向差 0.5 px;在四个角上,两个方向各差 0.5 px,二维距离是 px。注意这是对同一个 而言的:同一个归一化坐标,在两种模式下指向不同的物理点。反过来说,如果你想指向同一个物理点,两种模式需要不同的 :
其中 是中心坐标系的像素坐标。这两个公式是本文后面反复出现的原型。图 2 用一个真实的 裁剪把“同一个点、四种描述”放在一起。
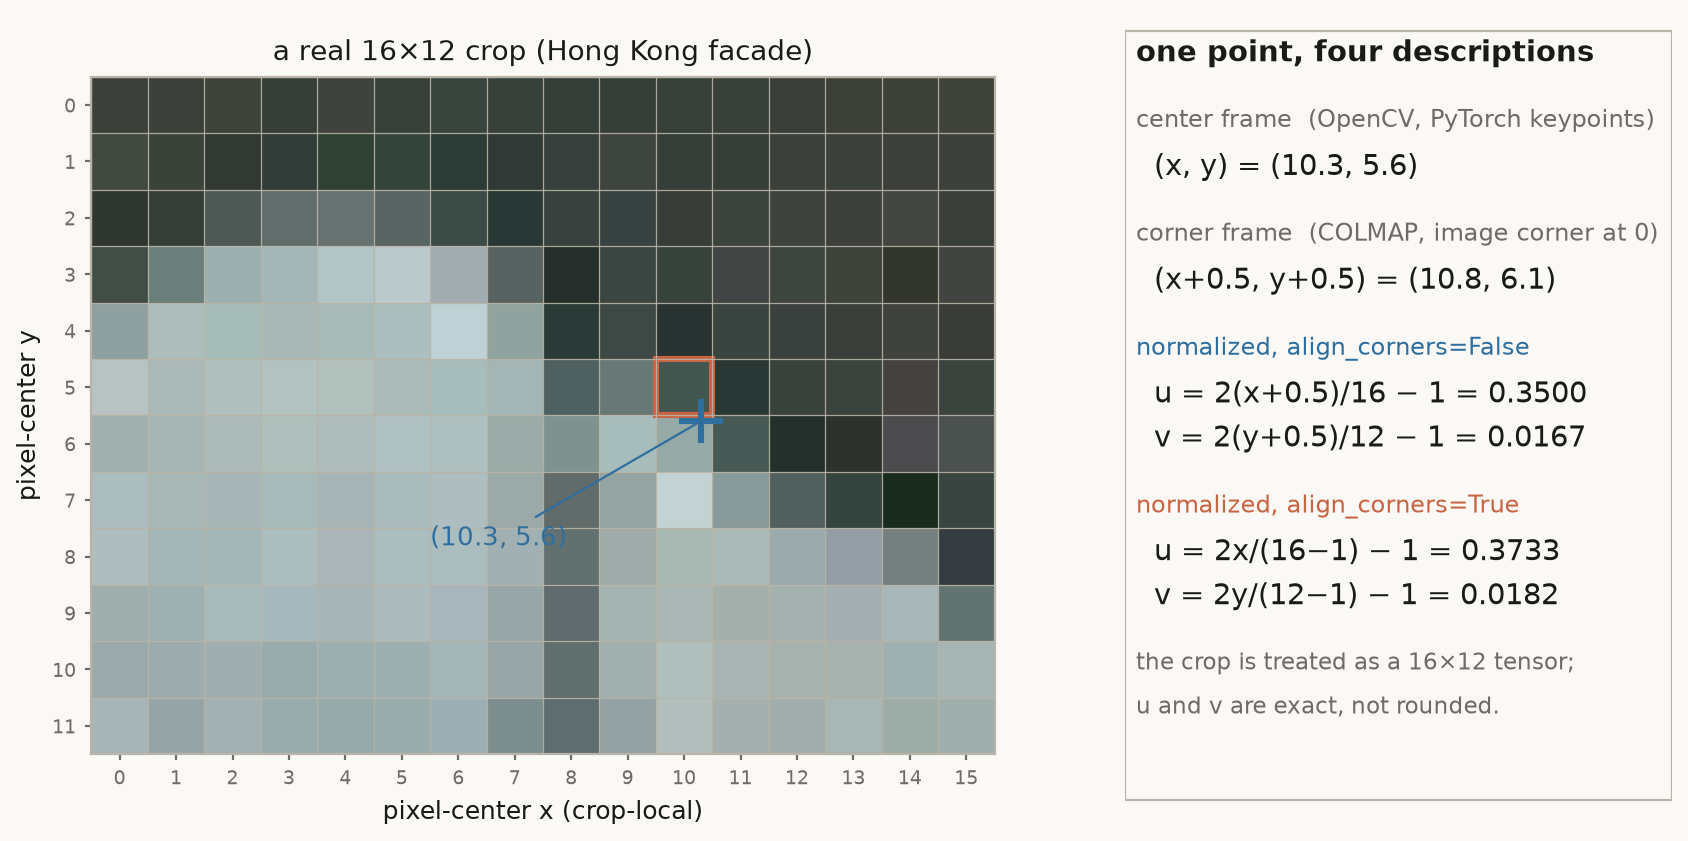
align_corners 下的归一化坐标。四个数描述的是同一个点;只有把公式和模式配错,才会落到别处。下面这个部件把图 2 做成可拖动的。橙色圈是你拖到的物理点;当勾选“用错公式”时,蓝色点是 grid_sample 实际采样的位置。把探针拖到角落,误差最明显。
部件 1:拖动探针。两种模式给出的 (u, v) 数值不同,但正确的配对都落在橙圈上;配错公式后,蓝色落点会向中心或向外偏,边界处每个方向最多偏 0.5 px。
这里还有一个常被忽略的点:文档里说 False 让采样“more resolution agnostic”。原因是 False 的映射里没有 :
右边就是“这个点在图像宽度中所占的比例”,与分辨率无关;同一组比例坐标可以直接用在 宽的原图、 宽的缩略图和 宽的特征图上。而 True 的映射带着 ,像素中心的位置会随分辨率变化,identity grid 也就跟着变。这正是大多数现代网络默认用 False 的原因:它们不希望归一化坐标的物理含义随输入尺寸漂移。
三、边界上的半像素
False 的副作用在边界上最明显。取 ,一维情况下采样坐标是 :它正好落在最后一个像素(中心 )和图像外(中心 )的正中间。双线性插值给两边各一半权重:
grid_sample 默认 padding_mode='zeros',所以 是 0,边界像素的颜色被压成一半。二维的角点更严重: 落在右下外角,只有 的权重落在角像素上,另外 都是零。图 3 用真实的 裁剪展示了这件事:同一组 linspace(-1,1) 网格,True 精确复现原图,False 出现一圈暗边,并且整张图轻微外扩。
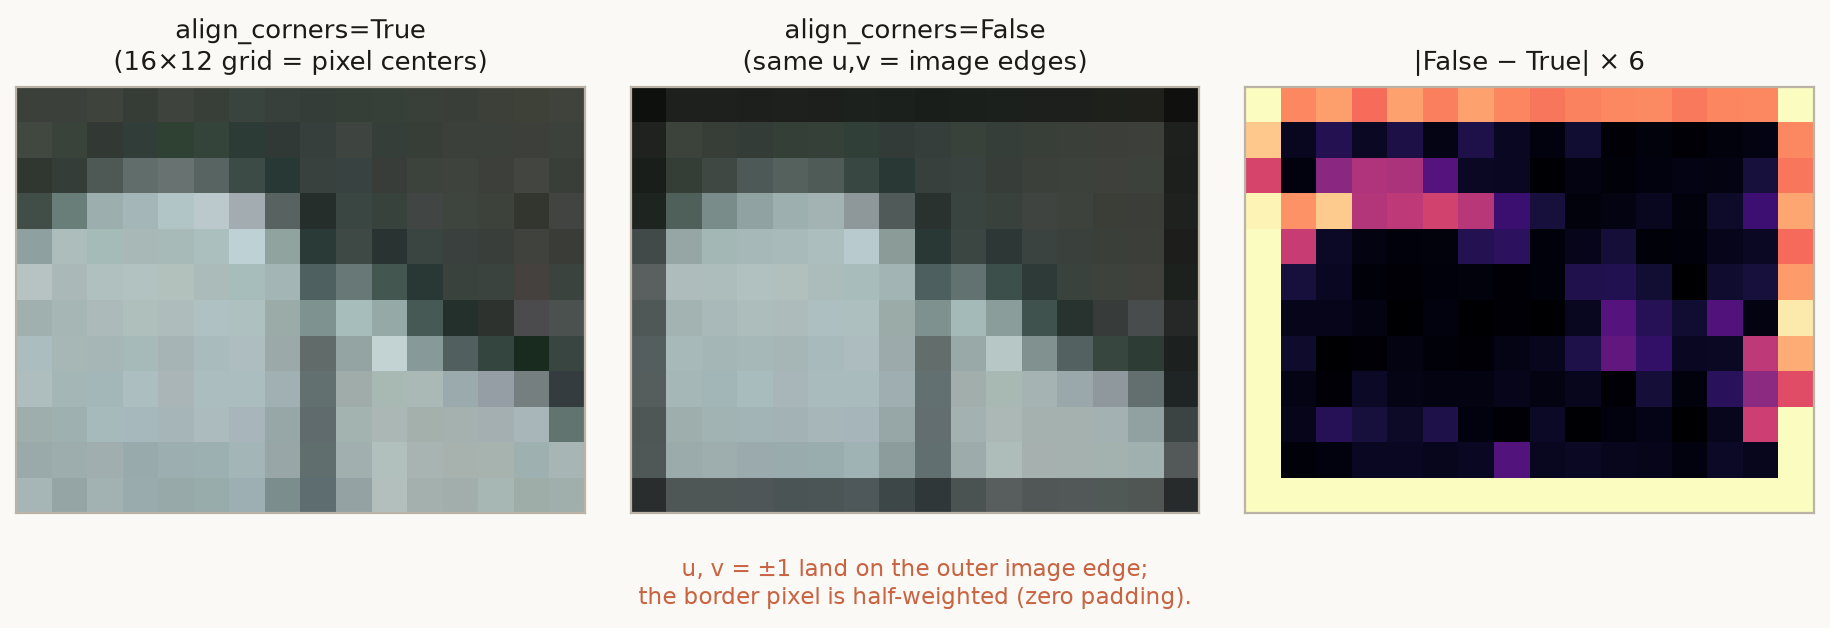
linspace(-1,1) 的两种解释。True 精确复现原图;False 把 ±1 解释成图像外边缘,边界像素只有一半权重,于是出现暗边和轻微外扩。右图是差异放大 6 倍。先别急着把锅甩给 align_corners=False。暗边来自 零填充,不是来自坐标约定。如果把 padding_mode 改成 'border',图像外的值会复制边界像素,暗边就消失了;采样位置仍然在像素外半格,但颜色是连续的。'reflection' 同理。所以更准确的说法是:False 把 ±1 定义在图像外边缘,零填充负责把“图像外”变成黑色。两者叠加,才得到图 3 的暗边。
用 的玩具例子可以把权重算得一清二楚。四个像素分别是红、绿、蓝、黄,取四个角 :
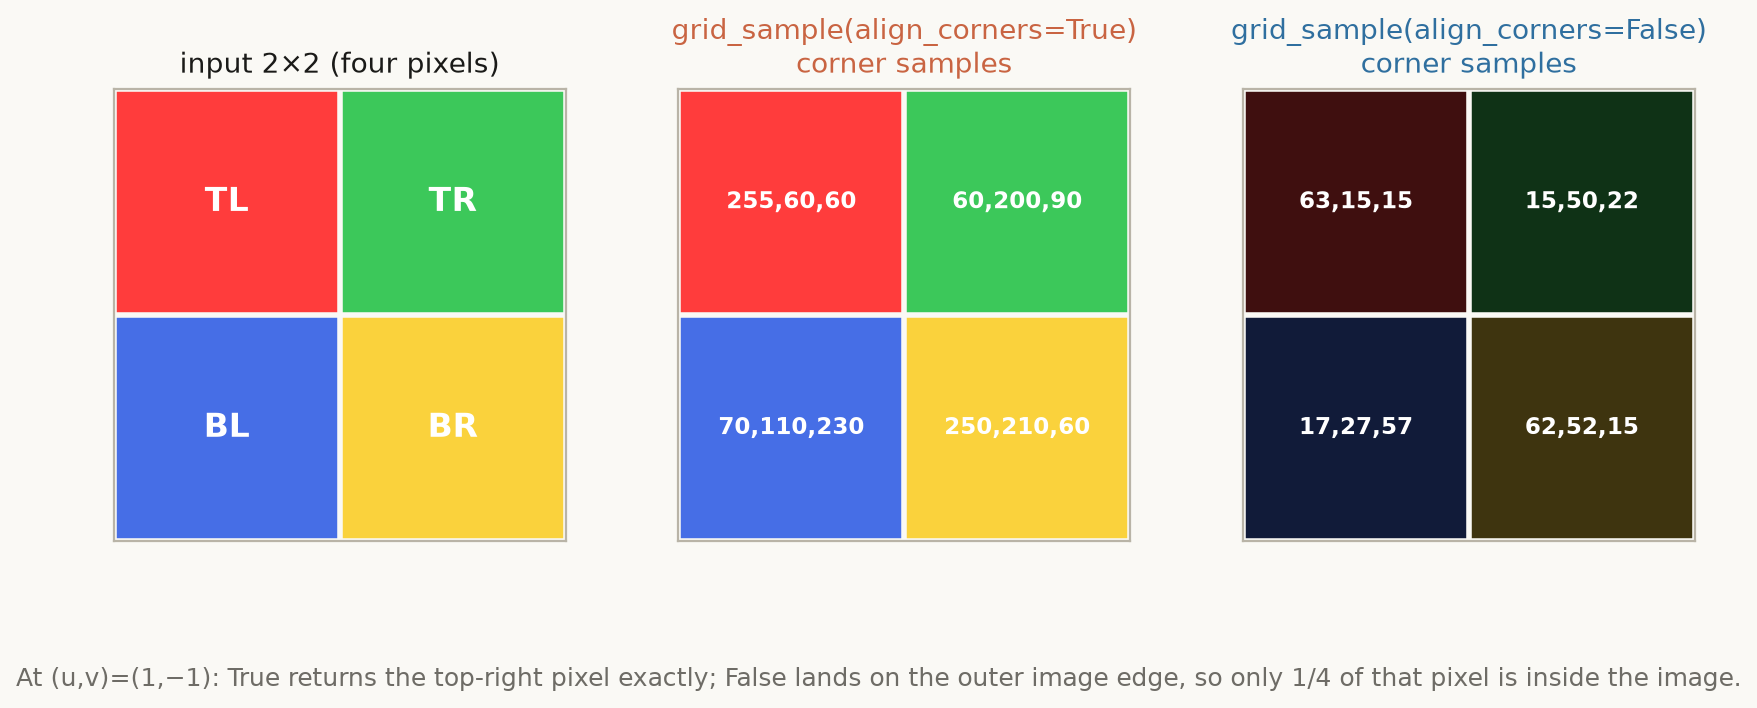
True 在 精确命中四个角像素;False 落在图像外角,角点只剩 权重,颜色被零填充压暗到 。具体地,在 (右上):
True:,,正好是右上像素的中心,输出 。False:,,落在右上像素的外角,只有 权重在图像内,输出 ,正好是原色的 。
下面的部件可以拖动 ,同时看两种模式的权重和输出。
部件 2:拖动 (u, v)。蓝点是 False 的落点(±1 在图像外边缘),橙点是 True 的落点(±1 在角像素中心)。中心处两者重合;越往角上,蓝点越靠外,图像外的权重越大。
那么,到底该用 True 还是 False?我的建议很简单:以你加载的权重为准。如果模型是在 False 下训练的(现在的默认值),就保持 False,归一化时用中心坐标系的公式 ;如果权重明确是用 True 训的,就用 True 和 。真正的错误不是选了哪一个,而是在同一条流水线里混用:interpolate 用 False、affine_grid 用 True、grid_sample 又用另一个,三者之间的半像素会互相错位。PyTorch 文档也特意提醒:align_corners 要和预缩放时 interpolate() 的设置一致[1, 2]。
四、把关键点放回原图
现在来看 hloc 的第一行代码。检测器通常不会在原图上跑:为了速度和显存,hloc 先把图像缩到最长边 1024 或 1600,再把检测器输出的关键点映射回原图[5]。这行代码做的就是这件事:
# hloc/hloc/extract_features.py:270-274
pred["image_size"] = original_size = data["original_size"][0].numpy()
if "keypoints" in pred:
    size = np.array(data["image"].shape[-2:][::-1])
    scales = (original_size / size).astype(np.float32)
    pred["keypoints"] = (pred["keypoints"] + 0.5) * scales[None] - 0.5
设原图宽 、缩放图宽 ,缩放因子
OpenCV 的 resize 不是简单地把目标像素复制到源像素的整数位置。它对每个目标像素的中心,按下面的映射去源图采样[4]:
这个式子对 INTER_LINEAR、INTER_AREA 等插值方式都成立(采样核不同,坐标映射相同)。反过来,已知源图(原图)坐标,要问“它在缩放图里的哪里”,就是:
hloc 的检测器输出的是缩放图的中心坐标 ,要回到原图,直接代入第一式:
这就是 +0.5 → ×s → −0.5 的全部来历。中间的 把中心坐标移到角点坐标系;在角点坐标系里,缩放是线性的(角点就是按比例缩放的);最后的 再回到中心坐标系。
一个一维例子可以把误差量出来。把一行 [0, 10, 20, 30] 缩到 2 个像素:
>>> cv2.resize(np.array([[0, 10, 20, 30]], np.float32), (2, 1))
array([[ 5., 25.]], dtype=float32)
输出是 [5, 25],不是 [0, 20]。目标像素 0 的中心对应源坐标 ,正好落在源像素 0 和 1 的中点,所以取两者的平均;目标像素 1 的中心对应源坐标 ,取像素 2 和 3 的平均。如果忘了 ,你会认为目标像素 0 对应源像素 0,直接取 0——在 时就错了 0.5 px, 时错 1.5 px, 时错 3.5 px。
图 5 把这个误差画了出来:原图上的点 , 时检测器在缩小图里看到的是 ;正确回投是 ,朴素地乘 得到 ,差了 px。
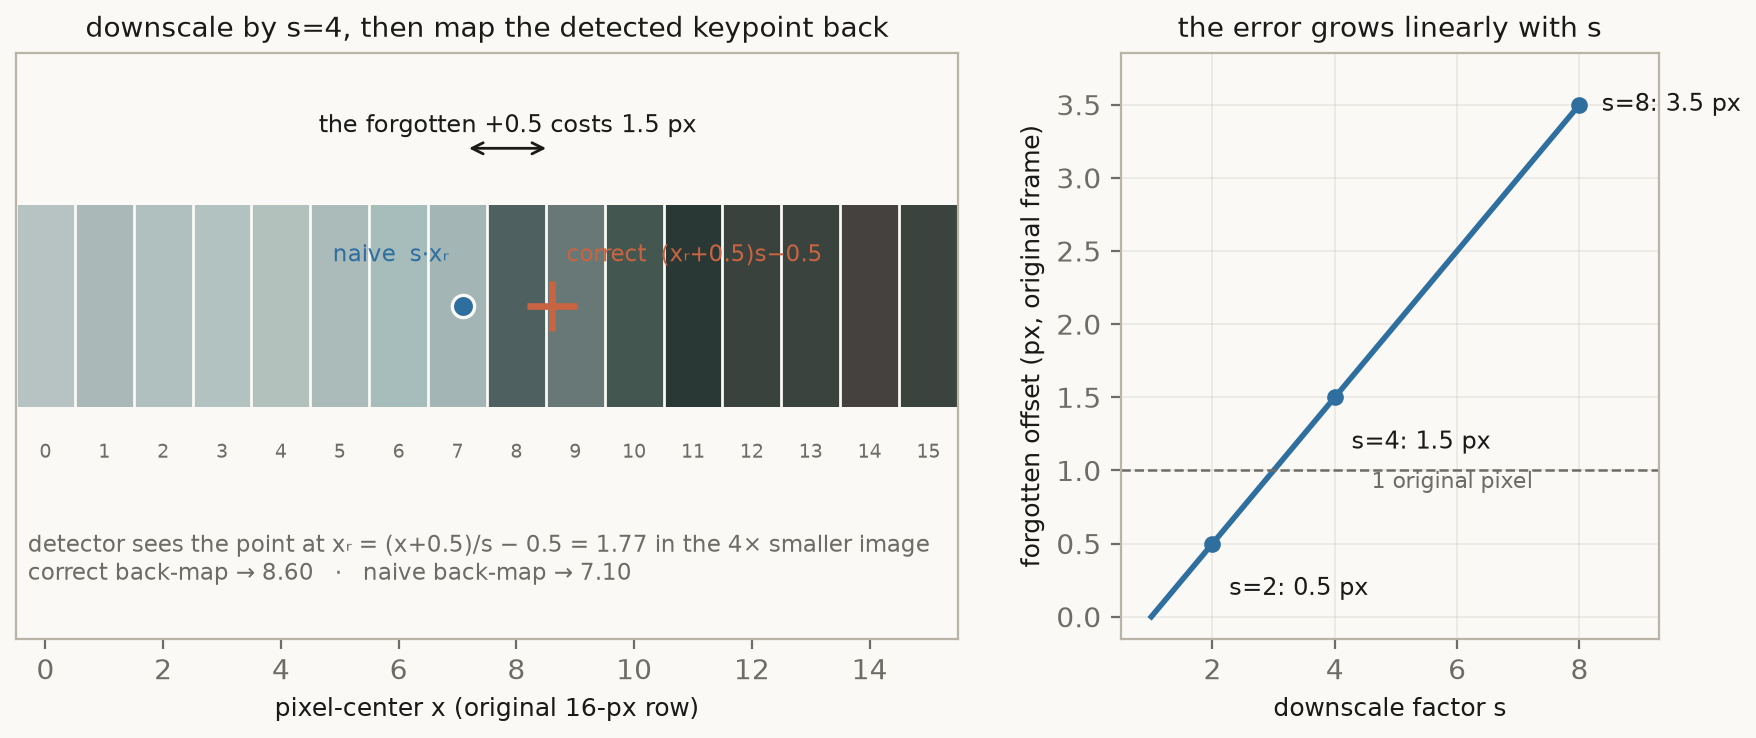
一般的误差公式是:
下面的部件可以拖动 、改变缩小后的宽度,实时看正确回投和朴素回投的间距。
部件 3:橙色是正确回投,蓝色是忘了 +0.5 的朴素回投;两者的间距就是 0.5(s−1)。把 w 拖得越小(s 越大),蓝色点偏得越远。
同一个写法在 hloc 里不止一处。match_dense.py 把匹配器输出的关键点从缩放图映射回原图时,写的是 scale_keypoints(kpts0 + 0.5, scale0) - 0.5;to_cpts() 把关键点量化到 patch 网格时,写的是 round((x+0.5)/ps)*ps - 0.5[9]。前者是坐标缩放,后者是“先换到角点系,对齐网格,再换回来”。理由完全相同。
还有一个更隐蔽的例子:SuperPoint 的描述子采样。hloc 在 extractors/superpoint.py 里替换了上游的 sample_descriptors,并在注释里写明“原版的关键点采样是错的”[8]:
# hloc/hloc/extractors/superpoint.py:14-21
def sample_descriptors_fix_sampling(keypoints, descriptors, s: int = 8):
    b, c, h, w = descriptors.shape
    keypoints = (keypoints + 0.5) / (keypoints.new_tensor([w, h]) * s)
    keypoints = keypoints * 2 - 1
    descriptors = torch.nn.functional.grid_sample(
        descriptors, keypoints.view(b, 1, -1, 2), mode="bilinear", align_corners=False
    )
这里的 keypoints 是原图的中心坐标,w*s 和 h*s 就是原图的宽和高,所以归一化就是
即 align_corners=False 的中心系公式。把描述子图的宽度 代进去,grid_sample 的落点是
正好是同一个点在 倍下采样图里的中心坐标。换句话说,这行“打补丁”的代码同时完成了两件事:把原图坐标换算到缩放图,再用 False 的约定归一化。它和第四节开头那行 (x+0.5)*s-0.5 是同一个映射的两个方向。
五、COLMAP 的 +0.5
第二行代码在三角化里:
# hloc/hloc/triangulation.py:51-54
for image_name, image_id in tqdm(image_ids.items()):
    keypoints = get_keypoints(features_path, image_name)
    keypoints += 0.5  # COLMAP origin
db.write_keypoints(image_id, keypoints)# hloc/hloc/localize_sfm.py:82-83
kpq = get_keypoints(features_path, qname)
kpq += 0.5 # COLMAP coordinates原因就是第一节的角点坐标系。COLMAP 的相机文档写得很直接:
COLMAP uses a corner-based pixel convention, in which the center of the top-left pixel is at
(0.5, 0.5).[3]
而 hloc 从 OpenCV/PyTorch 检测器拿到的关键点是中心系:左上像素的中心是 。所以给 pycolmap 之前统一 。pycolmap 的 Camera.img_from_cam、estimate_and_refine_absolute_pose 都按 COLMAP 的角点系解释坐标;如果不加,它们会把每个点都当成偏了 的点。
这也回答了你说的“COLMAP 中心和 OpenCV 中心不一致”。它们说的是同一个物理中心,只是坐标差 0.5:
对一张 的图,图像中心在 COLMAP 里是 ,在 OpenCV 里是 。这不是谁错了,而是“中心”这个词在两套坐标里的数值不同。
如果混用,会发生什么?把 COLMAP 的内参直接塞进 OpenCV 的 solvePnP,再配 OpenCV 中心系的关键点,主点就偏了 0.5 px;反过来,把 OpenCV 的关键点直接喂给 pycolmap,也是一样。给所有关键点加 ,和给主点加 是完全等价的,因为投影模型是
整体加 0.5,等价于 加 0.5。hloc 选择改关键点而不是改参考模型的内参,是因为参考模型是 COLMAP 的,动一个局部数组比动整个重建的内参更安全。
这个等价关系可以用一个小实验验证。我构造了一个 400 点、、约 旋转的合成场景,用 cv2.solvePnP + LM 精化:
| 输入 | 旋转误差 | 平移误差 | 平均重投影误差 |
|---|---|---|---|
| 正确 | 0 | 0 | 0 |
| 关键点整体 px | px | ||
| 关键点 px,且 也 | 0 | 0 | 0 |
第二行是关键:姿态偏了 ,但重投影误差只有 px。因为优化器把这点平移吸收进了位姿——它找到了一组新的位姿,让投影点整体挪了半格,去贴合被平移过的观测。你盯着重投影误差,是发现不了它的。第三行则说明:只要主点也跟着挪,半像素就完全消失了。这正是“半像素偏差”和“内参不一致”是同一件事的证据。
内参缩放也遵循同样的规律,只是换到中心系后要多一项。设缩放因子 ,主点在中心系下的变换是:
在角点系下则是线性的:
两式是自洽的:。所以 COLMAP 的 resize 代码通常直接把 cx, cy 乘上缩放因子,而 OpenCV 的中心系不能这么干。把图缩小一半,只乘 会让主点偏 px;放大 4 倍只乘 会让主点偏 px。这个误差和 resize 关键点的 是同一个半像素在另一处的化身。
六、半像素会被平均掉吗?
不会——如果它是系统偏差。
随机噪声和系统偏差的区别不在单点大小,而在方向。检测器的定位噪声在每个点上是独立的, 个点的平均按 缩小;半像素偏差对每个点都一样,平均之后还是 0.5 px。下面的部件把两种情形并排画出来:左边每个点都加 px,右边每个点加 px 的独立高斯噪声。每个箭头是一个点的误差向量,从面板原点画出、放大 50 倍;白色虚线是这些向量的平均值。拖动 ,看两边平均值怎么变。
部件 4:网格每格 0.5 px,整体放大 50 倍。左图 N 个箭头完全重合,白色平均值纹丝不动;右图箭头方向随机,白色平均值随 N 按 1/√N 缩短。
这也解释了为什么第 5 节的 PnP 实验里,重投影误差看着只有 px,姿态却偏了 :半像素没有变成“残差”,而是变成了位姿的一部分。单个半像素很小,但它是所有点共享的,不会因为点数多而变小。 时,0.5 px 对应 ; 的 resize 误差是 3.5 px,对应约 。后者才是更值得警惕的那个——它随缩放因子线性增长,图越大、缩得越狠,越明显。
七、±0.5 速查表
表中 是“原图 / 缩放图”(下采样时 ), 是“新图 / 原图”()。用之前先确认两件事: 的方向,以及你手里是中心坐标还是角点坐标。
| 场景 | 已知 | 目标 | 公式 |
|---|---|---|---|
grid_sample 归一化,False | 中心坐标 | 归一化 | |
grid_sample 归一化,True | 中心坐标 | 归一化 | |
grid_sample 反归一化,False | 中心坐标 | ||
grid_sample 反归一化,True | 中心坐标 | ||
| resize 后关键点回投 | 缩放图中心 | 原图中心 | |
| OpenCV → COLMAP | 中心坐标 | 角点坐标 | |
| COLMAP → OpenCV | 角点坐标 | 中心坐标 | |
| 内参 resize(中心系) | |||
| 内参 resize(角点系) | |||
roi_align(aligned=True) | 框坐标 | 像素网格 |
最后一行是检测里的同一个故事:torchvision.ops.roi_align 的 aligned=True 会把框坐标整体减 0.5,文档的说法是“pixel shift the box coordinates by -0.5 for a better alignment with the two neighboring pixel indices”[10]。Detectron2 用它,正是因为 ROI 的坐标原本是按连续图像定义的,而特征图上的像素中心在整数位置;减 0.5 才能让框的边和像素索引对齐。
八、检查清单
下次写涉及坐标的代码时,按顺序问自己下面七个问题;哪一问答不上来,哪里就最容易埋雷。
Q1:我手里的坐标是哪一系?
答:OpenCV/PyTorch 关键点通常是中心系;COLMAP/pycolmap 是角点系;grid_sample(align_corners=False) 的归一化坐标等价于角点系的比例坐标。
Q2:align_corners 是哪一边?
答:用 True 就不要套 ;用 False 就不要套 。
Q3:有没有跨分辨率?
答:任何 resize 之后的关键点回投,统一用 ;不要用 。
Q4:有没有跨库?
答:给 pycolmap 的点 ,给 OpenCV 的点 ;内参也跟着换。
Q5:内参缩放对吗?
答:中心系要加 ,角点系才是直接乘 。
Q6:几个 align_corners 一致吗?
答:interpolate、affine_grid、grid_sample 必须用同一个值。
Q7:重投影误差小就够了吗?
答:不够。半像素会被位姿吸收;用已知几何、闭环或人工构造的平移来验证坐标约定。
如果只记一句话:每次跨过“分辨率边界”或“库边界”,就问一句“这个库的像素中心在哪”。半像素不会大喊大叫,它只会安静地把你的位姿、三角化点和内参一起推偏一点点。
参考
- PyTorch,
torch.nn.functional.grid_sample. - PyTorch,
torch.nn.functional.interpolate. - COLMAP, Camera Models.
- OpenCV,
cv::resize. - hloc,
extract_features.pyL274. - hloc,
triangulation.pyL53. - hloc,
localize_sfm.pyL83. - hloc,
extractors/superpoint.pyL14-L25. - hloc,
match_dense.pyL66-L69. - torchvision,
torchvision.ops.roi_align.