· 85 min read
论文解读:Unified Inertial Encoder,用人体动捕训练类人机器人的惯性感知
TL;DR 类人机器人的惯性感知受限于「机器人自己走过多少路」,而人体动捕数据有几百小时。这篇论文[1]的做法是在输入层做统一:选 12 个解剖对应的身体站点,人体直接用 12 个 IMU(或由运动学生成的虚拟 IMU),G1 类人机器人则用骨盆 IMU + 关节编码器 + URDF 通过刚体传输「合成」出其余站点的 IMU;再用固定 125 ms 的连续时间分词器抹平 60–1000 Hz 的采样率差异,用交替的站点内/全站点注意力做速度、去噪、语言对齐和轨迹四项监督。一个 checkpoint 在五个数据集的骨盆速度误差上全部最低——Nymeria 0.026 m/s、重定向 G1 0.024 m/s、真机 G1 0.099 m/s,而且没有用真机轨迹训练或微调。语言检索在只在人体数据里出现过的 G1 动作类别上 R@1 53.8%(IMU2CLIP 17.3%)。代码与权重已开源(Apache 2.0),训练数据需按各数据集协议自行获取。
- 论文:A Unified Inertial Encoder for Human and Humanoid Motion,Yutian Chen、Shibo Zhao、Rocky Duan、Karen Liu、Carmelo Sferrazza、Guanya Shi、Yuheng Qiu、Koushil Sreenath,Amazon FAR / UC Berkeley / Stanford / CMU,arXiv 2026 年 11 月 6 日。
- 代码:amazon-far/Unified-Inertial-Encoder(Apache 2.0);权重 Open-IO/Unified-Inertial-Encoder;项目主页。
- 数据:Nymeria、Natural Motion、BONES-SEED(训练);真机 G1 评测片段 humanoid-g1-odometry。
- 背景:站内 SSIO 与 IMUDINO 讨论 IMU 自监督表征,可先看那篇了解「IMU 也能做基础模型」这条线;Human2Humanoid 讨论人体到人形的运动重定向,本文与它的区别见 §1。
一、动机:类人机器人的数据缺口,卡在「接口」而不是模型
类人机器人的状态估计有一个循环依赖:可靠的行走控制需要准确的惯性里程计,而用机器人自己的记录训练里程计,又只能覆盖现有控制器会做的动作。控制器的动作库越保守,训练数据越窄,估计器在真正需要的时候越容易失效。人体动捕恰好能打破这个循环——Nymeria 有 300+ 小时、BONES-SEED 有 144 小时,图 1 左侧的说法是 500+ 小时、3500+ 种动作[2, 3]。问题是这些数据不是给类人机器人准备的。
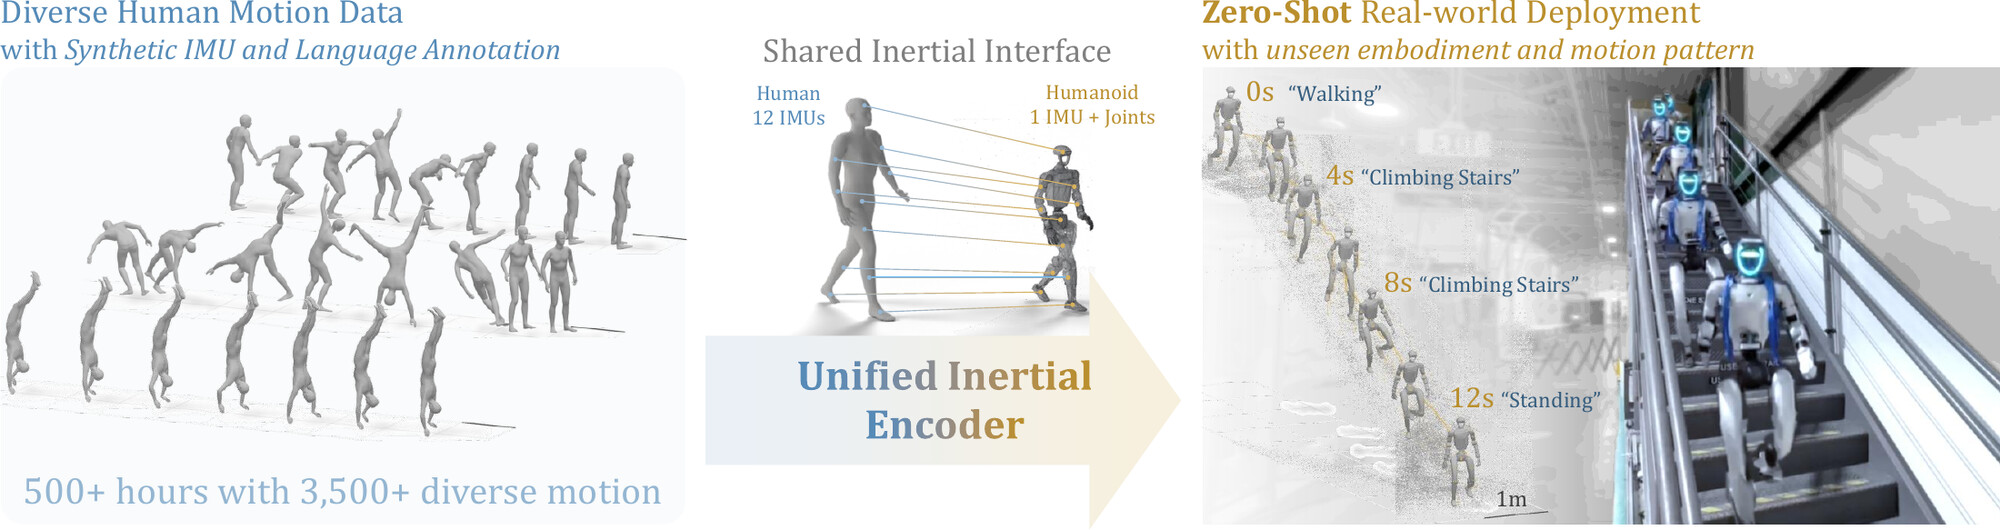
差异有四层:几何(连杆长度、关节定义不同)、传感(人体是 12 个物理 IMU,机器人是 1 个骨盆 IMU 加关节编码器)、坐标约定(每个数据集的传感器轴定义都不一样)、采样与时序(60、120、200、240、1000 Hz 都有,还有丢包和不规则时间戳)。把人体动作重定向到 G1 只能解决第一层——它给出运动学,但给不出 IMU 信号。而合成出来的 IMU 又不包含接触、结构振动、冲击和传感器缺陷,直接拿它训练会在真机上崩掉。
现有路线各自覆盖了一部分:
- 学习式惯性里程计(TLIO[4]、AirIMU[5]、AirIO[6])在一个平台或数据集上训练,换平台就要重训;泛化能力取决于训练覆盖。
- 跨平台 IMU 基础模型(TartanIMU[7])用多平台数据预训练加微调/在线适应,但输入仍是单个骨盆 IMU,没有利用类人机器人的关节运动学。
- 语言对齐的 IMU 表征(IMU2CLIP[8]、ImageBind[9]、SensorLM[10])面向人体可穿戴设备,任务停在识别与检索,既不预测速度,也没验证过向类人机器人的迁移。
- 人体到人形的运动迁移(H2O、OmniH2O、HumanPlus、Human2Humanoid[11])把重定向后的参考动作或控制策略搬过去,迁移发生在控制层;本文想迁移的是传感层的运动知识。
论文的贡献可以概括成三条:人体运动能提升类人机器人的惯性里程计,并支持不做真机训练/微调的零样本迁移;共享惯性接口通过运动学 IMU 合成把具身几何嵌入输入,连续时间编码抹平采样率差异;语言对齐的 IMU 特征空间支持动作描述检索,包括只在人体数据里出现过的 G1 动作类别。
我的理解是:这篇论文的核心不是新 backbone,而是接口。模型结构(Transformer + 多任务 head)单看并不稀奇;真正让 500 小时人体数据变得可用的是「把任何具身都变成 12 路解剖对应 IMU」这一步。下面的方法部分按这条线展开。
二、核心方法
2.1 问题定义与总体架构
记 为人体与类人机器人共享的解剖站点集合,本文取 12 个:骨盆、头、左右上臂、左右前臂、左右大腿、左右小腿、左右脚。对站点 ,一个时间窗内的输入是带时间戳的序列
其中 是包含重力贡献的比力(specific force), 是角速度,都在传感器局部坐标系里。序列长度 随传感器采样率和丢包变化,这正是后面要用连续时间编码处理的东西。模型对每个站点、每个输入时刻预测体坐标系线速度 (骨盆速度即根速度),同时把整个窗口映射到与冻结文本特征对齐的 。辅助任务是从受扰动的输入重建无重力运动学加速度 和干净角速度 。
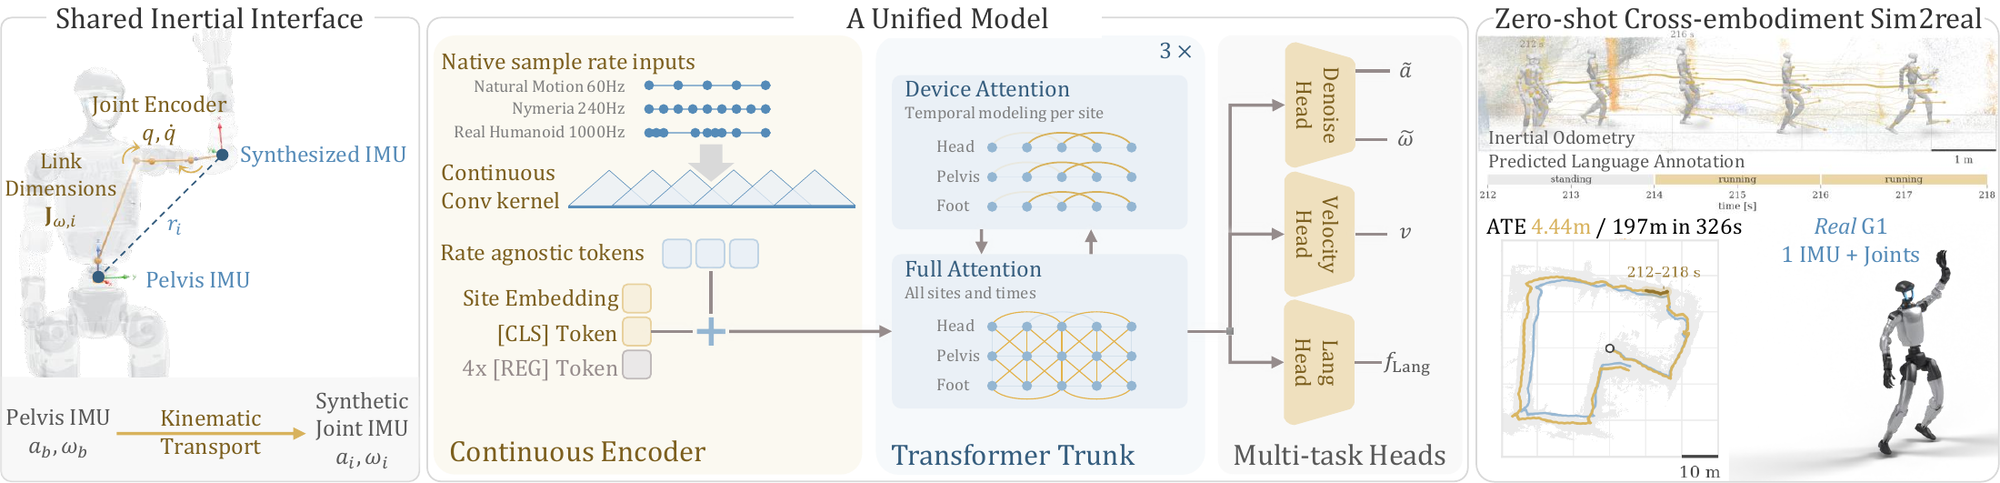
一个 4 s、200 Hz、12 路 IMU 的窗口,在代码里是每站点 32 个 token,加 1 个 [CLS] 和 4 个 register,共 个 token。三个解码头都从主干第 1、3、5 层的输出拼接读取(feature_from_trunk: [1, 3, 5]),所以每个头看到的是「局部站点特征 + 中层 + 全站点特征」的 2304 维表示。
2.2 共享惯性接口:把关节编码器变成 12 路虚拟 IMU
人体侧的 12 路来自 Xsens 之类的动捕套装。官方代码里保留了 17 个规范站点,然后用 DeterministicDropDevice 固定丢掉 torso_t8、左右肩、左右手,剩 12 个——这样所有人体语料共享同一个布局。
G1 侧没有 12 个物理 IMU。它只有骨盆上的一个 IMU,加上关节编码器给出的关节角 和关节角速度 。论文用刚体运动学把骨盆测量传输到各个连杆:
这里 把连杆 的向量转到骨盆坐标, 是连杆原点相对骨盆的位置及其导数, 是连杆在骨盆坐标下的角雅可比。四项加速度分别是切向()、向心()、科里奥利()和连杆相对加速度()。公式里没有世界位姿、没有根速度,因为所有量都在 URDF 根坐标系里算——这是它能在真机上实时用的关键。
另一个容易被忽略的点是重力约定:输入是比力,输出也保持比力。无重力的运动学输入合成出无重力的连杆加速度,实测比力则把重力一路带到每个连杆。这样人体和机器人的 12 路信号在物理含义上才对得上。
不同数据集的传感器轴定义不同,所以还要做一次坐标对齐。对每个站点,先用关节位置构造解剖坐标系,估计传感器相对它的平均朝向,再与 Xsens 参考朝向比较,得到固定旋转 :
世界位置不变。重定向 G1 和真机 G1 用同一个修正。注意这在真机上的含义:12 路是虚拟 IMU,由 1 个骨盆 IMU 和关节编码器实时合成;它和人体 12 个物理 IMU 的对应是解剖学上的,不是硬件上的。如果关节编码器失效,这个接口就退回单骨盆 IMU——Table V 里那条路线的真机 ATEGT 是 8.114 m,而完整接口是 3.153 m。
代码:运动学 IMU 合成(官方 src/interface/data_humanoid.py,原文节选)
def _synthesize_imu_fields(
    model        : ArticulatedModel,
    time_ns      : jt.Int64[torch.Tensor, "B T 1"],
    joints       : jt.Float[torch.Tensor, "B N T 1"],
    joint_d      : jt.Float[torch.Tensor, "B N T 1"],
    base_acc     : jt.Float[torch.Tensor, "B T 3"],
    base_gyro    : jt.Float[torch.Tensor, "B T 3"],
    base_frame   : str,
    target_frames: tp.Sequence[str],
    sensor_ids   : tp.Sequence[int],
    imu_model    : ArticulatedModel,
    kind         : tp.Literal["real", "filtered-no-g", "sim"],
    gyro_deriv_window_s: float = 0.0,
    joint_dd_window_s  : float = 0.0,
) -> dict:
    """Synthesize rigid-body IMU readings at `target_frames` from a base IMU plus joint state.

    Everything runs in the URDF-root frame ``u``, so world pose, base velocity and gravity direction
    are never needed. With ``phi_b = R_ub f_b``:

        w_u    = R_ub gyr_b - J_w,b q_dot
        al_u   = (J_w,b q_dot) x (R_ub gyr_b) + R_ub gyr_b_dot - (J_w,b q_ddot + J_dot_w,b q_dot)
        gyro_m = R_um^T (w_u + J_w,m q_dot)
        acc_m  = R_um^T (phi_b + al_u x (r_m - r_b) + w_u x (w_u x (r_m - r_b))
                         + 2 w_u x (r_dot_m - r_dot_b) + (r_ddot_m - r_ddot_b))

    `base_acc`/`base_gyro` are at `base_frame`'s origin, in its axes, time-aligned to `time_ns`.
    `gyro_deriv_window_s`/`joint_dd_window_s` are half-widths of the stencils for ``gyr_b_dot`` and
    ``q_ddot`` (from ``joint_d``); ``<= 0`` means a 2-sample central difference.
    Every output keeps `base_acc`'s gravity convention (specific force in, specific force out), so
    `kind` must match the input. Call in time-chunks for long sequences.
    """
    assert (
        model.chain             is not None
        and model.joint_perm    is not None
        and model.link_names    is not None
        and model.serial_chains is not None
    )
    assert base_frame in model.link_names, f"{base_frame} is not a link of the model"
    for f in target_frames:
        assert f in model.link_names, f"{f} is not a link of the model"
    assert len(sensor_ids) == len(target_frames) == imu_model.num_joint

    B, N, T, _ = joints.shape
    assert T >= 2, "as_imu requires at least two timesteps to differentiate the base gyro"
    device, dtype = joints.device, joints.dtype
    n_tgt = len(target_frames)

    chain = model.chain.to(device=device, dtype=dtype)
    perm  = model.joint_perm.to(device)

    q_tm  = joints.squeeze(-1).transpose(1, 2)                              # (B, T, N)
    qd_tm = joint_d.squeeze(-1).transpose(1, 2)                             # (B, T, N)

    q_bt   = q_tm.reshape(B * T, N)
    qd_bt  = qd_tm.reshape(B * T, N)
    qdd_bt = _windowed_time_derivative(qd_tm, time_ns, joint_dd_window_s).reshape(B * T, N)

    transforms = chain.forward_kinematics(q_bt[:, perm])
    def frame_matrix(name: str) -> torch.Tensor: return transforms[name].get_matrix()  # (BT, 4, 4)

    T_ub       = frame_matrix(base_frame)
    R_ub, p_ub = T_ub[:, :3, :3], T_ub[:, :3, 3]
    rdot_b, w_rel_b, rddot_b, alpha_rel_b = _link_relative_kinematics(
        model, base_frame, q_bt, qd_bt, qdd_bt, device, dtype)

    f_b        = base_acc.reshape(B * T, 3)
    gyr_b      = base_gyro.reshape(B * T, 3)
    gyr_b_dot  = _windowed_time_derivative(base_gyro, time_ns, gyro_deriv_window_s).reshape(B * T, 3)

    gyr_u = (R_ub @ gyr_b.unsqueeze(-1)).squeeze(-1)                        # base gyro in u frame
    w_u   = gyr_u - w_rel_b                                                 # URDF-root angular velocity
    al_u  = (
        torch.linalg.cross(w_rel_b, gyr_u)
        + (R_ub @ gyr_b_dot.unsqueeze(-1)).squeeze(-1)
        - alpha_rel_b
    )                                                                       # URDF-root angular acceleration
    phi_b = (R_ub @ f_b.unsqueeze(-1)).squeeze(-1)                          # base accelerometer in u frame
真机 G1 的数据读取器(src/data/imu/g1_superodom.py)把 gyro_deriv_window_s 和 joint_dd_window_s 设成 0.031 s:角加速度和关节角加速度都不是两点差分,而是在 ±31 ms 的窗口上拟合。这会平滑掉一部分高频冲击,也意味着合成信号的时间分辨率有一个下界。
拖一拖看什么:杠杆臂上的向心与切向加速度到底有多大。默认值 rad/s、 rad/s²、 m 时,两项合起来已经超过 ;这也解释了为什么不能简单把骨盆 IMU 当成全身运动。
2.3 连续时间分词:token 按 125 ms 切,不按样本数切
多语料训练最脏的地方是采样率:Natural Motion 60 Hz、BONES-SEED 120 Hz、Nymeria 240 Hz、真机 G1 200 Hz、某些机器人流到 1000 Hz。如果把「若干个连续样本」当成一个 token,同一个 token 的物理时长会随采样率变化——消融里用的固定样本 patch 是 25 个样本,在 60 Hz 下覆盖 417 ms,在 1000 Hz 下只覆盖 25 ms,同一层网络的感受野差了 16 倍。重采样到统一网格又会在 60 Hz → 240 Hz 时引入插值伪影,在 240 Hz → 60 Hz 时丢信息。
论文的做法是两层连续卷积。第一层把每个站点的原始样本池化成 ms 的微窗口,第二层再池化成 125 ms 的 token;每层用 个线性 B 样条基函数。对窗口 (起点 、时长 )内的样本 ,归一化时间 ,第 个 tap 的池化特征是
其中 是中心均匀分布的线性 B 样条权重。分母是权重质量,会被 clamp_min(1e-6) 保护;某个 tap 没有样本时不会除零,也不会把零当成有效观测。关键细节是 的分母是固定的 bin 宽,不是「窗口内第一个到最后一个样本的跨度」——这样卷积核在任何采样率下都是平稳的(stationary),不会因为丢包把核拉伸。
空 bin 会被直接丢掉(_segment_windows 的注释写得很清楚),窗口也永远不会跨过一个 batch 边界。对损失来说这是好事:丢包的时间段不会产生一个「全是零」的假 token;对部署来说,固定 125 ms 的 token 数只取决于窗口时长,4 s 就是 32 个。
这里和 CKConv[12] 的关系值得说清:论文引用了 CKConv 作为连续卷积的来源,但官方实现不是 CKConv 的隐式 MLP 核,而是「三角基池化 + 线性混合」的 KPConv 式做法(代码 docstring 原话是 “KPConv-style blending, not CKConv’s implicit-MLP kernel”)。两者都属于连续核卷积,差别在核的参数化方式。
代码:连续卷积的单层前向(官方 src/model/template/continuous.py,原文照录)
    def forward(
        self,
        x          : jt.Float[torch.Tensor, "pack_BNT C_in"],
        u          : jt.Float[torch.Tensor, "pack_BNT"     ],   # designated window-relative time in [0, 1)
        window_id  : jt.Int64[torch.Tensor, "pack_BNT"     ],
        num_windows: int,
    ) -> jt.Float[torch.Tensor, "pack_BNW C_out"]:
        assert x.shape[-1] == self.in_dim, f"conv in_dim {self.in_dim} != input C ({x.shape[-1]})"
        W = num_windows

        # Each sample hits only its two adjacent taps; the ones column accumulates the weight mass.
        ui     = u / self.width                                                 # in [0, m-1]
        k0     = ui.floor().clamp_(0, self.num_taps - 2).long()
        frac   = (ui - k0).unsqueeze(-1).to(x.dtype)
        rows   = window_id * self.num_taps
        aug    = torch.cat([x, x.new_ones(x.shape[0], 1)], dim=-1)
        buf    = x.new_zeros(W * self.num_taps, self.in_dim + 1)
        buf.index_add_(0, rows + k0,     (1.0 - frac) * aug)
        buf.index_add_(0, rows + k0 + 1, frac * aug)
        pooled = buf[:, :self.in_dim] / buf[:, self.in_dim:].clamp_min(1e-6)    # [W*m, in] weighted mean
return self.proj(pooled.reshape(W, self.num_taps * self.in_dim))拖一拖看什么:同一段 1 秒信号,在连续模式(固定 125 ms)与离散模式(固定 25 个样本)下 token 的时长差多少。把采样率从 240 Hz 拉到 60 Hz,离散 token 的跨度从 100 ms 变成 400 ms;中间那段丢包会让离散 token 跨过缺口。连续模式的 token 始终是 125 ms,丢包只会让某个 bin 变空并被丢弃。
消融数字很硬:去掉连续时间编码、改回固定样本 patch,Nymeria 的 ATEGT 从 2.468 m 涨到 31.42 m,重定向 G1 从 0.101 m 涨到 1.189 m,真机 G1 从 3.153 m 涨到 17.37 m。这是 Table V 里差距最大的一行,也是我认为全文最值得复用的设计。
2.4 交替注意力主干与多尺度读出
12 路信号有两条组织轴:同一站点沿时间,以及同一时刻跨站点。全注意力把两者混在一起算,token 数是 ,注意力矩阵是 ;站点内注意力只让每个站点的 32 个 token 互相看,跨站点交互交给下一层。主干的 6 层就按 ["device", "full", "device", "full", "device", "full"] 交替:奇数层做站点内时间建模,偶数层做全站点全时间建模。
代码里这两种模式通过不同的 offset 数组实现:device 层传 n_offsets(每个站点的 token 段),full 层传 b_offsets(整个样本的 token 段)。站点嵌入在编码器输出后加一次,用来区分解剖位置;[CLS] 和 4 个 register token 由分词器插入,[CLS] 单独形成一个「设备」段,所以站点内注意力不会把它和真实站点混在一起,register 则给全局注意力提供不绑定具体输入的容量。位置编码用基于时间的 RoPE:代码里周期从 1 ms 到 100 s(ROPE_T_MIN_MS = 1.0,ROPE_T_MAX_MS = 100_000.0),这样 token 之间的相对时间在任意采样率下都有意义。
三个解码头不是只读最后一层,而是把第 1、3、5 层的输出沿通道拼接。第 1 层刚做完站点内注意力,保留较多局部运动细节;第 5 层已经过多轮跨站点交互,语义更强。拼接后每个头得到 2304 维特征,再按 chunk 做 LayerNorm 后接各自的 MLP。
代码:交替注意力的前向与多尺度读出(官方 src/model/transformer.py,原文节选)
    def forward(
        self,
        x           : jt.Float[torch.Tensor, "pack_BNS C"],
        b_offsets   : jt.Int64[torch.Tensor, "B+1"],
        n_offsets   : jt.Int64[torch.Tensor, "N+1"],
        timestamp   : jt.Float[torch.Tensor, "pack_BNS"],
        frame       : jt.Int64[torch.Tensor, "pack_BNS"] | None = None,
        feature_from: Sequence[int] | None = None,
    ) -> jt.Float[torch.Tensor, "pack_BNS kC"]:
        # ``feature_from``: block indices whose outputs are channel-concatenated; None returns the last block.
        taken: list[torch.Tensor] = []
        for idx, (layer_type, block) in enumerate(zip(self.layer_type, self.blocks)):
            match layer_type:
                case "device":
                    x = block(x, n_offsets, timestamp)
                case "full":
                    x = block(x, b_offsets, timestamp)
            if feature_from is not None and idx in feature_from:
                taken.append(x)

        if feature_from is None:
            return x
        return torch.cat(taken, dim=-1)
但消融并不支持「交替注意力是关键设计」这个说法。Table V 里去掉它之后,Nymeria 的 ATEGT 是 2.466 m,和完整模型的 2.468 m 打平,ATEPred 反而更好(14.31 m vs 18.20 m);BONES-SEED G1 从 0.101/0.127 变成 0.110/0.128,真机 G1 从 3.153/11.50 变成 3.530/11.71,只有类人机器人上的小幅恶化。论文自己的措辞也是 “modestly improves humanoid odometry… gains on Nymeria are mixed”。所以它是合理的工程折中(省算力),不是性能来源;真正撑起结果的是接口和连续时间编码。
2.5 四项监督与梯度范数自动配平
总损失是四项的加权和:
速度:对每个站点、每个输入时刻预测体坐标系速度,监督是速度误差的欧氏范数均值(和评测的 AVE 同一定义)。代码里把样本分成 masked / unmasked 两条路径,分别加权,这样去噪任务和速度任务可以共用同一个 batch 的不同标签位。
轨迹:光有逐点速度不够,积分会漂。论文用预测的去噪角速度 做四阶 Runge–Kutta 积分,从真值初始姿态出发得到 ,再把 用梯形法积分成世界位置。然后在 0.25 s、1 s、2 s 三种时长上取不重叠的区间,比较预测位移与真值位移:
位移在各自轨迹的起始坐标系里比较(evo RPE 的约定),所以姿态误差会像评测指标那样耦合进位移误差。梯度在姿态这一步被 detach 掉,轨迹损失只训练速度头;如果把 detach_rotation 设成 False,梯度也会经姿态链回到陀螺头。
这里有一处论文与代码的细节差异:式 (6) 是「位移误差平方除以 」(单位 m²/s),而 Trajectory_Velocity_Loss 先把误差除以 再平方(_horizon_term(rte / dt, ...) → rte_rate.square(),单位 m²/s²),也就是优化的量是漂移速率的平方。两者对短时窗的加权不同,代码对 0.25 s 窗口的权重比论文公式更重。复现时以代码为准。
语言:把窗口的 [CLS] 特征回归到冻结 CLIP ViT-L/14@336px 文本编码器的 768 维嵌入[13],损失是 。官方实现特意说明这是回归而不是对比学习:语言标注的词汇量小而重复,batch 内的负样本很多是假负样本。只有被单条语言标注完整覆盖的窗口才参与这项监督,其余窗口仍然贡献运动与去噪损失。
去噪:输入加了重力与各种扰动,目标是无重力的运动学加速度和干净角速度;两项都取平均欧氏误差。这项损失同时充当自动配平的锚点。
自动配平: 固定,速度和轨迹的权重按「去噪损失与任务损失在共享特征层的梯度范数比」做 EMA(衰减 0.99),再裁剪到 。共享特征层是一个标量 GradientProbe,所有损失都对它求梯度,范数比才有可比性;如果某个损失被标签位关掉、梯度为 None 或全零,代码把它标成 NaN 而不是用 兜底,避免把系数顶到裁剪上界。这是一个「fail loudly」的实现:缺锚点时所有系数都变 NaN,而不是悄悄用一个默认值。
代码:速度损失与轨迹损失的积分(官方 src/model/loss.py,原文节录)
    def forward(
        self,
        model    : FoundationIMU,
        data     : IMUData_w_GT_Jagged,
        pred     : FoundationIMU_Output
    ) -> tuple[torch.Tensor, dict[str, float]]:
        # gt_vel and dec_body_vel are both body-frame, so they are directly comparable.

        # Graph-connected zero: see Denoise_Loss.
        applies = (data.labels.to(torch.int64) & int(self.LABEL)) != 0
        if not bool(applies.any()):
            return pred.dec_body_vel.float().sum() * 0.0, {}
        gate = torch.repeat_interleave(applies, data.offsets_N.diff())

        mask_samp =  pred.mask_samp[gate]
        copy_samp = ~pred.mask_samp[gate]

        vel_l1 = (data.gt_vel[gate] - pred.dec_body_vel[gate]).norm(dim=-1)

        # Huber drives the gradient; the metrics below still report the plain L1 error.
        vel_grad = vel_l1 if self.huber_delta is None else \
            F.huber_loss(vel_l1, torch.zeros_like(vel_l1), delta=self.huber_delta, reduction="none")

        grad_mask = vel_grad[mask_samp].mean()
        grad_copy = vel_grad[copy_samp].mean()

        match self.unmasked_weight, self.masked_weight:
            case None, None: raise ValueError("Must enable at least one compute path")
            case None, mw   :
                loss = mw * grad_mask.nan_to_num()
            case cw   , None:
                loss = cw * grad_copy.nan_to_num()
            case cw  , mw  :
                loss = cw * grad_copy.nan_to_num() + mw * grad_mask.nan_to_num()

        recon_vel_loss = vel_l1[mask_samp].mean()
        copy_vel_loss  = vel_l1[copy_samp].mean()
        metric  = {"loss" : loss.item()} \
                | ({} if torch.isnan(recon_vel_loss) else {"recon/vel_loss" : recon_vel_loss.item()}) \
                | ({} if torch.isnan(copy_vel_loss)  else {"copy/vel_loss"  : copy_vel_loss.item()})

        return loss, metric
代码:轨迹损失里的 RK4 姿态预积分(官方 src/model/loss.py,原文照录)
    def _integrate(self, data, pred, applies, sub2full, sub_offn, run, gt_rot):
        with torch.no_grad() if self.detach_rotation else nullcontext():
            gyro   = pred.dec_correct_gyro[sub2full].to(self.dtype)
            pack   = _channel_pack(data, applies, sub2full, sub_offn, torch.zeros_like(gyro), gyro)
            preint = self.preintegrate(pack, dtype=self.dtype)   # acc slot inert: only Dr is used
            Dr, *_ = _aligned_prefixes(preint, sub_offn)
        R_hat = pp.SO3(quaternion_multiply(gt_rot.tensor()[sub_offn[:-1]][run], Dr))
        v_b   = pred.dec_body_vel[sub2full].to(self.dtype)
        xyz   = integrate_trajectory(v_b, R_hat, data.time_ns[sub2full], sub_offn)
        return xyz, R_hat

    def _horizon_term(self, rte_rate: torch.Tensor, roe_rate: torch.Tensor) -> torch.Tensor:
        del roe_rate   # attitude is frozen context here, never a training target
        return self._rte_term(rte_rate)
代码:按梯度范数自动配平损失权重(官方 src/model/loss.py,原文照录)
    def normalization_factor(self, model: FoundationIMU, loss: dict[str, torch.Tensor]):
        # Only 'auto' losses are probed, plus the anchor as the norm reference.
        grads = {
            name : torch.autograd.grad(
                l, model.grad_probe.weight,
                retain_graph=True, create_graph=False, allow_unused=True,
            )[0]
            for name, l in loss.items()
            if self.active[name] and (self.scale[name] == "auto" or name == self.anchor)
        }
        # A gated-off loss has a None or exactly-zero probe grad. Mark it NaN, not the 1e-6 floor that would
        # blow the factor to the clamp ceiling, so it is neither folded into the EMA nor logged. An absent
        # anchor makes every factor NaN.
        raw_grad_norm_dict = {
            name : (float("nan") if g is None or not bool(g.any()) else g.detach().norm(p=2).item())
            for name, g in grads.items()
        }
        grad_factor = {
            name : (float("nan") if (g is None or grads[self.anchor] is None)
                    else raw_grad_norm_dict[self.anchor] / (raw_grad_norm_dict[name] + 1e-6))
            for name, g in grads.items()
        }
        # Keep the prior value for a loss absent this step, so NaN never poisons its EMA.
        prev = self.factor or {}
        self.factor = dict(prev)
        for name, gf in grad_factor.items():
            if math.isnan(gf): continue
            self.factor[name] = (
                (self.ema * prev[name]) + ((1 - self.ema) * gf)
                if (name in prev) else gf
            )
        self.factor[self.anchor] = 1.0
        self.factor = {
            name : max(self.range[0], min(value, self.range[1]))
            for name, value in self.factor.items()
        }

        # For logging only; forward() reads the NaN-free self.factor.
        step_factor = {
            name : (float("nan") if math.isnan(gf) else self.factor[name])
            for name, gf in grad_factor.items()
        }
        return raw_grad_norm_dict, step_factor
2.6 传感器与运动随机化:补上运动学数据没有的硬件效应
运动学合成给出的是「理想 IMU」:没有接触反力、没有结构振动、没有脚落地冲击、没有陀螺零偏游走。真机 G1 的评测不做任何增广,所以训练时必须把这些效应造出来。Table I 是全部范围:
| 类别 | 参数 | 设置 |
|---|---|---|
| 运动与采样 | 重力大小 | m/s² |
| 身体尺度 | (人)/ (G1) | |
| 运动速度 | (人)/ (G1) | |
| 人体采样率 | 目标 Hz | |
| 时间戳抖动 | 相邻间隔的变异系数目标 | |
| 传感器噪声 | 加速度噪声密度 | |
| 陀螺噪声密度 | ||
| 机械扰动 | 振动 | 基础 RMS 0.3–3.0 m/s² |
| 冲击 | 基础峰值 3–30 m/s² |
「基础值」的意思是还要再调制:振动用若干 Lorentzian 模态叠加,陀螺上乘包络,3 Hz 高通;冲击用阻尼正弦,到达时间按 Poisson 过程采样;此外还有零偏随机游走。身体尺度和时间扰动会一致地作用到输入和目标上,去噪目标本身保持无重力、无噪声。验证集保留噪声注入但去掉尺度与时间扰动——这样验证指标反映的是「有噪声、但几何正常」的条件,和真机评测更接近。
这些范围是启发式的:一部分来自常见传感器规格,一部分是为了覆盖「合理工况」而人为放宽。论文没有对随机化做消融,所以无法判断哪一项对真机迁移贡献最大;这是我后面会提的一个局限。
三、实验结果
3.1 数据与训练设置
| 数据集 | 具身 | 运动来源 | 频率 | 小时 | 语言 | 用途 |
|---|---|---|---|---|---|---|
| Nymeria | 人 | 真实动捕 | 240 Hz | 300+ | ✓ | 训练 + 评测 |
| Natural Motion | 人 | 真实动捕 | 240 Hz | 40.6 | – | 训练 + 评测 |
| BONES-SEED | 人 | 真实动捕 | 120 Hz | 144 | ✓ | 训练 + 评测 |
| BONES-SEED | G1 | 运动学重定向 | 120 Hz | 144 | ✓ | 训练 + 评测 |
| Real-Trajectory | G1 | 真实 IMU | 200 Hz | 0.7 | – | 仅评测 |
人体数据按轨迹做 85%/15% 的训练/验证划分;重定向 G1 用语言描述把简单动作(走、站)和复杂动作(跳舞等)分开,简单动作按同样比例划分,所有复杂轨迹都留作未见评测集。留出的 G1 轨迹可能在人体训练集里有对应动作,这正是「人体到人形」迁移的测试点。
训练用 4096 ms 窗口、bfloat16、batch 1024(8 卡 × 128),20 个 epoch(配方总长 64 个 epoch,论文报告的是第 20 个 epoch、step 6420 的 EMA 权重),Muon 更新矩阵参数(学习率 ),AdamW 更新其余参数(),EMA 权重 0.95。模型 55.6M 参数。
基线方面:TLIO、AirIMU、AirIO 在每个数据集上单独训练,输入只有骨盆 IMU;TartanIMU 用发布的人体 head;为了控制「额外信息」这个变量,作者还把 AirIO 加上相对关节位置和速度(AirIO w/ joints),它拿到的信息不比本文的合成 IMU 少。语言任务上,IMU2CLIP 按数据集训练、用骨盆 IMU;ImageBind 用预训练权重、输入头部 IMU。
3.2 惯性里程计:五个数据集的最低速度误差
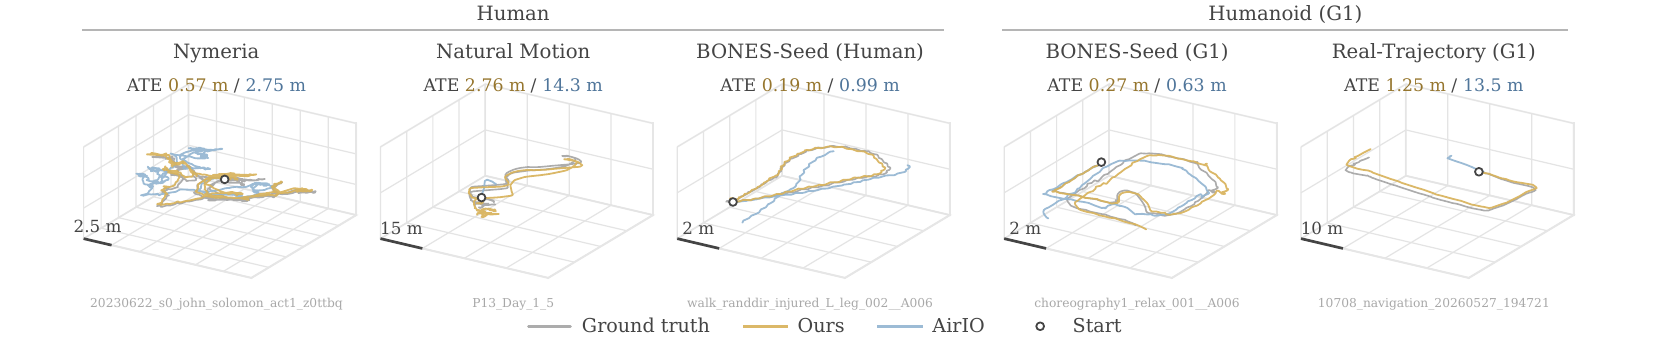
Table III 是全文的主表。指标有三个:AVE(骨盆速度的平均欧氏误差,m/s)、ATEGT(用真值姿态积分预测速度得到的轨迹误差,m)、ATEPred(用陀螺积分姿态,测试时不用真值姿态)。三个都是越低越好。
具体看数字。AVE 在五个数据集上全部最低:Nymeria 0.026、Natural Motion 0.049、BONES-SEED 人 0.031、重定向 G1 0.024、真机 G1 0.099 m/s。和拿到同样关节信息的 AirIO w/ joints 比,对应是 0.060 → 0.026、0.080 → 0.049、0.205 → 0.031、0.123 → 0.024、0.190 → 0.099。和单 IMU 最强的基线比,真机 G1 上 AirIO 是 0.350,本文是 0.099,接近 3.5 倍差距。
ATEGT 也全部最低:2.468、7.456、0.113、0.101、3.153 m。这条指标剥离了姿态误差,只反映速度积分后的漂移,所以它和 AVE 的结论一致并不奇怪。
ATEPred 是另一回事:本文在四个数据集上最好,但 Nymeria 上 TLIO 的 17.76 m 略优于本文的 18.20 m;而且所有方法的 ATEPred 都比 ATEGT 大一个量级以上(真机 G1:11.50 vs 3.153 m)。论文明确承认「orientation drift remains a limitation」。这也说明这套系统是纯惯性积分,没有滤波更新、没有回环、没有外部观测;真机上要闭环使用,必须和滤波器或别的传感器融合。
3.3 语言检索与跨具身语义迁移
语言任务有两个方向:给定 IMU 窗口从 19 个随机干扰项里找对应描述(R@1),以及给定文本查询对窗口排序(mAP)。评测集里有一列是「只在人体训练中出现过的 G1 动作类别」——这是检验语义能否跨具身迁移的关键。下表每格是 R@1 / mAP(%)。
| 方法 | Nymeria | BONES-SEED 人 | G1 已见 | G1 未见 |
|---|---|---|---|---|
| Collapse(常数嵌入) | 4.4 / 0.1 | 19.7 / 0.2 | 21.9 / 0.8 | 9.8 / 0.1 |
| ImageBind | 8.9 / 0.1 | 7.1 / 0.4 | 11.4 / 1.6 | 4.6 / 0.1 |
| IMU2CLIP† | 16.2 / 0.4 | 51.8 / 5.2 | 36.1 / 11.2 | 17.3 / 0.5 |
| Ours | 14.9 / 0.6 | 60.7 / 15.9 | 63.4 / 32.9 | 53.8 / 11.3 |
† 每个数据集单独训练。Collapse 是一个「不看 IMU、所有窗口都用评测文本均值」的基线,用来衡量常数表征能拿到多少分。
本文在 BONES-SEED 人体和两个 G1 划分上都领先两个指标;在最能说明问题的「G1 未见类别」上,R@1 53.8% 对 IMU2CLIP 的 17.3%,mAP 11.3% 对 0.5%。Nymeria 上 IMU2CLIP 的 R@1 更高(16.2% vs 14.9%),但 mAP 更低(0.4% vs 0.6%)——论文如实报告了这一点。
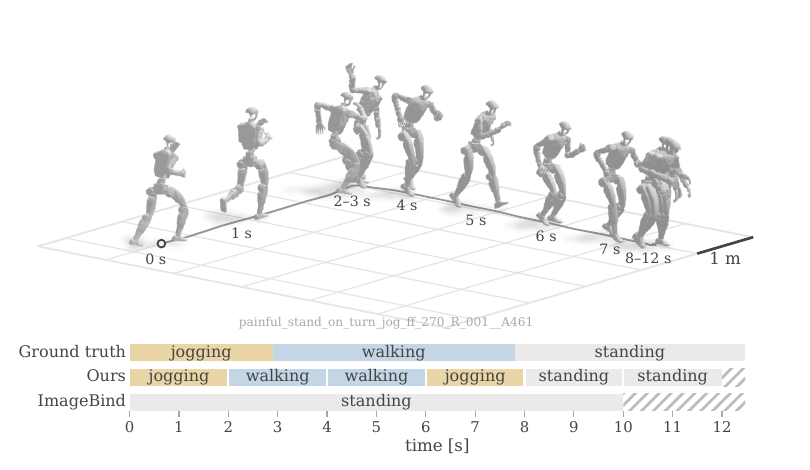
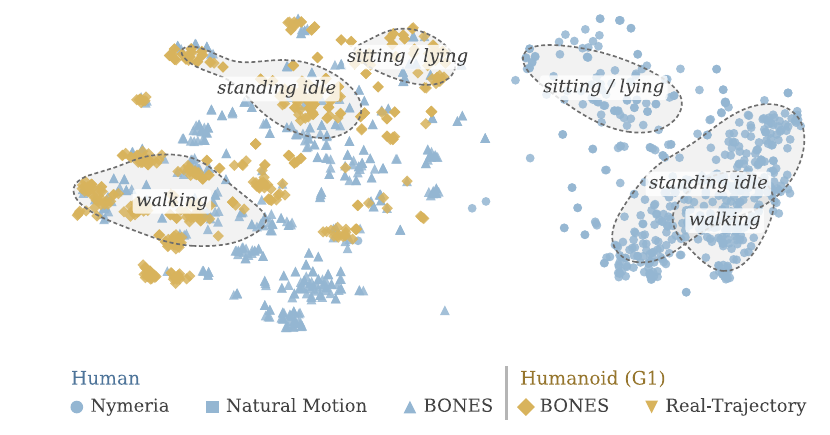
需要冷静看的是绝对数值:R@1 是在 20 个候选里选 1 个(19 个干扰项),mAP 最高只有 32.9%,说明细粒度语言检索仍然很难;语言监督有一部分是合成的旁白,词汇量有限。论文自己也把这条列进了局限。
3.4 消融:连续时间编码是主要贡献,交替注意力不是
表中每格是 ATEGT / ATEPred(m)。
| 变体 | Nymeria GT / Pred | BONES G1 GT / Pred | 真机 G1 GT / Pred |
|---|---|---|---|
| 1. 训练具身 | |||
| Humanoid-only | 8.041 / 17.50 | 0.162 / 0.180 | 5.901 / 13.15 |
| 2. 输入表征 | |||
| 单骨盆 IMU | 3.592 / 16.66 | 0.330 / 0.335 | 8.114 / 12.81 |
| 骨盆 IMU + 关节 | 2.283 / 16.12 | 0.136 / 0.164 | 3.513 / 18.36 |
| 3. 模型设计 | |||
| 去掉交替注意力 | 2.466 / 14.31 | 0.110 / 0.128 | 3.530 / 11.71 |
| 去掉连续编码 | 31.42 / 31.51 | 1.189 / 1.189 | 17.37 / 17.67 |
| 4. 数据多样性 | |||
| 1/64 数据 | 4.882 / 18.40 | 0.154 / 0.166 | 4.369 / 12.44 |
| 1/16 数据 | 3.500 / 16.93 | 0.111 / 0.131 | 3.792 / 11.95 |
| 1/4 数据 | 2.847 / 14.64 | 0.099 / 0.121 | 3.716 / 11.98 |
| Ours | 2.468 / 18.20 | 0.101 / 0.127 | 3.153 / 11.50 |
四组消融回答四个问题:
- 人体数据有没有用:只在重定向 G1 上训练的 specialist,真机 ATEGT 是 5.901 m,联合训练降到 3.153 m;重定向 G1 从 0.162 降到 0.101 m。人类数据确实提供了机器人自己走不出来的运动先验。
- 多 IMU 表征有没有用:单骨盆 IMU 在真机上是 8.114 m,直接喂关节是 3.513 m,完整接口是 3.153 m;重定向 G1 是 0.330 → 0.136 → 0.101 m。注意「直接喂关节」在 Nymeria 上反而比完整接口好(2.283 vs 2.468 m ATEGT,16.12 vs 18.20 m ATEPred)——论文也承认了这一点。类人机器人上完整接口更好,人体上不是。
- 模型设计:连续时间编码是决定性的(Nymeria 31.42 → 2.468 m,真机 17.37 → 3.153 m);交替注意力是混合的(见 §2.4)。
- 数据多样性:数据越多,Nymeria 和真机 G1 的 ATEGT 单调下降;重定向 G1 反而在 1/4 数据时最好(0.099/0.121),全量是 0.101/0.127。论文的解释是「更多多样性有利于硬件迁移,但不一定有利于重定向动作的精度」——也就是说,重定向 G1 和真机 G1 的最优点并不一致,这也解释了为什么 checkpoint 选择不是一件 trivial 的事(见 §4.2)。
3.5 缩放律与运行时间
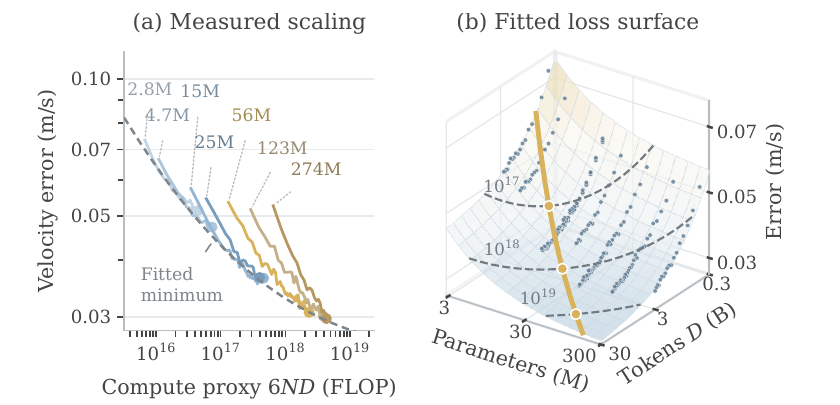
作者还在固定算力预算下拟合了一个 Chinchilla 式缩放律[14]:
其中 是参数量, 是处理过的 token 数(含重复窗口), 是共享站点验证速度误差。用 作为算力代理,拟合结果 、——两个指数几乎相等,意思是「加参数」和「加数据」应该同步做,而不是只堆其中一个。这个结论来自 235 个 EMA checkpoint、2.8M 到 274M 参数的范围;作者也提醒,拟合包含外推,优化的是验证误差,不一定对应最佳硬件迁移。
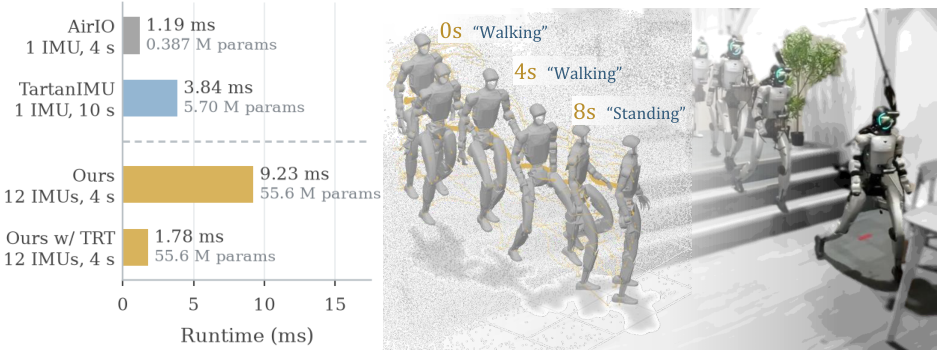
运行时间有一个很实际的点:12 路、4 s、200 Hz 的输入,PyTorch 前向是 9.23 ms,已经超过 5 ms 的采样间隔;必须上 TensorRT 才能做到 1.78 ms、跟上 200 Hz。官方为此写了 src/model/model_trt.py,把动态的 hop 调度换成静态形状的稠密调度,才能导出 ONNX/TensorRT。想部署的人要提前把这条路径算进工程预算。
3.6 真机 G1:零样本爬楼与描述检索
真机实验用一台 Unitree G1,只有骨盆 IMU 和关节编码器;12 路虚拟 IMU 是实时合成的。模型没有见过任何真机轨迹,也没有微调。图 7 右侧是一段楼梯下行:机器人从走到停,检索描述从 “Walking” 变成 “Standing”。图 2 右侧给出另一段结果:326 s、197 m 的路径,平均位置误差 4.44 m。这个数字不算小,但考虑到这是纯惯性积分、没有回环、没有外部观测,而且姿态漂移是论文承认的主要误差源,它说明的是「速度估计足够好,姿态积分仍是瓶颈」。
四、局限性
4.1 论文承认的
论文结论部分列了三条:硬件评测只覆盖一个类人机器人平台(G1);语言监督有一部分是合成的,词汇量有限;尽管速度估计准确,姿态漂移仍是轨迹误差的主要来源。未来工作是把评测扩展到更多平台,并把学习到的速度与滤波结合,做闭环状态估计与控制。
4.2 我自己再补几条
第一,真机分数参与了 checkpoint 选择。 论文正文说真机片段 “reserved entirely for zero-shot evaluation”,但官方 README 写得更细:“Real-G1 evaluation clips are never used for gradient training, but their scores informed this checkpoint selection.” 也就是说没有梯度泄漏,但模型选择看过真机分数。严格意义上的「零样本」应理解为「没有真机训练/微调」,而不是「完全没接触真机信息」。这对 3.153 m 这个 headline 数字的解释有影响:如果换一个完全盲选的真机 checkpoint,数字可能会差一些。
第二,ATEPred 的消融不一致,且没有方差。 完整模型在 Nymeria 上的 ATEPred 是 18.20 m,但「去掉交替注意力」是 14.31 m、「骨盆 + 关节」是 16.12 m、「1/4 数据」是 14.64 m、「1/16 数据」是 16.93 m——多个变体都比完整模型好。ATEGT 上「去掉交替注意力」也和完整模型打平(2.466 vs 2.468)。这有两种解释:要么 ATEPred 被陀螺姿态漂移主导、对 checkpoint 很敏感,要么交替注意力/全量数据在积分姿态下确实没有收益。论文只给单次训练结果,没有多 seed 方差,无法区分。我的判断是前者更可能,但这意味着「ATEPred 最低」的说法应该弱化。
第三,核心训练配方没有逐项消融。 轨迹损失、语言损失、去噪损失、自动配平、随机化的各个范围(重力、身体尺度、振动、冲击、时间戳抖动)都没有单独的 ablation。我们只知道「整套配方 work」,不知道哪一项是必需的。对想复用的人来说,这是最大的不确定性:比如没有语言数据时,速度性能会掉多少?去掉轨迹损失后 ATEGT 会差多少?论文没有回答。
第四,容量与数据不对称,基线并不是同信息同容量。 本文 55.6M 参数、四个语料联合训练;AirIO 是 0.387M,TartanIMU 是 5.70M,且多数基线按数据集单独训练。AirIO w/ joints 控制了「额外输入信息」这个变量,但没有控制容量和训练数据量。所以「最低 AVE」是系统级比较,不是「同样的网络换一个接口」的受控实验。
第五,部署依赖关节编码器和 URDF。 真机上 12 路是虚拟的,合成需要准确的连杆标定、关节角/角速度,以及 ±31 ms 差分带来的平滑。关节编码器失效或标定有偏时,接口会退化;论文没有做传感器故障或标定误差的鲁棒性实验。对外部只有 IMU 的场景(比如给现有机器人加装 IMU),这套方法不能直接套用。
第六,12 个站点的选择没有依据。 为什么丢掉躯干、肩、手,保留这 12 个?官方代码的注释只说「固定丢掉」,论文没有比较 9 路、12 路、17 路的效果。对不同的机器人形态(比如没有手的四足、有灵巧手的 G1),这个集合是否最优是未知的。
第七,数据规模与评测覆盖。 真机只有 0.7 小时、一个平台、室内楼梯场景;重定向 G1 的「复杂动作」是留出的,但重定向本身依赖 IK,合成信号和真实关节运动之间还有差距。跨平台、跨场景(户外、斜坡、跑跳)的泛化没有验证。
五、结论与展望
这篇论文的故事线很清楚:类人机器人缺的不是模型,而是可迁移的输入接口。一旦把「人体 12 路 IMU」和「机器人 1 路骨盆 IMU + 关节」映射到同一个解剖站点集合,500 小时人体数据就能直接用来训练机器人的惯性感知;再用固定时长的 token 抹平采样率、用多任务监督把速度/去噪/语言绑在一起、用随机化补上运动学缺失的硬件效应,一个 checkpoint 就能跨具身工作。
对实践者,我觉得有三条可以直接拿走:
- 如果你有动捕数据和带关节编码器的机器人,别急着重定向动作再学策略;先把运动学 IMU 合成做出来,在传感层做联合训练。合成信号不需要世界位姿和根速度,工程上比想象中轻。
- 多采样率数据别重采样,用固定物理时长的 bin + 连续核池化;token 数只由窗口时长决定,丢包只会丢 bin,不会产生假 token。
- 多任务损失别手调权重,用一个共享标量探针的梯度范数比做 EMA 配平;比网格搜索稳,也比固定权重省事。
未来可以往三个方向走:更多类人平台(不同连杆比例、不同关节定义)验证接口的普适性;把学习到的速度接进 EKF/因子图做闭环,解决姿态漂移;把语言监督从合成旁白换成更细粒度、更大词汇量的真实标注。论文自己提的是前两个,第三个是我加的——因为目前语言检索的绝对指标(mAP 最高 32.9%)离实用还有距离。
六、上手
官方仓库是 amazon-far/Unified-Inertial-Encoder,Apache 2.0。注意 README 里的 clone 地址写的是 github.com/unified-inertial-encoder/Unified-Inertial-Encoder,这个地址目前 404;实际能 clone 的是 amazon-far 这个。环境要求 Python 3.14、PyTorch(按硬件装)、一块 CUDA GPU;FlashAttention 和 TensorRT 可选,TensorRT 只影响部署性能。原始数据不随仓库发布,需要按各数据集协议自行下载;论文模型在 Hugging Face 上。
安装、权重与路径(Python 3.14 + CUDA)
git clone https://github.com/amazon-far/Unified-Inertial-Encoder.git
cd Unified-Inertial-Encoder
python3.14 -m venv .venv
. .venv/bin/activate
python -m pip install torch          # 选择匹配硬件的 build
python -m pip install -r requirements.txt

export FOUNDATIONIMU_DATA_ROOT="$PWD/data"
export FOUNDATIONIMU_CACHE_ROOT="$PWD/data"
export FOUNDATIONIMU_EXP_ROOT="$PWD/experiments"

RUN="${FOUNDATIONIMU_EXP_ROOT}/unified-inertial-encoder"
hf download Open-IO/Unified-Inertial-Encoder --local-dir "$RUN"
最小的评测入口是 src.eval_foundation:给它 checkpoint、一个带 .hydra 配置的 run 目录,以及数据集 reader 的名字。真机 G1 用 Humanoid_SuperOdom_NPZ_Processed_Language,人体数据用 Nymeria_XSens_Processed_IMU_Language 等。评测会把输出限制到骨盆,和单 IMU 基线直接可比。
评测命令(真机 G1 与语言检索)
python -m src.eval_foundation \
    --ckpt "$RUN/checkpoints/unified_encoder.ckpt" \
    --data_from "$RUN" \
    --dataset Humanoid_SuperOdom_NPZ_Processed_Language \
    --json real_g1.json

python -m src.scripts.evaluate_language_classification "$RUN/checkpoints/unified_encoder.ckpt"
训练用的是 exp15_full_train_C,配方总长 64 个 epoch,论文报告第 20 个 epoch 的 EMA 权重。如果你想复现论文的数字,注意 README 的提示:真机片段不参与梯度,但参与了 checkpoint 选择。调试时用 debug=true(单卡、无 DDP、无 dataloader worker),关 W&B 用 wandb.enable=false。
训练与消融
python -m src.train experiment=exp15_full_train_C

# 单卡调试
python -m src.train experiment=exp15_full_train_C debug=true wandb.enable=false

# 模型设计消融(交替注意力 / 无 RoPE / 离散 patch)
python -m src.train experiment=exp18_arch_fullattn
python -m src.train experiment=exp18_arch_norope
python -m src.train experiment=exp18_arch_discrete
数据预处理是四个脚本,分别对应 Nymeria、Natural Motion、BONES-SEED 人体和 BONES-SEED G1;真机片段直接从 Hugging Face 下载。Nymeria 需要一个本地生成的 catalogue,语言标注的转录走 Amazon Bedrock,需要 AWS 凭证。这些都不在仓库里,第一次跑要预留时间。
数据预处理与真机片段下载
CACHE="$FOUNDATIONIMU_CACHE_ROOT"

python -m src.scripts.nymeria_imu_process src/config/data/nymeria_full_9imu.yaml "$CACHE/nymeria_imu_processed_v3"
python -m src.scripts.naturalmotion_imu_process src/config/data/naturalmotion_full_9imu.yaml "$CACHE/vt_natural_motion_processed_v3"
python -m src.scripts.bonesseed_soma_process src/config/data/bones_seed_soma_full.yaml "$CACHE/bones_seed_soma_processed_v4"
python -m src.scripts.bonesseed_imu_process src/config/data/bones_seed_full.yaml "$CACHE/bones_seed_processed_v4"

hf download Open-IO/humanoid-g1-odometry --repo-type dataset \
    --local-dir "$CACHE/humanoid_superodom_clips_v2"
运行时间 profiling 用一个合成的 12 路、200 Hz、4 s 输入,不需要数据集;加 --trt 走 TensorRT 路径。如果你的目标平台不是 L40S,这个数字只能作为相对参考。
延迟 profiling(含 TensorRT)
python -m src.scripts.effiency_profiling \
    --ckpt "$RUN/checkpoints/unified_encoder.ckpt" --device cuda:0 --trt
参考
- Chen, Zhao, Duan, Liu, Sferrazza, Shi, Qiu, Sreenath. A Unified Inertial Encoder for Human and Humanoid Motion. arXiv:2611.10137, 2026. arXiv · 代码
- Ma, Ye, Hong, Guzov, et al. Nymeria: A Massive Collection of Multimodal Egocentric Daily Motion in the Wild. ECCV 2024. arXiv
- Bones Studio. BONES-SEED: Skeletal Everyday Embodied Dataset. Hugging Face dataset, 2026. 数据
- Liu, Caruso, Ilg, Dong, Mourikis, Daniilidis, Kumar, Engel. TLIO: Tight Learned Inertial Odometry. IEEE RA-L 2020. arXiv
- Qiu, Wang, Xu, Chen, Zhou, Xia, Scherer. AirIMU: Learning Uncertainty Propagation for Inertial Odometry. arXiv:2310.04874, 2023. arXiv
- Qiu, Xu, Chen, Zhao, Geng, Scherer. AirIO: Learning Inertial Odometry with Enhanced IMU Feature Observability. IEEE RA-L 2025. arXiv
- Zhao, Zhou, Blanchard, Qiu, Wang, Scherer. Tartan IMU: A Light Foundation Model for Inertial Positioning in Robotics. CVPR 2025. CVF · 代码
- Moon, Madotto, Lin, Dirafzoon, Saraf, Bearman, Damavandi. IMU2CLIP: Multimodal Contrastive Learning for IMU Motion Sensors from Egocentric Videos and Text. Findings of EMNLP 2023. arXiv
- Girdhar, El-Nouby, Liu, Singh, Alwala, Joulin, Misra. ImageBind: One Embedding Space To Bind Them All. CVPR 2023. arXiv
- Zhang, Ayush, Qiao, Heydari, et al. SensorLM: Learning the Language of Wearable Sensors. NeurIPS 2025. arXiv
- Huang, Yuan, Gu, Fang, Zhang, Wang, Gao, Zhang. Human2Humanoid: Physics-Aware Cross-Morphology Motion Retargeting for Humanoid Robots. arXiv:2606.03476, 2026. arXiv
- Romero, Kuzina, Bekkers, Tomczak, Hoogendoorn. CKConv: Continuous Kernel Convolution For Sequential Data. ICLR 2022. arXiv
- Radford, Kim, Hallacy, Ramesh, Goh, Agarwal, et al. Learning Transferable Visual Models From Natural Language Supervision. ICML 2021. arXiv
- Hoffmann, Borgeaud, Mensch, Buchatskaya, et al. Training Compute-Optimal Large Language Models. NeurIPS 2022. arXiv