· 81 min read
论文解读:DUSt3R,把未标定图像的两视图重建写成 pointmap 回归
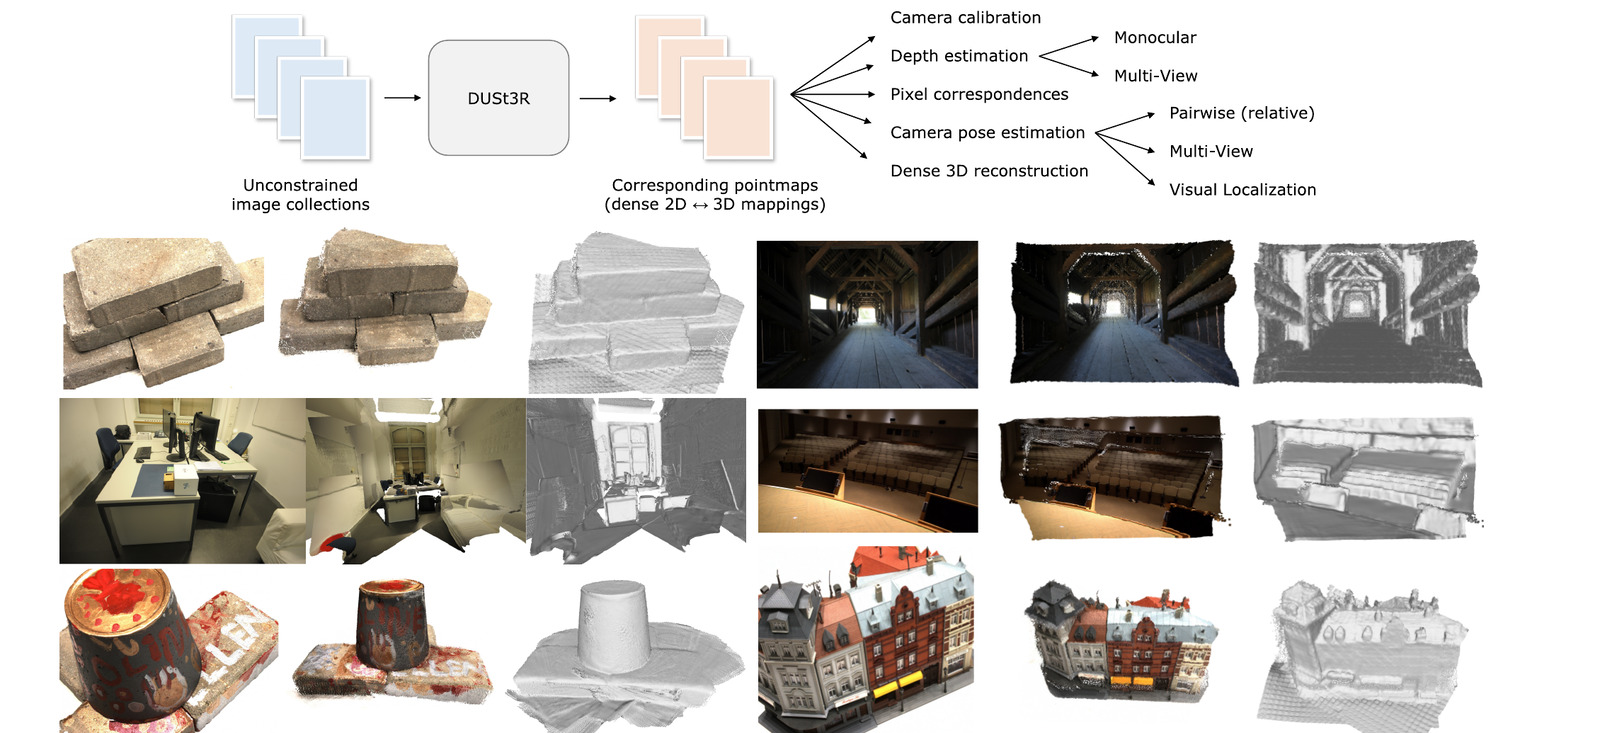
TL;DR DUSt3R[1] 把「标定 → 特征匹配 → 三角化 → BA → MVS」换成一次 pointmap 回归:输入两张未标定图像,网络直接输出每个像素的 3D 点,两张图的点都表达在第一个相机的坐标系里;匹配是 3D 最近邻,内参、相对位姿、深度和稠密重建都从同一份点图里读出来。多视图时,它把成对点图按图结构做 3D 相似变换对齐(Eq. 5),同时反解相机,不需要 2D 重投影 BA。论文用 8 个数据集、850 万对图训练 ViT-L/ViT-B(CroCo v2 初始化),一个 512 模型不做任务微调就跑完单目/多视图深度、位姿、定位和 DTU:CO3Dv2 10 帧 mAA@30 76.7、ETH3D 多视图深度 Rel 2.91、DTU overall 1.741 mm(无 GT 相机;GeoMVSNet 0.295 mm,但用了 GT 相机并在 DTU 上训练)。代码和权重开源,许可证是 CC BY-NC-SA 4.0,非商用。
- 论文:DUSt3R: Geometric 3D Vision Made Easy,Shuzhe Wang, Vincent Leroy, Yohann Cabon, Boris Chidlovskii, Jérôme Revaud(Aalto University / NAVER LABS Europe),CVPR 2024,arXiv:2312.14132。
- 代码:github.com/naver/dust3r,官方权重
naver/DUSt3R_ViTLarge_BaseDecoder_224_linear、_512_linear、_512_dpt;代码与权重均为 CC BY-NC-SA 4.0(非商用),训练数据另有各自许可证。 - 前作 / 预备知识:LoFTR、DKM、RoMa v2、LightGlue;直接后继:MASt3R。
一、动机:一条流水线,七个脆弱环节
传统 SfM/MVS 把「从图像到 3D」拆成一条很长的流水线:标定或自标定求内参,检测关键点并匹配,鲁棒估计本质矩阵或单应,三角化,光束法平差(bundle adjustment, BA)优化相机和结构,最后用 MVS 做稠密重建。每一步都是独立的研究方向,也都有自己的假设:标定需要足够的运动或已知的标定板;匹配需要重复纹理和光照不变性;三角化需要准确的位姿;BA 需要好的初值;MVS 需要已知的相机参数和深度范围。更关键的是,这些步骤之间没有「反馈」:匹配错了,位姿就错;位姿错了,三角化就错;三角化错了,BA 只能在一个错的初值附近收敛。
另一条路线是学习式的两视图几何:用网络直接回归深度和相对位姿,或者像 PoseDiffusion[2] 那样把位姿估计写成扩散式的 BA。它们减少了手工模块,但仍然把几何拆成「深度图 + 相机位姿」两个量:深度图是每张图各自的,尺度不确定;位姿是另一个网络或另一个优化问题;内参通常还是要作为输入。换句话说,表示本身没有变,只是把每个子问题换成了神经网络。
这篇论文的赌注是:与其把每个几何量分别回归,不如回归一个更原生的表示——pointmap。pointmap 是一个和图像像素一一对应的 3D 点场:每个像素 i 对应一个三维点 。给定两张图,网络直接输出两个 pointmap,并且都把 3D 点表达在第一个相机的坐标系里。这样,匹配就是两个点图之间的最近邻,内参可以从点图反解,相对位姿可以用 Procrustes 对齐,深度就是点图的 z 分量,稠密重建就是把多个点图对齐到同一个世界坐标系。匹配、深度、位姿、重建不再是四个任务,而是同一份输出的四种读法。
论文的贡献可以概括为四条:
- 提出 DUSt3R:对任意未标定、未定姿的图像对,直接回归两个同一坐标系下的稠密 pointmap,不需要先做标定、特征匹配或 SfM。
- 说明 pointmap 是一个「一等多」的表示:像素匹配、相机标定、相对/绝对位姿、单目/多视图深度、稠密重建都可以从它推导出来,且不需要任务特定的头。
- 提出一个简单的全局对齐:在 3D 空间里用相似变换把成对 pointmap 对齐到统一坐标系,同时反解相机;它不是 2D 重投影 BA,收敛快、实现简单。
- 用同一个模型、不做任务微调,在单目深度、多视图深度、相机位姿、视觉定位和 DTU 重建上取得有竞争力的结果;代码和权重开源。
二、核心方法
2.1 Pointmap:把「像素 → 3D 点」当成一等公民
设图像 的大小为 ,它的 pointmap 记为 。 是像素 对应的 3D 点,表达在相机 的坐标系里。给定两个相机位姿 (world-to-camera),同一个 3D 点在两个相机里的坐标满足
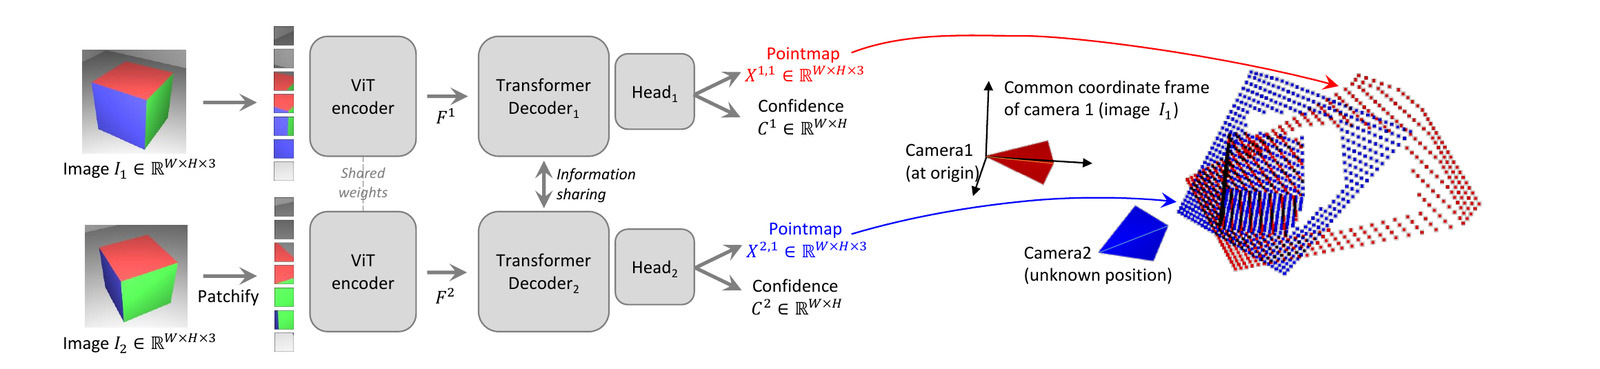
其中 是把 3D 点写成齐次坐标。DUSt3R 不预测两个各自坐标系里的点图,而是直接预测 和 :前者是视图 1 的点图,后者是视图 2 的点图,但两者都在相机 1 的坐标系里。这是一个非对称表示:相机 1 被当作锚点,相机 2 的位姿被隐式编码在 里。
为什么这个表示适合未标定输入?
- 不需要先知道内参。 网络直接输出 3D 点,内参是点图的一个「读数」,而不是输入。论文在 3.3 节才从点图反解焦距,且假设主点居中、像素为方形;这说明网络本身没有被针孔模型约束死。
- 匹配变成几何问题。 两个点图在同一个坐标系里,像素 在视图 1 的 3D 点是 ,在视图 2 里找距离最近的点 ,就得到对应 。不需要描述子、不需要 ratio test、不需要 RANSAC 做外点剔除;置信度图负责把不可靠的点压下去。
- 相对位姿是点图的副产品。 对两个点图做带尺度的 Procrustes 对齐,就得到 ;论文还给了基于 PnP-RANSAC 的更稳健版本。
- 深度是点图的 z 分量。 单目深度任务直接把同一张图喂两次,取 的 z 分量;多视图深度则把多个点图按置信度加权平均。
代价也很清楚,论文在 3.1 节的 Discussion 里明确写了:输出 pointmap 只能确定到一个未知尺度;pointmap 也不必对应一个物理上可实现的相机模型。前者来自单目/未标定两视图的尺度歧义,后者是因为网络只被 3D 回归损失监督,没有被要求满足针孔投影。这个「松」既是优点(网络可以表达非理想几何),也是后面所有限制的根源。
和「深度图 + 位姿」相比,pointmap 的差别可以列成一张表:
| 表示 | 输出 | 匹配方式 | 内参 / 尺度 |
|---|---|---|---|
| 深度+位姿 | 深度 + 位姿 | 2D 描述子 / 光流 / 相关体 | 需要内参;深度和位姿各自有尺度 |
| pointmap | 同一坐标系下的 3D 最近邻 | 不需要;全局未知尺度,需对齐 |
这张表也解释了为什么 pointmap 能把「匹配」和「重建」统一起来:匹配不再是 2D 图像上的像素对应,而是 3D 空间里的点对应;重建也不再是「先有深度、再有位姿」,而是「先有点图、再从点图读深度和位姿」。
pointmap 头的实现非常直接:每个 16×16 patch 的 token 经过一个线性层,输出 个数,再用 pixel_shuffle 还原成 ,前三个通道是 3D 点,第四个通道是置信度。官方 224/512 linear 模型用的是下面这个头;默认的 512 DPT 模型换成 DPT 头,但最后都走同一个 postprocess,把 3+1 通道变成 pts3d 和 conf。
代码:pointmap + confidence 输出头(官方 dust3r/heads/linear_head.py,原文照录)
class LinearPts3d (nn.Module):
    """
    Linear head for dust3r
    Each token outputs: - 16x16 3D points (+ confidence)
    """

    def __init__(self, net, has_conf=False):
        super().__init__()
        self.patch_size = net.patch_embed.patch_size[0]
        self.depth_mode = net.depth_mode
        self.conf_mode = net.conf_mode
        self.has_conf = has_conf

        self.proj = nn.Linear(net.dec_embed_dim, (3 + has_conf)*self.patch_size**2)

    def setup(self, croconet):
        pass

    def forward(self, decout, img_shape):
        H, W = img_shape
        tokens = decout[-1]
        B, S, D = tokens.shape

        # extract 3D points
        feat = self.proj(tokens)  # B,S,D
        feat = feat.transpose(-1, -2).view(B, -1, H//self.patch_size, W//self.patch_size)
        feat = F.pixel_shuffle(feat, self.patch_size)  # B,3,H,W

        # permute + norm depth
        return postprocess(feat, self.depth_mode, self.conf_mode)
2.2 网络:共享 ViT 编码器 + 交叉注意力解码器
DUSt3R 的骨干是 CroCo v2[3] 的 ViT-L/ViT-B:编码器 ViT-L(24 个 block,1024 维,16 个 head),解码器 ViT-B(12 个 block,768 维,12 个 head),patch size 16。两张图分别 patchify 后,共享同一个编码器得到 token 序列 ;然后两个解码器分支逐层处理,每个 block 都通过 cross-attention 让对方看到自己的 token:
最后两个回归头分别输出
这个设计有三个关键点:
- 信息共享发生在每一层,而不是最后。 如果只在最后拼接特征,网络很难在早期就把两幅图的对应关系建立起来;逐层的 cross-attention 让两个分支在多个尺度上交换信息,相当于把「匹配」隐式地写进了特征。
- 两个头共享同一个编码器,但不共享解码器。 编码器负责通用的视觉表示,解码器负责各自视图的几何;共享编码器避免了两个视图学出不一致的视觉词汇。
- 输出是非对称的。 两个点图都表达在相机 1 的坐标系里,头 2 的输出键在代码里直接叫
pts3d_in_other_view。这给了网络一个天然的规范坐标系,也让相对位姿成为点图的副产品,而不是另一个回归目标。
为什么用 CroCo v2 初始化?CroCo 的预训练任务是 cross-view completion:把一张图的大部分 patch 遮住,用另一张视角的图来重建。这个任务强迫模型学习「两幅图之间什么对应什么」以及「场景的 3D 结构」,和 DUSt3R 需要的几何先验高度一致。论文的消融很直接:同样 224 分辨率,没有 CroCo 的模型在 7Scenes Great Court 上是 143 cm / 1.32°,有 CroCo 是 36 cm / 0.24°;KITTI 单目深度 Rel 从 20.10 降到 16.97;ETH3D 多视图深度 Rel 从 9.51 降到 4.71。CroCo 不是锦上添花,而是把模型从「能训练」拉到「能用」的关键。
分辨率的作用同样明显,但不是单调的。224→512 后,KITTI 单目 Rel 从 16.97 降到 10.74,ETH3D 多视图 Rel 从 4.71 降到 2.91,平均多视图 Rel 从 6.85 降到 4.73;但 DTU 的多视图 Rel 反而从 2.76 升到 3.52。论文没有专门解释这个反向变化;我猜是 512 的高分辨率对细节和宽基线更有利,而 DTU 的场景尺度小、纹理规则,低分辨率的归纳偏置反而够用。这个细节提醒我们:「更高分辨率一定更好」在跨数据集上不成立。
训练分三段:先在 224×224 上训 linear head,再在 512 的多种长宽比上训 linear head,最后在 512 上训 DPT head。官方默认的 DUSt3R 512 是第三段的 DPT 模型;前两段的 linear 模型用于消融和快速推理。输入 512 时,patch 16 得到 32×32 个 token,每个 token 输出 16×16 个像素的 3+1 通道,正好覆盖 512×512。
代码:两视图前向与「view 2 的点图在 view 1 坐标系」实现(官方 dust3r/model.py,原文节选)
    def forward(self, view1, view2):
        # encode the two images --> B,S,D
        (shape1, shape2), (feat1, feat2), (pos1, pos2) = self._encode_symmetrized(view1, view2)

        # combine all ref images into object-centric representation
        dec1, dec2 = self._decoder(feat1, pos1, feat2, pos2)

        with torch.cuda.amp.autocast(enabled=False):
            res1 = self._downstream_head(1, [tok.float() for tok in dec1], shape1)
            res2 = self._downstream_head(2, [tok.float() for tok in dec2], shape2)

        res2['pts3d_in_other_view'] = res2.pop('pts3d')  # predict view2's pts3d in view1's frame
        return res1, res2
2.3 损失:尺度归一化的 3D 回归 + 可学习置信度
训练需要 ground-truth pointmap。给定 GT 内参 、位姿 和深度图 ,附录 Eq. 6/7 把每个像素反投影到 3D,再把视图 2 的点变换到视图 1 的坐标系:
由于单目/未标定两视图存在尺度歧义,预测和 GT 都只能确定到一个尺度。论文用两个点图的平均原点到点距离做联合归一化:
归一化后的逐像素回归损失是简单的欧氏距离(不是平方):
代码里对应的是 Regr3D(L21, norm_mode='avg_dis'):L21Loss 返回 torch.norm(a - b, dim=-1),normalize_pointcloud 用 avg_dis 把两个点图一起除以平均距离。注意归一化是联合的:两个视图用同一个 ,否则两个点图之间的相对尺度会被破坏。
真实场景里总有一些像素的 3D 点是不适定的:天空、透明物体、镜面、细结构、只被一个视图看到的区域。论文没有给这些像素硬标签,而是让网络额外回归一个置信度 ,并用置信度加权回归损失:
其中 , 是控制正则项的超参。直观地看: 大,回归项权重大; 防止网络把所有像素的 都压到 1。最优的 大致与局部损失成反比,所以容易的区域置信度高,难的区域置信度接近 1,等效于对难像素降权。置信度没有显式监督,完全由损失学出来。
论文只写 是超参,没有给具体值;官方 ConfLoss 默认 alpha=1,但 README 的完整训练命令用的是 alpha=0.2。这是一个典型的「论文公式 + 官方配方」差异:如果你要复现,跟着 README 的 0.2,而不是默认构造参数。
置信度的参数化在代码里也很直接:conf_mode=('exp', 1, inf),reg_dense_conf 返回 ,并 clip 到 。这正好对应论文的 ,保证置信度严格大于 1。
代码:置信度参数化(官方 dust3r/heads/postprocess.py,原文照录)
def reg_dense_conf(x, mode):
    """
    extract confidence from prediction head output
    """
    mode, vmin, vmax = mode
    if mode == 'exp':
        return vmin + x.exp().clip(max=vmax-vmin)
    if mode == 'sigmoid':
        return (vmax - vmin) * torch.sigmoid(x) + vmin
    raise ValueError(f'bad {mode=}')
代码:置信度加权回归损失(官方 dust3r/losses.py,原文节选)
    def compute_loss(self, gt1, gt2, pred1, pred2, **kw):
        # compute per-pixel loss
        ((loss1, msk1), (loss2, msk2)), details = self.pixel_loss(gt1, gt2, pred1, pred2, **kw)
        if loss1.numel() == 0:
            print('NO VALID POINTS in img1', force=True)
        if loss2.numel() == 0:
            print('NO VALID POINTS in img2', force=True)

        # weight by confidence
        conf1, log_conf1 = self.get_conf_log(pred1['conf'][msk1])
        conf2, log_conf2 = self.get_conf_log(pred2['conf'][msk2])
        conf_loss1 = loss1 * conf1 - self.alpha * log_conf1
        conf_loss2 = loss2 * conf2 - self.alpha * log_conf2

        # average + nan protection (in case of no valid pixels at all)
        conf_loss1 = conf_loss1.mean() if conf_loss1.numel() > 0 else 0
        conf_loss2 = conf_loss2.mean() if conf_loss2.numel() > 0 else 0

        return conf_loss1 + conf_loss2, dict(conf_loss_1=float(conf_loss1), conf_loss2=float(conf_loss2), **details)
这里有一个容易忽略的细节:损失对两个视图都算,但坐标锚点始终是视图 1。交换图像顺序,锚点就换到另一张图;训练时把两种顺序都喂进去(对称化),网络才能学会「谁在谁的坐标系里」而不是记住某个固定顺序。官方推理代码里的 symmetrize=True 也是同一个思想:一对图会同时以 和 两种顺序进入网络。
2.4 从 pointmap 读出几何:匹配、内参、相对位姿
pointmap 最「好用」的地方,是下游量都可以用很轻的几何运算读出来。
像素匹配。 两个点图在同一坐标系里,对视图 1 的每个像素 ,在视图 2 的点图里找 3D 距离最近的 ,再做互惠检查( 的最近邻是 ,且 的最近邻是 ),就得到匹配。论文把这称为「trivially」:没有描述子、没有 ratio test、没有学习式匹配头。置信度低的点先被 mask 掉,剩下的点做最近邻。这个匹配是稠密的(每个像素都可以有候选),但精度取决于 pointmap 的 3D 精度;如果两个点图在同一区域有系统偏差,最近邻会系统性地偏移。
内参。 假设主点居中、像素为方形,只剩焦距 。对视图 1 的每个像素,pointmap 给出的 3D 点应该满足针孔模型:
其中 ,。这是一个加权最小二乘,论文说可以用 Weiszfeld 算法几步迭代求解。要求视图 2 的焦距,只需把图像对反过来跑一次,用 套同一个公式。这个做法很聪明:网络本身不需要输出内参,内参是点图的一个几何拟合结果;代价是它依赖「主点居中、方形像素」的假设,真实相机不满足时会有偏差。
相对位姿。 直接在 3D 里做带尺度的 Procrustes 对齐:
这是一个闭式解(SVD)。Procrustes 对噪声和外点敏感,所以论文还给了一个更稳健的版本:用 2D 匹配 + 本质矩阵,或者用 2D-3D 对应 + PnP-RANSAC。实际使用时,如果 pointmap 质量好,Procrustes 足够;如果外点多,PnP-RANSAC 更稳。
绝对位姿 / 视觉定位。 查询图 和数据库图 :可以先从 估计查询图内参,再用 2D-2D 匹配得到 2D-3D 对应,最后 PnP-RANSAC;也可以先求相对位姿,再用数据库图的 GT pointmap 把尺度对齐到世界坐标系。论文的定位实验用的是「原始 pointmap + 2D 匹配 + PnP」,没有做全局对齐,也没有针对定位微调。
匹配不是这篇论文的主秀。 论文没有在 MegaDepth 之类的匹配基准上报告 AUC,也没有和 LoFTR[4]、SuperGlue[5]、DKM[6]、LightGlue[7] 做逐项匹配对比;它只在 7Scenes/Cambridge 的定位任务中间接验证匹配。真正的匹配精度对比要等直接后继 MASt3R[8]:MASt3R 在 DUSt3R 上加了 24 维描述子头和 InfoNCE 匹配损失,把「3D 最近邻读出」变成「可学习的匹配头」,并补上了 DUSt3R 缺的匹配基准。这个分工很重要:DUSt3R 的强项是几何表示,不是匹配精度。
几类方法的关系可以这样看:
| 方法族 | 输出 | 匹配依据 | 监督信号 | 代表 |
|---|---|---|---|---|
| 稀疏法 | 关键点 + 描述子 | 描述子相似度 + 图神经网络 | 匹配标签 / 自监督 | SuperGlue、LightGlue |
| 稠密法 | 稠密 2D 对应 | 相关体、核回归、光流 | 匹配标签 / 几何 | LoFTR、DKM、RoMa v2 |
| DUSt3R | 稠密 3D pointmap | 同一坐标系下的 3D 最近邻 | 3D 回归(无匹配标签) | 本文 |
所以,如果你要的是「两张图的像素对应」,DUSt3R 不是最直接的选择;如果你要的是「从两张未标定图得到点云、深度、位姿」,DUSt3R 的匹配只是顺手读出来的中间量。
2.5 全局对齐:在 3D 里对齐,而不是重投影 BA
两两预测只能保证每对图内部的几何一致;多视图时,不同 pair 的点图还在各自的锚点坐标系里,需要对齐到同一个世界坐标系。论文把所有图像建成一个图 :节点是图像,边是图像对。边的来源有两种:用现成的图像检索方法挑候选对,或者把所有 pair 都过一遍网络(论文说 H100 上单对约 40 ms),再用两边的平均置信度衡量重叠、过滤低置信度 pair。官方实现用最小生成树(MST)做初始化。
对每条边 ,网络给出两个成对 pointmap 和 (都在相机 的坐标系里),以及置信度 。全局对齐要优化的是:每张图的全局 pointmap 、每条边的相似变换(尺度 、刚体 ):
并约束 ,避免 的平凡解。这个约束很关键:单目两视图只能确定到尺度,如果每条边都可以自由缩放,整体尺度会漂移;固定所有边的尺度乘积为 1,相当于选一个全局 gauge。
和传统 BA 的区别是本质性的:
- BA 最小化的是2D 重投影误差,需要内参和相机模型;Eq. 5 最小化的是3D 投影误差,不需要内参,也不要求 pointmap 满足针孔模型。
- BA 的变量是相机位姿和 3D 点,通常用 Levenberg-Marquardt,对初值敏感;Eq. 5 的变量是全局点图、边的相似变换和尺度,用普通梯度下降(官方是 Adam,300 步,lr 0.01,cosine schedule),论文说几百步、几秒就能收敛。
- BA 的 2D 重投影误差在视角变化大、匹配外点多时容易出问题;3D 误差直接比较点图,对「点图整体偏移」更鲁棒,但对「点图本身错了」无能为力。
论文的 Eq. 5 里 是自由变量;官方 PointCloudOptimizer 实际用的是相机参数化版本:每张图优化一个 log-depth 图、一个相机位姿、一个焦距和主点,再由针孔模型生成 。论文 3.4 节说「只需把 替换成 ,就能同时估计相机位姿、内参和深度图」——代码走的就是这条替换路径。这样输出的点云天然和相机一致,但也意味着全局对齐的后半段其实是一个「带相机模型的优化问题」,不是纯粹的自由点图对齐。
代码:全局对齐的损失(官方 dust3r/cloud_opt/optimizer.py,原文照录)
    def forward(self):
        pw_poses = self.get_pw_poses()  # cam-to-world
        pw_adapt = self.get_adaptors().unsqueeze(1)
        proj_pts3d = self.get_pts3d(raw=True)

        # rotate pairwise prediction according to pw_poses
        aligned_pred_i = geotrf(pw_poses, pw_adapt * self._stacked_pred_i)
        aligned_pred_j = geotrf(pw_poses, pw_adapt * self._stacked_pred_j)

        # compute the less
        li = self.dist(proj_pts3d[self._ei], aligned_pred_i, weight=self._weight_i).sum() / self.total_area_i
        lj = self.dist(proj_pts3d[self._ej], aligned_pred_j, weight=self._weight_j).sum() / self.total_area_j

        return li + lj
这段代码和 Eq. 5 的对应关系:proj_pts3d 是优化后的全局点图 (由每张图的深度、位姿、内参投影得到);pw_poses 是每条边的 (get_pw_poses 把尺度乘在旋转和平移上);_weight_i/_weight_j 是置信度经过 log 变换后的权重;li + lj 就是边 上两个视图的 3D 误差。pw_adapt 是一组默认关闭的各向异性尺度(x/y 与 z 分开),论文公式里简化成了一个标量 。
下面这个玩具把 Eq. 5 里「找 」这件事单独拎出来。灰色是目标点云(世界坐标 ),橙色是待对齐的成对 pointmap;拖动尺度、旋转、平移,看橙色点云怎样贴合灰色。点「求解」会用 Procrustes 闭式解算出最优的 ——真实全局对齐同时优化所有边、所有图的点图,并约束 ,这里只演示一条边。
拖一拖四个滑块:橙色点云是网络输出的成对 pointmap,灰色是目标世界坐标;红线连着一部分对应点。默认参数下两团点明显错开,「求解」会把 σ, θ, t 调到 Procrustes 最优。这里用 2D 俯视示意;真实全局对齐同时优化所有边,并约束 Πσe = 1。
2.6 训练数据与配方
论文用 8 个数据集、共 850 万对图训练(Table 8):
| 数据集 | 类型 | 对数 |
|---|---|---|
| Habitat | 室内 / 合成 | 1000k |
| CO3Dv2 | 物体中心 | 941k |
| ScanNet++ | 室内 / 真实 | 224k |
| ARKitScenes | 室内 / 真实 | 2040k |
| Static Thing 3D | 物体 / 合成 | 337k |
| MegaDepth | 室外 / 真实 | 1761k |
| BlendedMVS | 室外 / 合成 | 1062k |
| Waymo | 室外 / 真实 | 1100k |
| 合计 | 8.5M |
训练分三段(Table 7):224×224 + linear head(50 epoch,每 epoch 700k 对,batch 128)、512 + linear head(100 epoch,每 epoch 70k 对,batch 64)、512 + DPT head(90 epoch,每 epoch 70k 对,batch 64)。优化器是 AdamW,lr 1e-4,weight decay 0.05,,cosine decay,warmup 分别为 10/20/15 epoch。512 阶段的输入长宽比从 512×384、512×336、512×288、512×256 到 512×160 随机采样,配合随机中心裁剪和颜色抖动。每个 epoch 从每个数据集采样相同数量的 pair,避免大数据集主导。
一个容易被忽略的细节:DPT 阶段是 90 epoch,不是 20。论文 Table 7 写得清楚,但二手解读里经常抄错。另一个细节是官方 README 的完整训练命令里包含一个 InternalUnreleasedDataset,它不是论文 Table 8 的 8 个公开数据集之一;这意味着严格复现论文的训练数据配比是不可能的,详见局限性。
三、实验结果
3.1 评测设置
论文的默认模型是 DUSt3R 512(DPT head),所有任务都用同一个模型,不做任何下游微调。测试时图像缩放到最长边 512,保持长宽比。单目深度、多视图深度、DTU 重建都不使用 GT 内参或位姿;视觉定位实验使用了已知的查询图内参(这一点很关键,后面会展开)。多视图任务需要先跑全局对齐。
指标方面:单目/多视图深度用绝对相对误差 Rel(越低越好)和阈值精度 (越高越好);位姿用 RRA@15、RTA@15、mAA@30;DTU 用 accuracy、completeness 和 overall(mm,越低越好)。
3.2 单目深度:一个零样本模型,但不是绝对 SoTA
论文把同一张图喂两次,取 pointmap 的 z 分量作为深度。Table 2 左半部分的结果里,DUSt3R 512 在 KITTI 上是 Rel 10.74 / 86.60,NYU 6.50 / 94.09,TUM 14.17 / 79.89,BONN 8.08 / 93.56,DDAD 13.88 / 81.17。
这些数字怎么读?论文正文说 DUSt3R「outperforms the self-supervised baselines and performs on-par with state-of-the-art supervised baselines」。但 Table 2 的逐项数字更冷静:
| 方法 | 类型 | KITTI Rel↓ | NYU Rel↓ | TUM Rel↓ |
|---|---|---|---|---|
| DPT-BEiT | 有监督 | 9.45 | 5.40 | 10.45 |
| NeWCRFs | 有监督 | 5.43 | 6.22 | 14.63 |
| Monodepth2 | 自监督 | 11.42 | 16.19 | 31.20 |
| SC-DepthV3 | 自监督 | 11.79 | 12.34 | 16.28 |
| SlowTv | 零样本 | 6.84* | 11.59 | 15.02 |
| DUSt3R 512 | 零样本 | 10.74 | 6.50 | 14.17 |
* SlowTv 的 KITTI 数字在括号里,表示它在 KITTI 上训练过,不是零样本,不能直接和 DUSt3R 比。
有监督的 DPT-BEiT 在 DDAD、KITTI、NYU、TUM 四个数据集上都比 DUSt3R 好(10.70/9.45/5.40/10.45 vs 13.88/10.74/6.50/14.17);NeWCRFs 在 KITTI 和 NYU 上更好(5.43/6.22),但在 TUM 上不如 DUSt3R(14.63 vs 14.17)。零样本的 SlowTv 在 DDAD 上更好(12.63 vs 13.88),在 NYU/TUM 上更差(11.59/15.02 vs 6.50/14.17)。所以更准确的说法是:DUSt3R 作为一个零样本模型,在多个数据集上接近数据集内监督方法,并在 NYU/TUM 上超过 SlowTv;但它不是单目深度的绝对 SoTA。 摘要里的「set new SoTAs on monocular depth」应该按这个语境理解。
消融方面,CroCo 预训练和分辨率都是大因子:KITTI 单目 Rel 从 NoCroCo 的 20.10 降到 224 的 16.97,再降到 512 的 10.74。也就是说,没有 CroCo 的 DUSt3R 在 KITTI 上连自监督基线都不如(20.10 vs Monodepth2 11.42 / SC-DepthV3 11.79),有了 CroCo 和高分辨率才进入有监督方法的射程。
3.3 多视图深度:ETH3D 很强,DTU 仍输给专用 MVS
多视图深度把多个 pointmap 按置信度加权平均,再和 GT 比。Table 3 的关键行:
| 方法 | 设置 | KITTI Rel↓ / τ↑ | ETH3D Rel↓ / τ↑ | DTU Rel↓ / τ↑ | 平均 Rel↓ / τ↑ |
|---|---|---|---|---|---|
| COLMAP | GT 位姿、GT 内参 | 12.0 / 58.2 | 16.4 / 55.1 | 0.7 / 96.5 | 9.3 / 67.8 |
| Vis-MVSNet | GT 位姿+深度范围+内参 | 9.5 / 55.4 | 10.8 / 43.3 | (1.8) / (87.4) | 7.0 / 61.4 |
| DUSt3R 512 | 无位姿、无深度范围 | 9.11 / 39.49 | 2.91 / 76.91 | 3.52 / 69.33 | 4.73 / 64.52 |
DUSt3R 在 ETH3D 上明显最好(2.91 / 76.91,COLMAP 是 16.4 / 55.1,Vis-MVSNet 是 10.8 / 43.3),平均 Rel 也最低(4.73 vs COLMAP 9.3、Vis-MVSNet 7.0)。但在 DTU 上,COLMAP 是 0.7 / 96.5,DUSt3R 是 3.52 / 69.33;Tanks and Temples 上 COLMAP 是 2.7 / 95.0,DUSt3R 是 3.17 / 76.68。KITTI 上 DUSt3R 的 Rel 更低(9.11 vs 12.0),但 τ 更低(39.49 vs 58.2),说明它的误差分布更「平」:平均误差小,但落在 1.03 阈值内的像素比例不如 COLMAP。Vis-MVSNet 的 DTU 数字带括号,表示它在 DTU 训练集上训练过。
这组结果的说服力在于设置:COLMAP 用了 GT 位姿和 GT 内参,Vis-MVSNet 同样用 GT 位姿和内参、还额外用了 GT 深度范围;DUSt3R 三者都不用。在这个更难的设置下,DUSt3R 在 ETH3D 和平均 Rel 上赢了,在 DTU/T&T 的阈值精度上输了。ScanNet 的 4.93 / 60.20 打了括号,因为 DUSt3R 的训练集包含 ScanNet++,同域数据不能当零样本看。
3.4 相机位姿:多视图很强,绝对定位只是「可比」
多视图相对位姿。 Table 5 用 CO3Dv2 和 RealEstate10K 的 3/5/10 帧,报告 RRA@15、RTA@15、mAA@30:
| 方法 | CO3Dv2 10 帧 RRA/RTA/mAA | RealEstate10K mAA@30 |
|---|---|---|
| PoseDiffusion | 80.5 / 79.8 / 66.5 | 48.0(用 RE10K 训练约 80) |
| DUSt3R 512 + 全局对齐 | 96.2 / 86.8 / 76.7 | 67.7 |
DUSt3R 在 CO3Dv2 上大幅领先 PoseDiffusion[2](mAA 76.7 vs 66.5),而且 3/5/10 帧的 mAA 是 77.5/76.5/76.7,几乎不随帧数变化;RealEstate10K 上是 69.5/67.4/67.7,也稳定。注意两个条件:CO3Dv2 的训练集包含一小部分(每类 50 个序列,<7%),所以不是严格零样本;RealEstate10K 完全没有训练数据,67.7 vs PoseDiffusion 48.0 的差距更能说明泛化。PoseDiffusion 在 RE10K 上训练后能到约 80,但那就不是同一条件了。
Table 2 右侧还有一个有意思的对比:DUSt3R 用 PnP 而不是全局对齐时,CO3Dv2 是 94.3/88.4/77.2,全局对齐是 96.2/86.8/76.7;PnP 的 RTA/mAA 略好,全局对齐的 RRA 更高,但在 RealEstate10K 上 PnP 只有 48.0,全局对齐是 67.7。小基线、视频序列更适合全局对齐;物体中心、宽基线更适合 PnP。 这也解释了为什么论文默认多视图用全局对齐。
绝对位姿 / 视觉定位。 Table 1 在 7Scenes(top-1 检索)和 Cambridge(top-20 检索)上比较中位平移/旋转误差:
| 方法 | 7Scenes Chess | 7Scenes Kitchen | 7Scenes Stairs | Cambridge G. Court |
|---|---|---|---|---|
| HLoc | 2 / 0.79 | 4 / 1.25 | 6 / 1.62 | 11 / 0.16 |
| DUSt3R 512 | 3 / 0.97 | 4 / 1.34 | 11 / 2.84 | 38 / 0.16 |
DUSt3R 在大多数 7Scenes 场景上和 HLoc 同一量级:Chess 3/0.97 vs 2/0.79,Kitchen 4/1.34 vs 4/1.25,Stairs 11/2.84 vs 6/1.62;Cambridge 的 S. Facade 6/0.26 vs 4/0.2,O. Hospital 17/0.33 vs 15/0.3,K. College 11/0.20 vs 12/0.20,St. Mary’s 7/0.24 vs 7/0.21,G. Court 38/0.16 vs 11/0.16。严格看,HLoc 在绝大多数场景上仍略好,DUSt3R 只在 K. College 的平移(11 vs 12 cm)和 Pumpkin 的平移(4 vs 5 cm)上更好。论文说「outperform HLoc in some cases」是准确的,但不宜读成全面超过 HLoc。
更重要的是条件:Table 1 用了已知的查询图内参,7Scenes 用 top-1、Cambridge 用 top-20 检索。附录 Table 6 测了未知焦距:用 2D 匹配 + 已知内参时,7Scenes 仍是 3/0.97 到 11/2.84;改成「从缩放后的相对位姿」且没有 GT 焦距时,7Scenes 还能保持 5/1.08 到 26/3.56,但 Cambridge 直接崩到 O. Hospital 151/0.88、K. College 102/0.88、G. Court 245/1.08。论文的解释是 Cambridge 的 GT 数据库 pointmap 太稀疏,无法可靠地给重建定尺度;7Scenes 的 GT pointmap 稠密,所以还能撑住。所以「未标定」在深度和重建上是真的,在绝对定位上要打个折扣:已知内参的结果和未知内参的结果差了一个数量级。
3.5 3D 重建:DTU 1.741 mm,差距要看清
Table 4 是 DTU 的官方 MVS 指标(mm,越低越好):
| 方法 | GT 相机 | Acc↓ | Comp↓ | Overall↓ |
|---|---|---|---|---|
| GeoMVSNet | ✓ | 0.331 | 0.259 | 0.295 |
| CasMVSNet | ✓ | 0.325 | 0.385 | 0.355 |
| PatchmatchNet | ✓ | 0.427 | 0.277 | 0.352 |
| DUSt3R 512 | ✗ | 2.677 | 0.805 | 1.741 |
DUSt3R 的 overall 是 1.741 mm,GeoMVSNet 是 0.295 mm,差了约 6 倍。论文没有回避这一点,原话是「Our method does not reach the accuracy levels of the best methods」,并给出两个辩护:这些方法用了 GT 相机位姿,而且在 DTU 训练集上训练过;DUSt3R 两者都没有,是一个 plug-and-play 的零样本模型。最好的 MVS 结果还依赖亚像素三角化和精确的相机参数,而 DUSt3R 是回归,精度天然不如优化式方法。
这个结果对实践者的含义很直接:如果你有标定好的图像、追求亚毫米精度,用 MVS;如果你只有一堆未标定的图、想要一个能跑起来的稠密重建,DUSt3R 的 1.7 mm 已经很有用。 它不是要取代 DTU 榜单上的专用方法,而是把「没有相机参数」这个前提下的可用精度拉高了一个档次。
3.6 像素匹配:DUSt3R 没有交这份作业
这是这篇论文最容易被误读的地方。DUSt3R 的匹配是 3D 最近邻 + 互惠检查,概念上非常干净,但论文没有在 MegaDepth-1500、ScanNet-1500、HPatches 之类的匹配基准上报告 AUC,也没有和 LoFTR、SuperGlue、DKM、LightGlue 做逐项对比。它只在视觉定位任务中间接用了匹配:Table 1 的定位误差可以看作匹配质量的一个下游指标,但定位还混入了检索、PnP、RANSAC 和已知内参,不能反推出匹配精度。
所以,关于「DUSt3R vs LoFTR/SuperGlue」的正确说法是:
- 表示上,DUSt3R 把匹配从 2D 描述子空间搬到了 3D pointmap 空间,不需要描述子,天然稠密,对宽基线更友好;代价是没有描述子可复用、没有 ratio test、最近邻的复杂度是 (实际会用 KD-tree 或互惠检查加速),而且匹配精度受 pointmap 精度限制。
- 数值上,这篇论文没有给出可比的匹配 AUC;MASt3R 补上了这一课,它在 DUSt3R 上加了描述子头和匹配损失,并报告了 MegaDepth 等基准。要比较匹配精度,应该看 MASt3R 或 LoFTR/DKM/LightGlue 的论文,而不是从 DUSt3R 的定位表里推。
- 工程上,如果你只要匹配,DUSt3R 不是最优选择;如果你要几何,匹配只是 pointmap 的副产品,3D 最近邻已经够用。
这也解释了为什么论文把匹配放在 3.3 节「Downstream Applications」里,而不是当成核心贡献:pointmap 是主菜,匹配是配菜。
3.7 消融与运行时间
CroCo 预训练和分辨率是论文最主要的消融(Table 1/2/3):
| 变体 | KITTI 单目 Rel↓ | ETH3D 多视图 Rel↓ | 7Scenes G. Court 平移/旋转↓ |
|---|---|---|---|
| 224-NoCroCo | 20.10 | 9.51 | 143 / 1.32 |
| 224 | 16.97 | 4.71 | 36 / 0.24 |
| 512 | 10.74 | 2.91 | 38 / 0.16 |
从 NoCroCo 到 224,ETH3D 的 Rel 几乎腰斩(9.51→4.71),7Scenes G. Court 从 143 cm/1.32° 降到 36 cm/0.24°;从 224 到 512,KITTI 单目和 ETH3D 继续明显下降。两个因子都在起作用,但 CroCo 的贡献更「从无到有」,分辨率的贡献更「从粗到细」。
运行时间方面,论文说单对推理在 H100 上约 40 ms,全局对齐通常几百步、在标准 GPU 上几秒。Table 3 的时间列给的是 DUSt3R 0.13 s、COLMAP 约 3 min;这个口径论文没有细说,我把它当作该表设置下的重建耗时,不当作端到端系统延迟。按 40 ms/pair 粗算,100 张图的全连接图有 4950 对,约 198 s;1000 张图有 499,500 对,约 5.5 小时——这就是为什么大 collections 必须用检索或稀疏图,而不是 all-pairs。
下面这个部件把上面几张表的关键数字放在一起;切换任务看 DUSt3R 在不同设置下的相对位置。所有数字都来自论文 Table 2/3/4/5,括号/星号条件写在下方注释里。
3.8 定性结果
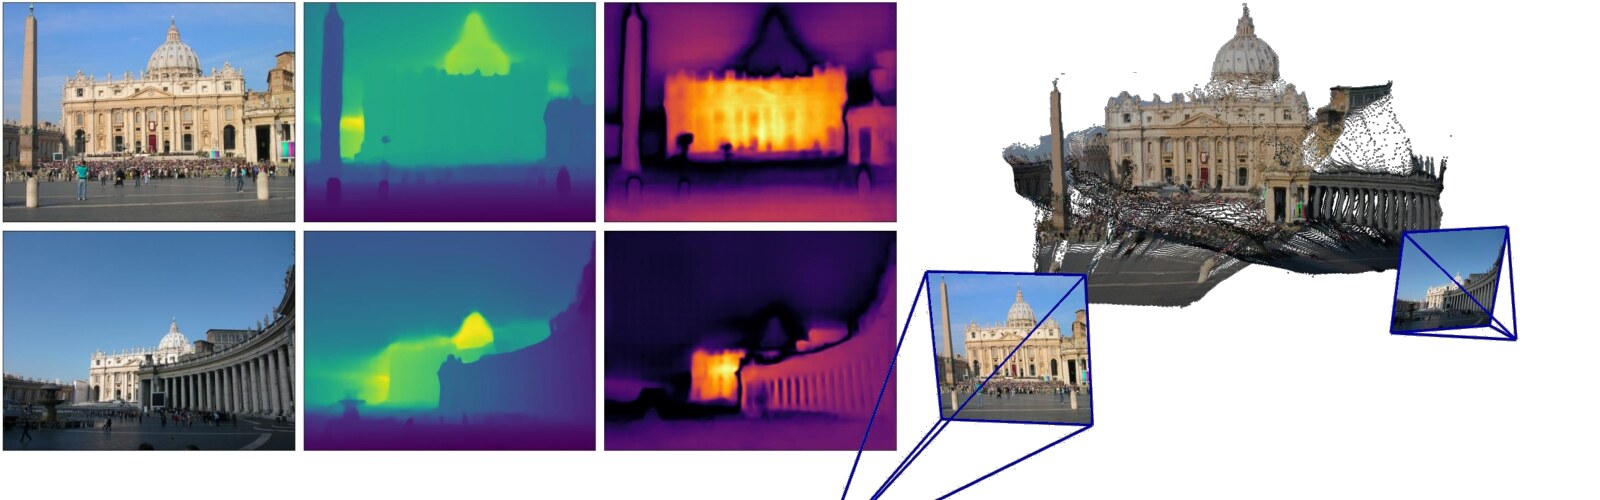
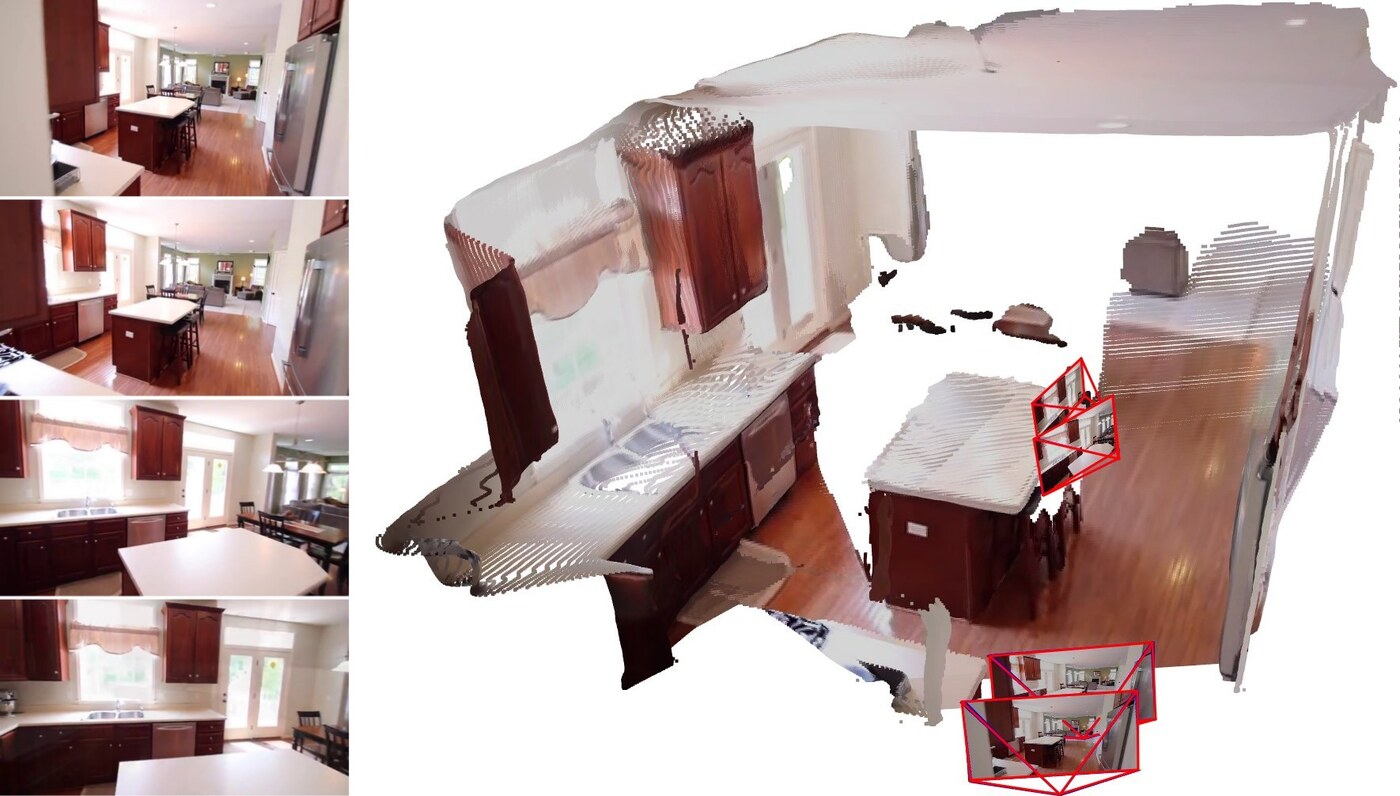
图 2 和图 4 已经展示了两种典型输出:raw pairwise pointmap(没有全局对齐)和全局对齐后的多视图重建。raw 输出的点云在建筑立面、桌椅等区域很干净,天空和远景会被低置信度过滤掉;全局对齐后的 RealEstate10K 重建在视角变化很大的 4 帧上仍能保持同一坐标系。论文附录的 Figure 6/7/8 还展示了 Cambridge、7Scenes 和接近 180° 的对向视角的重建,说明网络对宽基线和焦距变化有一定鲁棒性。
四、局限性
论文自己承认的
- 尺度歧义。 3.1 节明确说 pointmap 只能回归到一个未知尺度;单目/未标定两视图没有绝对尺度,训练时靠归一化,推理时靠全局对齐定 gauge。
- 没有显式几何约束。 3.1 节说 pointmap 不一定要对应物理上可实现的相机模型;网络只被 3D 回归损失监督,没有被要求满足针孔投影。这让表示更灵活,但也意味着「点图」和「相机」是两套东西,需要额外的拟合步骤。
- 网络只处理一对图。 3.4 节开头说「The network F presented so far can only handle a pair of images」;多视图一致性完全靠后处理的全局对齐,而不是网络本身。
- 全局对齐不是 BA。 3.4 节明确说它最小化的是 3D 投影误差,不是 2D 重投影误差;它不是 bundle adjustment,也不使用 Levenberg-Marquardt。
- DTU 精度不如专用 MVS。 4.5 节说「does not reach the accuracy levels of the best methods」,并指出这些方法用了 GT 相机、在 DTU 上训练、依赖亚像素三角化。
- 未知内参的绝对定位会崩。 附录 E 说 Cambridge 的 GT 数据库 pointmap 太稀疏,无法可靠缩放;O. Hospital 从 17 cm 掉到 151 cm,G. Court 从 38 cm 掉到 245 cm。论文的结论是「further work is necessary for in-the-wild visual localization with unknown intrinsics」。
- 同一相机序列的内参不共享。 附录 B 说,即使图像序列来自同一相机,也「never enforce the fact that camera intrinsics must be identical for every frame」;所有内参都是逐帧独立优化的。这会浪费约束,也可能让序列的焦距漂移。
- 每个像素只对应一个 3D 点。 3.1 节的方法假设忽略了半透明表面、镜面、细结构等一个像素射线打到多个点的情况;这些区域的点只能靠置信度降权。
我补的几条
- 没有像素匹配基准。 论文没有报告 MegaDepth/ScanNet 的匹配 AUC,也没有和 LoFTR、SuperGlue、DKM、LightGlue 做匹配对比。定位表只能间接说明匹配「够用」,不能说明匹配「更准」。如果要匹配,应该看 MASt3R 或专门的匹配论文。
- 摘要在单目深度上有点过誉。 Table 2 里 DPT-BEiT 在 DDAD/KITTI/NYU/TUM 四个数据集上都比 DUSt3R 好;DUSt3R 的真实卖点是「一个零样本模型、跨数据集可用」,不是单目深度的绝对 SoTA。写综述时不要把「set new SoTAs on monocular depth」当成「全面超过有监督方法」。
- 绝对定位的「未标定」要打折扣。 Table 1 用了已知查询内参;Table 6 的未知焦距版本在 Cambridge 上差了 4-6 倍。论文的「uncalibrated」在深度和重建上是成立的,在定位上只对 7Scenes 这种 GT pointmap 稠密的场景成立。
- all-pairs 的复杂度是 。 按论文的 40 ms/pair,100 张图约 198 s,1000 张图约 5.5 小时;全局对齐还要存所有边的 pointmap 和置信度。大 collections 必须用检索构图,论文自己也是这么做的。这不是论文的「缺陷」,但它是工程落地时第一个会撞上的墙。
- 动态场景没有处理。 pointmap 假设每个像素对应一个静态 3D 点;运动物体、行人、车辆会违反这个假设,产生 ghosting。置信度可能把一部分动态区域压下去,但论文没有显式的运动建模或动态 mask。这是我从方法假设推出来的,不是论文的实验结论。
- 许可证是硬约束。 代码和权重是 CC BY-NC-SA 4.0,非商用;训练数据里 CO3Dv2 是 CC BY-NC 4.0,ARKitScenes 是 CC BY-NC-SA 4.0,Waymo 是非商用,ScanNet++ 是研究用途。商用产品不能直接拿这套权重和训练配方。这是论文没讨论、但工程上最重要的一条。
- 训练配方不能逐项复现。 官方 README 的完整训练命令包含
InternalUnreleasedDataset,论文 Table 8 只列了 8 个公开数据集;InternalUnreleasedDataset的内容没有公开。加上数据集预处理和 pair list 的版本差异,严格复现 8.5M pair 的训练配比是不可能的。这不影响用官方权重,但影响「从头训一个同款」。
五、结论与展望
DUSt3R 最深的贡献不是某个 loss 或某个模块,而是换了一个表示。在它之前,几何视觉的接口是「深度图 + 相机位姿 + 匹配」;在它之后,接口可以是一张稠密的 3D pointmap,其他量都是读数。这个变化让「未标定图像的两视图重建」从一条需要多个专家模块的流水线,变成了「一次前向 + 一个轻量全局对齐」。它没有在每个 benchmark 上赢,但它把「不需要相机参数」这个前提下的可用性拉高了一个档次。
给实践者的几条建议:
- 先跑 512 DPT 模型。 224 linear 适合快速实验,512 DPT 是质量和速度的平衡点;如果显存/延迟紧张,再降 224。
- 多视图一定跑全局对齐。 原始 pairwise pointmap 只是在相机 1 坐标系里的两团点,不是多视图重建;
global_aligner+compute_global_alignment是必需的。 - 能提供内参/位姿就提供。
PointCloudOptimizer有preset_pose、preset_focal、preset_principal_point三个方法,可以把已知的位姿/焦距/主点钉住(这三个量默认都是可优化参数,主点只在optimize_pp=True时才优化);有先验时钉住它们,比让网络自由优化更稳,尤其在重复纹理、低视差、纯旋转的场景。 - 大 collections 用检索构图。 all-pairs 只适合几十张图;上百张图开始用检索或
scene_graph='swin',否则 40 ms/pair 会变成几小时。 - 匹配任务用 MASt3R 或专用匹配器。 DUSt3R 的 3D 最近邻是几何副产品,不是匹配 SOTA;LoFTR/DKM/LightGlue 在纯匹配任务上更合适,MASt3R 则是「DUSt3R 的几何 + 可学习匹配头」的直接后继。
- 商用前先看许可证。 代码/权重 CC BY-NC-SA 4.0,训练数据还有各自的非商用条款;这不是「开源就能商用」。
往后看,DUSt3R 打开了两条路。一条是把匹配做得更好:MASt3R[8] 在 pointmap 上加描述子头和匹配损失,把 DUSt3R 缺的匹配基准补上;另一条是把多视图做得更直接:VGGT[9] 把多视图图像直接喂进 transformer,一次前向输出相机、深度和点图,不再需要 per-edge 的全局对齐。两者的共同点是都继承了 pointmap 这个接口——这大概就是这篇论文最重要的遗产。
六、上手
官方仓库提供了安装、预训练权重、Gradio demo、最小推理示例和三段训练命令。下面只摘录和论文概念对应的部分,完整内容以 README 为准。
6.1 安装
安装命令(Python 3.11 + CUDA 12.1,官方 README 原文节选)
git clone --recursive https://github.com/naver/dust3r
cd dust3r
conda create -n dust3r python=3.11 cmake=3.14.0
conda activate dust3r
conda install pytorch torchvision pytorch-cuda=12.1 -c pytorch -c nvidia
pip install -r requirements.txt
pip install -r requirements_optional.txt
可选的 CUDA RoPE 内核需要额外编译:cd croco/models/curope && python setup.py build_ext --inplace。不编译也能跑,只是位置编码会慢一些。
6.2 权重
| 后缀 | 分辨率 | Head | 用途 |
|---|---|---|---|
_224_linear | 224×224 | Linear | 最快,消融/低资源 |
_512_linear | 512×{384…160} | Linear | 中等质量 |
_512_dpt | 512×{384…160} | DPT | 论文默认,质量最好 |
完整名称都以 DUSt3R_ViTLarge_BaseDecoder 开头,例如 naver/DUSt3R_ViTLarge_BaseDecoder_512_dpt;512 模型的输入长宽比在 384/336/288/256/160 中随机采样。权重会通过 huggingface_hub 自动下载,也可以从 README 的下载链接手动放到 checkpoints/。权重协议是 CC BY-NC-SA 4.0,且需要同时遵守训练数据集的许可证;非商用。
6.3 最小示例
两视图推理 + 全局对齐(官方 README 的 Usage,原文节选)
from dust3r.inference import inference
from dust3r.model import AsymmetricCroCo3DStereo
from dust3r.utils.image import load_images
from dust3r.image_pairs import make_pairs
from dust3r.cloud_opt import global_aligner, GlobalAlignerMode

if __name__ == '__main__':
    device = 'cuda'
    batch_size = 1
    schedule = 'cosine'
    lr = 0.01
    niter = 300

    model_name = "naver/DUSt3R_ViTLarge_BaseDecoder_512_dpt"
    # you can put the path to a local checkpoint in model_name if needed
    model = AsymmetricCroCo3DStereo.from_pretrained(model_name).to(device)
    # load_images can take a list of images or a directory
    images = load_images(['croco/assets/Chateau1.png', 'croco/assets/Chateau2.png'], size=512)
    pairs = make_pairs(images, scene_graph='complete', prefilter=None, symmetrize=True)
    output = inference(pairs, model, device, batch_size=batch_size)

    # at this stage, you have the raw dust3r predictions
    view1, pred1 = output['view1'], output['pred1']
    view2, pred2 = output['view2'], output['pred2']

    # next we'll use the global_aligner to align the predictions
    # depending on your task, you may be fine with the raw output and not need it
    # with only two input images, you could use GlobalAlignerMode.PairViewer: it would just convert the output
    # if using GlobalAlignerMode.PairViewer, no need to run compute_global_alignment
    scene = global_aligner(output, device=device, mode=GlobalAlignerMode.PointCloudOptimizer)
    loss = scene.compute_global_alignment(init="mst", niter=niter, schedule=schedule, lr=lr)

    # retrieve useful values from scene:
    imgs = scene.imgs
    focals = scene.get_focals()
    poses = scene.get_im_poses()
    pts3d = scene.get_pts3d()
    confidence_masks = scene.get_masks()

    # visualize reconstruction
    scene.show()
交互式 demo 更简单:
Gradio demo(官方 README 原文照录)
python3 demo.py --model_name DUSt3R_ViTLarge_BaseDecoder_512_dptdemo 里如果只选 1-2 张图,全局对齐会自动跳过(GlobalAlignerMode.PairViewer),直接显示原始点云;min_conf_thr 滑块控制低置信度点的过滤阈值,默认是 3。
6.4 参数与论文概念的对应
| 参数 / API | 对应论文 | 建议 |
|---|---|---|
model_name | checkpoint 选择 | 默认 ..._512_dpt |
size=512 | 输入分辨率 | 和 checkpoint 匹配,224 模型用 224 |
scene_graph='complete' | 全连接图 | 小规模(几张到几十张) |
scene_graph='swin' | 滑动窗口图 | 视频序列 |
prefilter | 检索/重叠过滤 | 大 collections 传检索模型 |
symmetrize=True | 两种图像顺序 | 保持 True |
PointCloudOptimizer | Eq. 5 全局对齐 | 多视图默认 |
PairViewer | 两视图 raw 输出 | 1-2 张图 |
init="mst" | 图初始化 | 默认 |
niter=300, lr=0.01, schedule='cosine' | 全局对齐优化 | 默认;难场景可加迭代 |
min_conf_thr=3 | 置信度 mask | 默认;想保留更多点可调低 |
表中的 PointCloudOptimizer、PairViewer 都是 dust3r.cloud_opt.GlobalAlignerMode 的成员,这里省略了前缀;完整写法是 global_aligner(..., mode=GlobalAlignerMode.PointCloudOptimizer)。
scene.get_focals()、get_im_poses()、get_pts3d()、get_depthmaps() 分别对应论文 3.3 节的内参、位姿、点图和深度;get_masks() 是置信度阈值后的有效像素 mask。
6.5 训练
官方 README 给了三段完整命令(224 linear、512 linear、512 DPT),下面是第一段 224 linear 的 demo 版本,用来跑通流程;论文的完整超参在 README 的 “Our Hyperparameters” 一节。
224 linear 训练 demo(官方 README 原文节选;完整三段见 README)
torchrun --nproc_per_node=4 train.py \
    --train_dataset "1000 @ Co3d(split='train', ROOT='data/co3d_subset_processed', aug_crop=16, mask_bg='rand', resolution=224, transform=ColorJitter)" \
    --test_dataset "100 @ Co3d(split='test', ROOT='data/co3d_subset_processed', resolution=224, seed=777)" \
    --model "AsymmetricCroCo3DStereo(pos_embed='RoPE100', img_size=(224, 224), head_type='linear', output_mode='pts3d', depth_mode=('exp', -inf, inf), conf_mode=('exp', 1, inf), enc_embed_dim=1024, enc_depth=24, enc_num_heads=16, dec_embed_dim=768, dec_depth=12, dec_num_heads=12)" \
    --train_criterion "ConfLoss(Regr3D(L21, norm_mode='avg_dis'), alpha=0.2)" \
    --test_criterion "Regr3D_ScaleShiftInv(L21, gt_scale=True)" \
    --pretrained "checkpoints/CroCo_V2_ViTLarge_BaseDecoder.pth" \
    --lr 0.0001 --min_lr 1e-06 --warmup_epochs 1 --epochs 10 --batch_size 16 --accum_iter 1 \
    --save_freq 1 --keep_freq 5 --eval_freq 1 \
--output_dir "checkpoints/dust3r_demo_224"这里能看到论文概念和代码参数的对应:ConfLoss(Regr3D(L21, norm_mode='avg_dis'), alpha=0.2) 就是 Eq. 2-4;depth_mode=('exp', -inf, inf) 是点图的距离参数化;conf_mode=('exp', 1, inf) 是 的置信度;head_type='linear' 是 2.1 节的头,最后一段改成 'dpt'。
参考
- Wang, Leroy, Cabon, Chidlovskii, Revaud. DUSt3R: Geometric 3D Vision Made Easy. CVPR 2024. arXiv · 代码
- Wang, Rupprecht, Novotny. PoseDiffusion: Solving Pose Estimation via Diffusion-aided Bundle Adjustment. ICCV 2023. arXiv · 代码
- Weinzaepfel, Lucas, Leroy, Cabon, Arora, Brégier, Csurka, Antsfeld, Chidlovskii, Revaud. CroCo v2: Improved Cross-view Completion Pre-training for Stereo Matching and Optical Flow. ICCV 2023. arXiv · 代码
- Sun, Shen, Wang, Bao, Zhou. LoFTR: Detector-Free Local Feature Matching with Transformers. CVPR 2021. arXiv · 代码
- Sarlin, DeTone, Malisiewicz, Rabinovich. SuperGlue: Learning Feature Matching with Graph Neural Networks. CVPR 2020. arXiv · 代码
- Edstedt, Athanasiadis, Wadenbäck, Felsberg. DKM: Dense Kernelized Feature Matching for Geometry Estimation. CVPR 2023. arXiv · 代码
- Lindenberger, Sarlin, Pollefeys. LightGlue: Local Feature Matching at Light Speed. ICCV 2023. arXiv · 代码
- Leroy, Cabon, Revaud. Grounding Image Matching in 3D with MASt3R. ECCV 2024. arXiv · 代码
- Wang, Chen, Karaev, Vedaldi, Rupprecht, Novotny. VGGT: Visual Geometry Grounded Transformer. CVPR 2025. arXiv · 代码