· 67 min read
论文解读:MASt3R,把图像匹配锚定在三维点上
TL;DR MASt3R 是 DUSt3R 的「匹配版」[1]。DUSt3R 能直接从两张图回归出同一坐标系下的稠密点图,但匹配只是点图的一个副产品:精度受回归噪声限制,而且要在全图所有像素上做互最近邻,慢得无法实用。MASt3R 保留 DUSt3R 的 ViT-L 编码器、ViT-B 解码器和点图/置信度头,额外接一个两层 MLP 的 24 维描述子头,用 InfoNCE 显式训练「这个像素对应哪个像素」;推理时用快速互最近邻(FRM)只查询 k 个种子点,把复杂度从 降到 。结果是:Map-free 定位的 VCRE AUC 从 DUSt3R 的 0.697 提到 0.933,位姿 AUC 从 0.394 提到 0.740;DTU 零样本重建的 Chamfer 从 0.805 mm 降到 0.374 mm;Aachen 夜间 top1 定位达到 70.2/88.0/97.4。代码与权重以 CC BY-NC-SA 4.0 开源(非商用)。
- 论文:Grounding Image Matching in 3D with MASt3R,Vincent Leroy、Yohann Cabon、Jérôme Revaud,NAVER LABS Europe,ECCV 2024(LNCS 15130,pp. 71–91)。
- 代码:github.com/naver/mast3r,CC BY-NC-SA 4.0;权重托管在 Hugging Face(
naver/MASt3R_ViTLarge_BaseDecoder_512_catmlpdpt_metric)。 - 前作与相关:DUSt3R、LoFTR、LightGlue、DKM、RoMa v2、FlexGlue;后继 MASt3R-SfM 把成对匹配扩展成完整的无约束 SfM。
一、动机:会重建,不等于会匹配
图像匹配的传统路线是「检测—描述—最近邻」:先在两张图上各检测一批关键点,再为每个点算一个局部描述子,最后在描述子空间里找互最近邻。LoFTR 用 Transformer 把这条路改成无检测器的半稠密匹配[2],LightGlue 用自适应深度把稀疏匹配做到极快[3],DKM 和 RoMa v2 把稠密匹配的精度推到新高度,FlexGlue 则在稀疏到稠密的匹配上做文章[4, 5, 6]。这些方法的共同点是:匹配始终是一个二维问题,几何一致性只能靠 RANSAC 之类的后处理去补。
DUSt3R 换了一个问法[7]:给定两张未标定的图,直接回归两张稠密点图 ,每个像素对应一个三维点,两张图的点都在相机 1 的坐标系里;同时回归一个逐像素置信度 。既然每个像素都有三维坐标,匹配就可以直接在三维空间里做互最近邻:如果像素 的三维点与像素 的三维点互为最近邻,就认为它们对应。这个做法对视角变化极其鲁棒,因为三维点本身就编码了场景几何,Map-free 这种视角变化可达 180° 的基准上,DUSt3R 一度排在榜首。
但「能重建」和「能匹配」是两件事。DUSt3R 的点图是为重建训练的,回归损失只要求三维位置接近,不要求像素级对应准确;一个像素的三维点稍微偏一点,最近邻就可能落到隔壁像素上。更要命的是速度:全图 个像素,每个都要在另一张图的 个点里找最近邻,复杂度 。论文指出,这个匹配步骤比网络前向本身还慢得多——FRM 后来把它加快近两个数量级——而它本来只是重建的副产品。
MASt3R 的判断很直接:匹配需要自己的表示,但这个表示必须长在三维理解上。它在 DUSt3R 的每个解码器输出后面加一个描述子头,输出 24 维的单位向量;用 InfoNCE 在真值对应上显式训练这些描述子;推理时既可以用描述子做快速匹配,也可以保留点图做几何验证。为了让稠密描述子匹配真正可用,论文又提出两个工程部件:快速互最近邻(FRM)和从粗到细(coarse-to-fine)匹配。
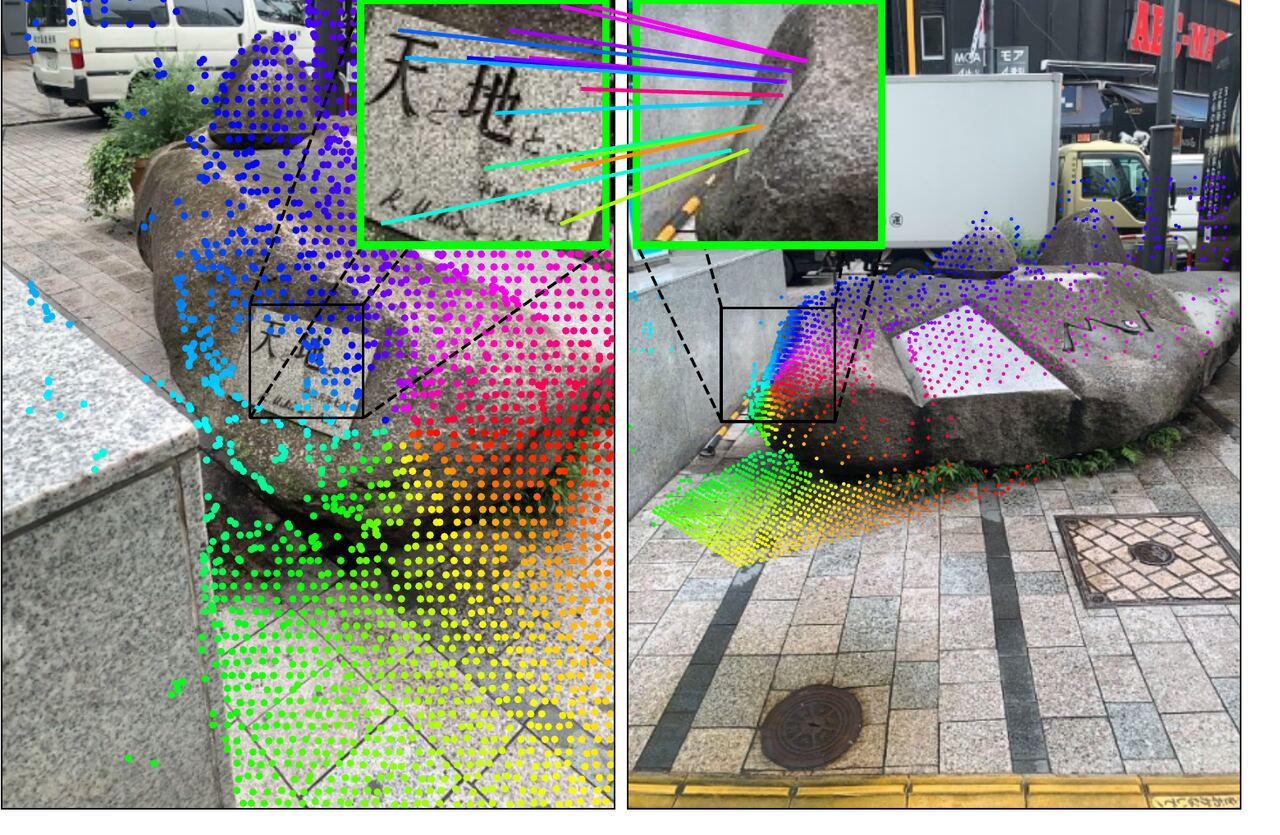
论文把贡献归纳为三点:
- 提出 MASt3R,一个建立在 DUSt3R 之上的三维感知匹配方法;它输出局部描述子图,使匹配既精确又鲁棒。
- 提出 coarse-to-fine 匹配方案与快速互最近邻(FRM),用 个种子点的迭代回投代替全图穷举,复杂度从 降到 ,从而能处理高分辨率图像。
- 在多个绝对/相对位姿定位基准上显著超过当时的最好方法。
按实现拆开看,第一点对应「描述子头 + InfoNCE」,第二点对应「FRM + coarse-to-fine」;这两块构成本文方法的主体。
二、核心方法
2.1 总体架构:一个 decoder,两个头
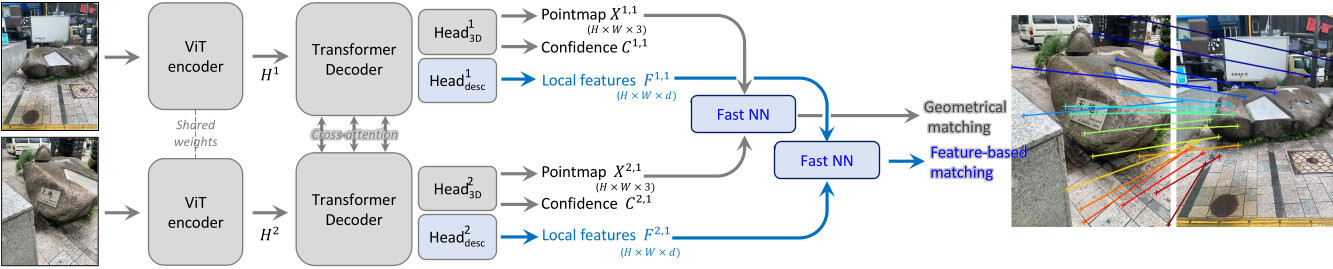
MASt3R 的骨干与 DUSt3R 完全相同:两张图分别过一个 ViT-L 编码器(Siamese,共享权重),得到 token 序列 ;再分别过两个 ViT-B 解码器,两个解码器之间通过 cross-attention 交换信息,输出 。每个头的输入都是编码器与解码器 token 的拼接 ,这样既保留了单图的局部外观,又注入了跨视角的空间关系。
在 DUSt3R 里,这个拼接只送进一个 DPT 头,回归点图和置信度。MASt3R 把它送进两个头:
- 3D 头:DPT 结构,输出 和置信度 ,与 DUSt3R 一致。
- 描述子头:两层 MLP + GELU,输入维度是编码器与解码器的嵌入维度之和(),隐藏层是它的 4 倍,输出维度是 ;经过 pixel-shuffle 上采样 16 倍,得到全分辨率的 维描述子图 ,最后逐像素 L2 归一化。
描述子头用 MLP 而不是 DPT,是有意为之:三维点需要多尺度、空间精细的结构,DPT 合适;局部描述子只需要每个像素附近的表观信息,MLP 足够,而且便宜。两个头共享同一个解码器表示,所以描述子不是另起炉灶的 2D 特征,而是在「已经理解了两视图三维关系」的 token 上读出来的。这也是论文反复强调的「3D-grounded matching」:匹配的判别力来自三维理解,描述子只是把这种判别力压成一个便于快速检索的向量。
为什么是 24 维? 论文只给出 这个设置,并没有做维度消融。从论文和代码能确认的理由有三点。第一,匹配的主要几何信息已经由点图承担,描述子只需要补充局部表观,不需要像传统 2D 描述子那样用 128/256 维硬扛视角和光照。第二,FRM 的复杂度是 ,每次最近邻查询都要算 维距离, 越大,查询越慢、描述子图越占内存;24 维是精度和开销的折中。第三,论文明确指出,24 维时 K-d 树已经因为维度灾难而低效,所以官方实现改用 FAISS[8] 做内积检索;如果维度再高,这个检索会更容易成为瓶颈。下面的部件把这三笔账算清楚:24 维是论文的实际选择,128/256 只是按同一张特征图外推的假想值。
描述子头的实现(原文照录,mast3r/catmlp_dpt_head.py)
class Cat_MLP_LocalFeatures_DPT_Pts3d(PixelwiseTaskWithDPT):
    """ Mixture between MLP and DPT head that outputs 3d points and local features (with MLP).
    The input for both heads is a concatenation of Encoder and Decoder outputs
    """

    def __init__(self, net, has_conf=False, local_feat_dim=16, hidden_dim_factor=4., hooks_idx=None, dim_tokens=None,
                 num_channels=1, postprocess=None, feature_dim=256, last_dim=32, depth_mode=None, conf_mode=None, head_type="regression", **kwargs):
        super().__init__(num_channels=num_channels, feature_dim=feature_dim, last_dim=last_dim, hooks_idx=hooks_idx,
                         dim_tokens=dim_tokens, depth_mode=depth_mode, postprocess=postprocess, conf_mode=conf_mode, head_type=head_type)
        self.local_feat_dim = local_feat_dim

        patch_size = net.patch_embed.patch_size
        if isinstance(patch_size, tuple):
            assert len(patch_size) == 2 and isinstance(patch_size[0], int) and isinstance(
                patch_size[1], int), "What is your patchsize format? Expected a single int or a tuple of two ints."
            assert patch_size[0] == patch_size[1], "Error, non square patches not managed"
            patch_size = patch_size[0]
        self.patch_size = patch_size

        self.desc_mode = net.desc_mode
        self.has_conf = has_conf
        self.two_confs = net.two_confs  # independent confs for 3D regr and descs
        self.desc_conf_mode = net.desc_conf_mode
        idim = net.enc_embed_dim + net.dec_embed_dim

        self.head_local_features = Mlp(in_features=idim,
                                       hidden_features=int(hidden_dim_factor * idim),
                                       out_features=(self.local_feat_dim + self.two_confs) * self.patch_size**2)

    def forward(self, decout, img_shape):
        # pass through the heads
        pts3d = self.dpt(decout, image_size=(img_shape[0], img_shape[1]))

        # recover encoder and decoder outputs
        enc_output, dec_output = decout[0], decout[-1]
        cat_output = torch.cat([enc_output, dec_output], dim=-1)  # concatenate
        H, W = img_shape
        B, S, D = cat_output.shape

        # extract local_features
        local_features = self.head_local_features(cat_output)  # B,S,D
        local_features = local_features.transpose(-1, -2).view(B, -1, H // self.patch_size, W // self.patch_size)
        local_features = F.pixel_shuffle(local_features, self.patch_size)  # B,d,H,W

        # post process 3D pts, descriptors and confidences
        out = torch.cat([pts3d, local_features], dim=1)
        if self.postprocess:
            out = self.postprocess(out,
                                   depth_mode=self.depth_mode,
                                   conf_mode=self.conf_mode,
                                   desc_dim=self.local_feat_dim,
                                   desc_mode=self.desc_mode,
                                   two_confs=self.two_confs,
                                   desc_conf_mode=self.desc_conf_mode)
        return out
2.2 匹配头与 InfoNCE:把「匹配」变成分类
有了描述子图,匹配就是找互最近邻。但要让描述子「可匹配」,必须有监督。论文的做法是从真值点图里挖对应:两张图的真值点图 和 表达在同一坐标系里,若像素 和 的三维点相同,就构成一个正样本对。每个图像对随机抽 4096 个对应;如果正样本不够,就用随机的假对应补齐,保证每次训练看到的正样本比例稳定。
损失用对称的 InfoNCE[9]。把描述子相似度定义为
其中 是温度。对每个正样本 ,损失同时要求「在图像 1 的所有像素里, 是 的最佳匹配」和「在图像 2 的所有像素里, 是 的最佳匹配」:
这和「直接回归对应点坐标」有本质区别:回归只要求落在附近就给低损失,分类则要求在所有候选里把正确像素挑出来,错一个像素就会被 softmax 惩罚。论文的消融也印证了这一点:同样的骨干,用描述子匹配(IV)比用三维点匹配(II)的位姿 AUC 从 0.409 提到 0.435,VCRE AUC 从 0.732 提到 0.752。
3D 分支仍然保留 DUSt3R 的置信度感知回归损失:
其中 是尺度归一化后的三维距离,。对 metric 真值的数据集,预测不再做尺度归一化(令 ),这样网络输出的就是米制深度——Map-free 这类需要绝对尺度的任务直接受益。总损失是
训练细节如下:从公开的 DUSt3R 权重初始化;14 个数据集混合(Habitat、ARKitScenes、BlendedMVS、MegaDepth、Static Scenes 3D、ScanNet++、CO3Dv2、Waymo、Map-free、WildRgb、Virtual Kitti、Unreal4K、TartanAir 和一个内部数据集,其中 10 个有 metric 真值);每个 epoch 采样 65 万对,batch size 64,训练 35 个 epoch,AdamW,学习率 ,cosine 调度,warmup 7 个 epoch;输入分辨率在 、、、、 之间随机,最长边 512;训练时做随机裁剪并用单应变换保持主点居中,让网络见过不同尺度,为 coarse-to-fine 做准备。,,,。
这里有两个读代码时值得留意的细节。第一,论文 Eq. (8) 把相似度印成 ,但官方实现是 sim = desc1 @ desc2.T / temperature 再取 exp,也就是温度在分母、指数为正相似度;按代码理解即可。第二,仓库 README 的复现命令用的是 InfoNCE(mode='proper', temperature=0.05)、50 个 epoch、warmup 8、匹配损失权重 0.075,和论文设置的 、35 个 epoch、warmup 7、 并不完全一致。论文数字以论文为准,复现时以 README 为准,两者不要混用。
InfoNCE 的实现(原文照录,mast3r/losses.py)
class InfoNCE(MatchingCriterion):
    def __init__(self, temperature=0.07, eps=1e-8, mode='all', **kwargs):
        super().__init__(**kwargs)
        self.temperature = temperature
        self.eps = eps
        assert mode in ['all', 'proper', 'dual']
        self.mode = mode

    def loss(self, desc1, desc2, valid_matches=None, euc=False):
        # valid positives are along diagonals
        B, N, D = desc1.shape
        B2, N2, D2 = desc2.shape
        assert B == B2 and D == D2
        if valid_matches is None:
            valid_matches = torch.ones([B, N], dtype=bool)
        # torch.all(valid_matches.sum(dim=-1) > 0) some pairs have no matches????
        assert valid_matches.shape == torch.Size([B, N]) and valid_matches.sum() > 0

        # Tempered similarities
        sim = get_similarities(desc1, desc2, euc) / self.temperature
        sim[sim.isnan()] = -torch.inf  # ignore nans
        # Softmax of positives with temperature
        sim = sim.exp_()  # save peak memory
        positives = sim.diagonal(dim1=-2, dim2=-1)

        # Loss
        if self.mode == 'all':            # Previous InfoNCE
            loss = -torch.log((positives / sim.sum(dim=-1).sum(dim=-1, keepdim=True)).clip(self.eps))
        elif self.mode == 'proper':  # Proper InfoNCE
            loss = -(torch.log((positives / sim.sum(dim=-2)).clip(self.eps)) +
                     torch.log((positives / sim.sum(dim=-1)).clip(self.eps)))
        elif self.mode == 'dual':  # Dual Softmax
            loss = -(torch.log((positives**2 / sim.sum(dim=-1) / sim.sum(dim=-2)).clip(self.eps)))
        else:
            raise ValueError("This should not happen...")
        return loss[valid_matches]
消融还说明「只在匹配损失上训练」是不够的:III 只训练 ,位姿 AUC 0.382,旋转中位误差 10.8°;IV 同时训练 3D 和匹配,位姿 AUC 0.435,旋转中位误差 3.0°。也就是说,匹配精度并不是靠把匹配任务单独做大,而是靠三维重建这个辅助任务把表示约束住。这正是标题里「grounding in 3D」的含义。
2.3 快速互最近邻:把 降到
描述子有了,下一步是找互最近邻。对每个像素 ,在另一张图里找最近邻 ;再对结果反查 ,若回到 ,就是一个互最近邻。全图做这件事的复杂度是 ——对 的图像是约 400 亿次距离计算,比网络前向还慢。
FRM 的思路是「只查询一小部分种子,让它们自己收敛」。具体地:
- 在图像 1 上按规则网格取 个种子 ;
- 把 映射到图像 2 的最近邻 ;
- 再把 映射回图像 1 的最近邻 ;
- 若 ,说明形成环,得到一个互最近邻;把已收敛的点从活跃集合里删掉;
- 对剩下的活跃点重复,最多 10 轮。
复杂度是 ,因为每轮只查询 个点,而不是 个;相对全量匹配快 倍。输出是全部环的并集 ,大小满足 ——种子最多只能生成 个互最近邻。
这个算法为什么一定收敛?补充材料给了一个很漂亮的证明。把两张图之间的最近邻关系看成一个有向二部图 :每个像素只有一条出边,指向另一张图里的最近邻。于是每个连通分量只有两种形态:要么本身就是一个环,要么是一棵「树」,所有节点沿着唯一的路径走向根部的环。沿着路径走,相似度是单调不减的:如果 ,而 是 的最近邻,那么 ;继续展开就得到一条单调递增的相似度序列。节点数有限,序列必然到达最大值,而最大相似度的那对节点必然互为最近邻,形成环。因此无论从哪个种子出发,FRM 都会收敛到一个互最近邻,不会死循环。四节点以上的环需要多个相似度精确相等,在实数 24 维描述子下可以忽略。
更有意思的是,FRM 不仅更快,精度还更高。原因是「收敛盆地」:很多种子会沿着不同的路径汇聚到同一个环,环对应的匹配就像一个盆地。盆越大,说明这个匹配越独特、越容易吸引周围的点;FRM 按盆地大小隐式采样,得到的匹配在空间上比全量匹配更均匀。全量匹配里,纹理密集的区域会产生大量挤在一起的匹配,RANSAC 估计本质矩阵时会被这些点主导;FRM 的均匀分布反而让 RANSAC 更稳。补充材料做了对照:对全量匹配随机下采样到同样数量,性能会灾难性下降;按盆地大小偏置地下采样,性能甚至超过全量匹配;FRM 的结果紧贴后者,但只需要后者的一小部分计算。
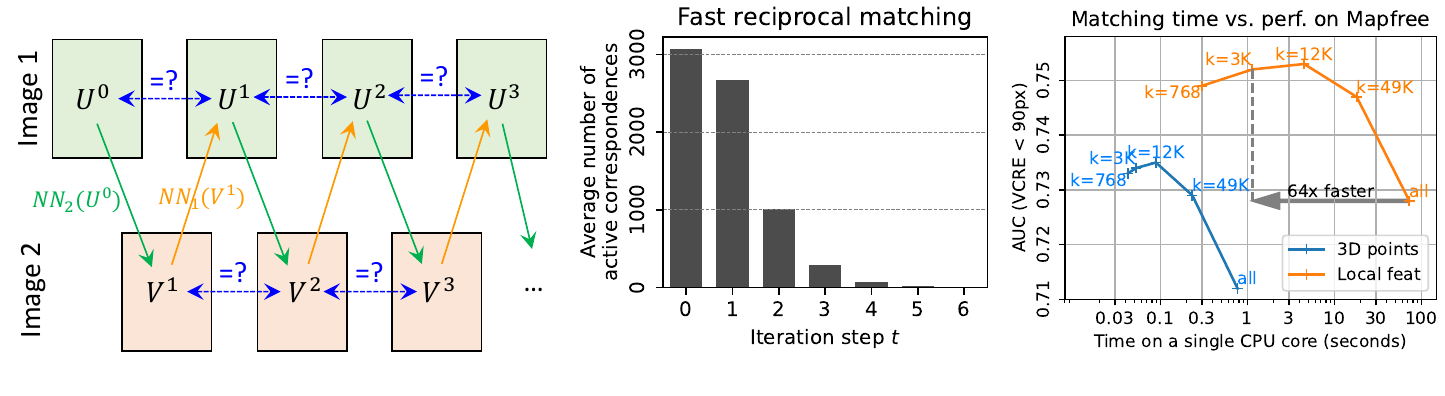
论文默认 。在 720×540 的 Map-free 图像上,这比全量匹配快 64 倍,同时精度没有下降(表 2 的 VCRE AUC 为 0.933)。下图把「种子数—理论加速比—参与查询的像素比例」三者的关系画出来;注意理论值 是上界,实际加速比会因建树和查询开销打折扣,论文测到的 64× 对应理论上的约 130×。
FRM 的实现(原文节选,mast3r/fast_nn.py;略去文件头的 import 与 merge_corres 辅助函数)
def fast_reciprocal_NNs(pts1, pts2, subsample_or_initxy1=8, ret_xy=True, pixel_tol=0, ret_basin=False,
                        device='cuda', **matcher_kw):
    H1, W1, DIM1 = pts1.shape
    H2, W2, DIM2 = pts2.shape
    assert DIM1 == DIM2

    pts1 = pts1.reshape(-1, DIM1)
    pts2 = pts2.reshape(-1, DIM2)

    if isinstance(subsample_or_initxy1, int) and pixel_tol == 0:
        S = subsample_or_initxy1
        y1, x1 = np.mgrid[S // 2:H1:S, S // 2:W1:S].reshape(2, -1)
        max_iter = 10
    else:
        x1, y1 = subsample_or_initxy1
        if isinstance(x1, torch.Tensor):
            x1 = x1.cpu().numpy()
        if isinstance(y1, torch.Tensor):
            y1 = y1.cpu().numpy()
        max_iter = 1

    xy1 = np.int32(np.unique(x1 + W1 * y1))  # make sure there's no doublons
    xy2 = np.full_like(xy1, -1)
    old_xy1 = xy1.copy()
    old_xy2 = xy2.copy()

    if 'dist' in matcher_kw or 'block_size' in matcher_kw \
            or (isinstance(device, str) and device.startswith('cuda')) \
            or (isinstance(device, torch.device) and device.type.startswith('cuda')):
        pts1 = pts1.to(device)
        pts2 = pts2.to(device)
        tree1 = cdistMatcher(pts1, device=device)
        tree2 = cdistMatcher(pts2, device=device)
    else:
        pts1, pts2 = to_numpy((pts1, pts2))
        tree1 = KDTree(pts1)
        tree2 = KDTree(pts2)

    notyet = np.ones(len(xy1), dtype=bool)
    basin = np.full((H1 * W1 + 1,), -1, dtype=np.int32) if ret_basin else None

    niter = 0
    # n_notyet = [len(notyet)]
    while notyet.any():
        _, xy2[notyet] = to_numpy(tree2.query(pts1[xy1[notyet]], **matcher_kw))
        if not ret_basin:
            notyet &= (old_xy2 != xy2)  # remove points that have converged

        _, xy1[notyet] = to_numpy(tree1.query(pts2[xy2[notyet]], **matcher_kw))
        if ret_basin:
            basin[old_xy1[notyet]] = xy1[notyet]
        notyet &= (old_xy1 != xy1)  # remove points that have converged

        # n_notyet.append(notyet.sum())
        niter += 1
        if niter >= max_iter:
            break

        old_xy2[:] = xy2
        old_xy1[:] = xy1

    # print('notyet_stats:', ' '.join(map(str, (n_notyet+[0]*10)[:max_iter])))

    if pixel_tol > 0:
        # in case we only want to match some specific points
        # and still have some way of checking reciprocity
        old_yx1 = np.unravel_index(old_xy1, (H1, W1))[0].base
        new_yx1 = np.unravel_index(xy1, (H1, W1))[0].base
        dis = np.linalg.norm(old_yx1 - new_yx1, axis=-1)
        converged = dis < pixel_tol
        if not isinstance(subsample_or_initxy1, int):
            xy1 = old_xy1  # replace new points by old ones
    else:
        converged = ~notyet  # converged correspondences

    # keep only unique correspondences, and sort on xy1
    xy1, xy2 = merge_corres(xy1[converged], xy2[converged], (H1, W1), (H2, W2), ret_xy=ret_xy)
    if ret_basin:
        return xy1, xy2, basin
    return xy1, xy2
2.4 从粗到细:512 像素的模型也能匹配百万像素图像
MASt3R 的注意力复杂度随图像面积平方增长,训练和推理都把最长边限制在 512 像素。直接把 1MP 图像缩到 512 再匹配,精度会掉——尤其在下游定位和重建里,几个像素的误差就足以让位姿或三角化崩掉。
coarse-to-fine 的做法是:
- 先把两张图缩到最长边 512,跑一次 MASt3R + FRM,得到一组粗匹配 ;
- 在两张原图上分别铺一组 512 像素的窗口,相邻窗口重叠 50%;
- 枚举所有窗口对 ,每个窗口对根据「落在两个窗口里的粗匹配」得到一个权重;
- 贪心地逐个选窗口对,直到覆盖 90% 的粗匹配;
- 对每个选中的窗口对单独跑 MASt3R + FRM,把结果映射回原图坐标并合并。
第 4 步的贪心很关键:窗口对的数量是窗口数的平方,全跑一遍并不便宜;但绝大多数窗口对只包含很少的粗匹配,真正需要精化的只是少数。按覆盖率选,既保证每个粗匹配至少被一个窗口对照顾到,又避免在空白区域浪费计算。
coarse-to-fine 的贪心选择(原文节选,mast3r/utils/coarse_to_fine.py)
def greedy_selection(corres_weights, target=0.9):
    # corres_weight = (n_cell_pair, n_corres) matrix.
    # If corres_weight[c,p]>0, means that correspondence p is visible in cell pair p
    assert 0 < target <= 1
    corres_weights = corres_weights.copy()

    total = corres_weights.max(axis=0).sum()
    target *= total

    # init = empty
    res = []
    cur = np.zeros(corres_weights.shape[1])  # current selection

    while cur.sum() < target:
        # pick the nex best cell pair
        best = corres_weights.sum(axis=1).argmax()
        res.append(best)

        # update current
        cur += corres_weights[best]
        # print('appending', best, 'with score', corres_weights[best].sum(), '-->', cur.sum())

        # remove from all other views
        corres_weights = (corres_weights - corres_weights[best]).clip(min=0)

    return res
论文没有给 coarse-to-fine 的单独加速比,只说它让高分辨率图像的匹配成为可能;补充材料的失败分析指出,细匹配在重复纹理上会丢失全局上下文,这是它的代价(见第四节)。
三、实验:从 Map-free 到 DTU
3.1 Map-free:30 个点的绝对提升
Map-free 是论文最看重的基准[10]:给定一张参考图和一张查询图,要求估计查询图相对参考图的米制位姿;没有地图、没有多视图,视角变化可达 180°。图像分辨率约 720×540,已经接近 MASt3R 的工作分辨率,所以这里不用 coarse-to-fine,直接用 的 FRM。
测试集结果(VCRE 重投影误差、位姿精度):
| 方法 | VCRE 重投影 ↓ | VCRE 精度 ↑ | VCRE AUC ↑ | 位姿中位误差 ↓ | 位姿精度 ↑ | 位姿 AUC ↑ |
|---|---|---|---|---|---|---|
| LoFTR + KBR | 165.0 px | 34.3% | 0.634 | 2.23 m / 37.8° | 11.0% | 0.295 |
| DUSt3R | 116.0 px | 50.3% | 0.697 | 0.97 m / 7.1° | 21.6% | 0.394 |
| MASt3R(自动深度) | 48.7 px | 79.3% | 0.933 | 0.36 m / 2.2° | 54.7% | 0.740 |
| MASt3R(DPT-KITTI 深度) | 104.0 px | 54.2% | 0.726 | 0.80 m / 2.2° | 27.0% | 0.456 |
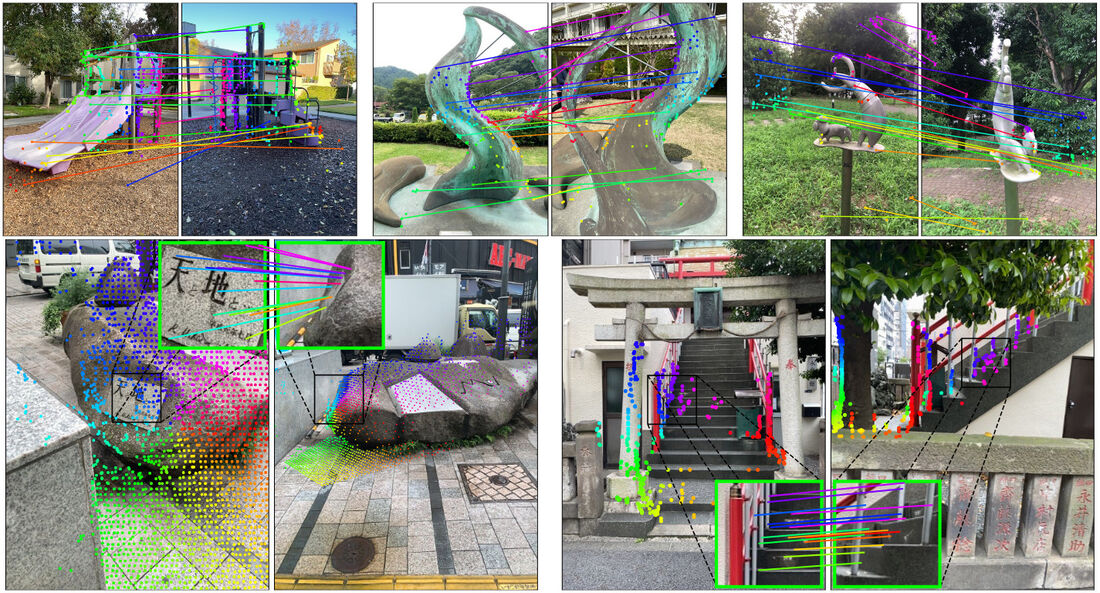
VCRE AUC 从 DUSt3R 的 0.697 提到 0.933,相对 LoFTR+KBR 的 0.634 是 约 30 个百分点的绝对提升;位姿中位误差从 0.97 m / 7.1° 降到 0.36 m / 2.2°。注意最后一行:即使把 MASt3R 的深度换成外部的 DPT-KITTI、只使用它纯匹配的那部分能力,AUC 也达到 0.726,超过所有已发表的 2D 匹配方法——这说明提升不只来自「会预测米制深度」,匹配本身确实变强了。
一个反直觉的结果是「直接回归」:不做匹配,直接用点图 做 PnP,VCRE AUC 0.941、位姿 AUC 0.777,和匹配版(0.933 / 0.740)不相上下甚至更高。论文的解释是 Map-free 场景小、深度可靠,直接回归的误差被场景尺度掩盖了。但到了 Aachen 这种大场景,直接回归立刻崩掉(见 3.3),所以论文的结论是:匹配 + PnP 更通用,直接回归只在特定尺度下好用。
3.2 相对位姿:CO3Dv2 与 RealEstate10K
CO3Dv2 和 RealEstate10K 是相对位姿的标准基准:每个序列取 10 帧,评测所有 45 个图像对,不使用真值焦距。指标是 RRA@15、RTA@15 和 mAA(30)。
| 方法 | CO3Dv2 RRA@15 ↑ | CO3Dv2 RTA@15 ↑ | CO3Dv2 mAA(30) ↑ | RealEstate10K mAA(30) ↑ |
|---|---|---|---|---|
| DUSt3R | 94.3 | 88.4 | 77.2 | 61.2 |
| MASt3R | 94.6 | 91.9 | 81.8 | 76.4 |
CO3Dv2 的旋转精度两者接近(94.3 vs 94.6),但平移精度和整体 mAA 拉开差距;RealEstate10K 上 MASt3R 的 mAA 比 DUSt3R 高 15.2 个点,比最好的多视图方法(67.7)还高 8.7 个点。这里要注意对比条件:MASt3R 始终是成对预测,而表里的多视图方法(RelPose++、PoseDiff、RayDiff)用了 8 到 10 帧;论文特意强调,即便如此,MASt3R 仍然领先。
3.3 视觉定位:Aachen 与 InLoc
Aachen Day-Night[11] 是室外长期定位基准:4,328 张参考图,824 张白天查询、98 张夜间查询;指标是三个误差阈值下的定位成功率。InLoc[12] 是室内基准,外观变化更剧烈。
MASt3R 的结果(top1 / top20 / top40 检索图数量):
| 方法 | Aachen 白天 | Aachen 夜间 | InLoc DUC1 | InLoc DUC2 |
|---|---|---|---|---|
| DUSt3R top1 | 72.7/89.6/98.1 | 59.7/80.1/93.2 | 36.4/55.1/66.7 | 27.5/42.7/49.6 |
| DUSt3R top20 | 79.4/94.3/99.5 | 74.9/91.1/99.0 | 53.0/74.2/89.9 | 61.8/77.1/84.0 |
| MASt3R top1 | 79.6/93.5/98.7 | 70.2/88.0/97.4 | 41.9/64.1/73.2 | 38.9/55.7/62.6 |
| MASt3R top20 | 83.4/95.3/99.4 | 76.4/91.6/100 | 55.1/77.8/90.4 | 71.0/84.7/89.3 |
| MASt3R top40 | 82.2/93.9/99.5 | 75.4/91.6/100 | 56.1/79.3/90.9 | 71.0/87.0/91.6 |
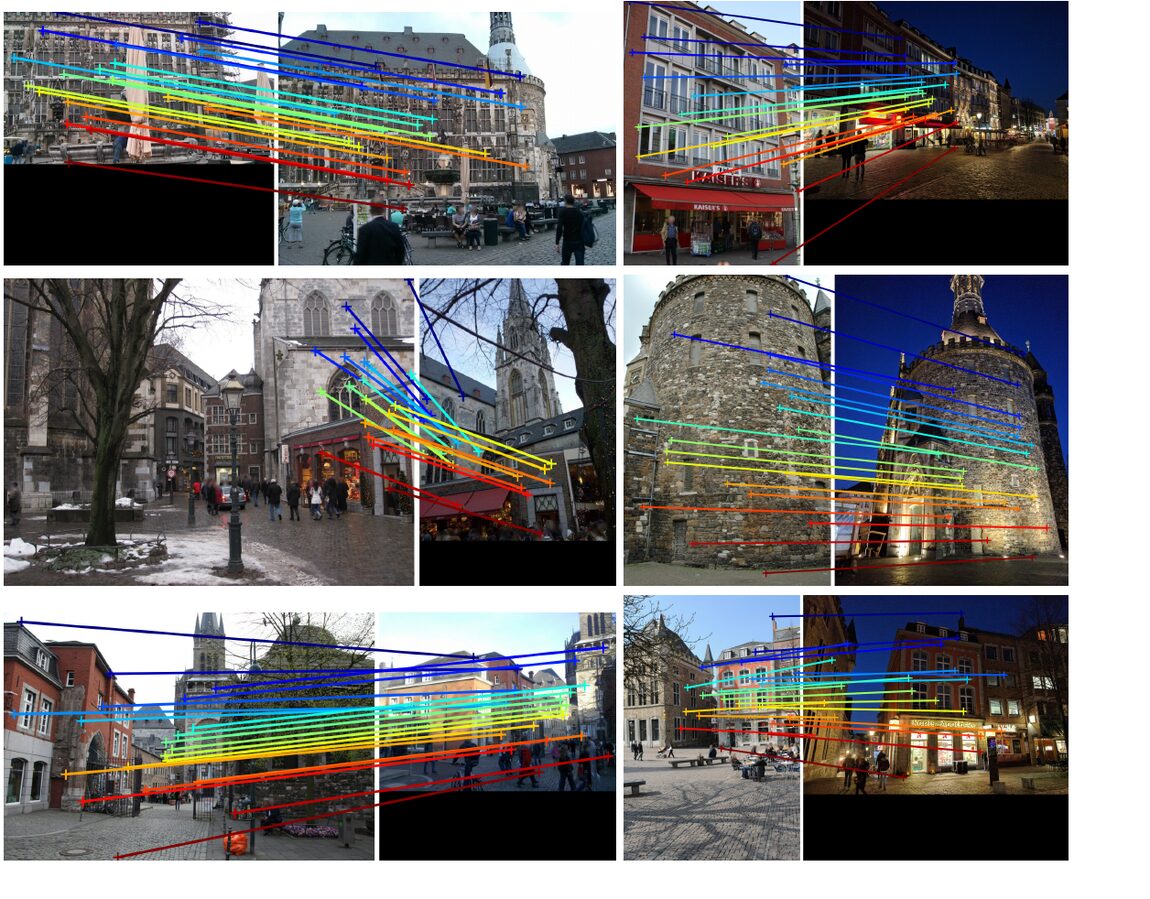
只用一张参考图(top1)时,MASt3R 在 Aachen 夜间达到 70.2/88.0/97.4,比 DUSt3R top1 的 59.7/80.1/93.2 高出一大截;InLoc DUC1 的 top1 也从 36.4/55.1/66.7 提到 41.9/64.1/73.2。top20 时夜间三个阈值做到 76.4/91.6/100,InLoc DUC2 的首个阈值从 61.8 提到 71.0。top40 在 Aachen 白天的首阈值反而略低于 top20(82.2 vs 83.4),说明检索图不是越多越好,低质量的参考图会引入噪声——这是所有 retrieval-based 定位流程的通病,不是 MASt3R 独有的。
注意表格每格是 (0.25m, 2°) / (0.5m, 5°) / (1m, 10°) 三个阈值下的定位成功率。
同一张表里还有「直接回归 top1」:Aachen 白天只有 1.5/4.5/60.7,夜间 1.6/4.2/47.6;InLoc 13.1/32.3/58.1 和 10.7/26.0/38.2。大场景的尺度误差直接把直接回归打穿,这也是论文坚持「匹配 + PnP」的原因。
3.4 多视图重建:DTU 零样本
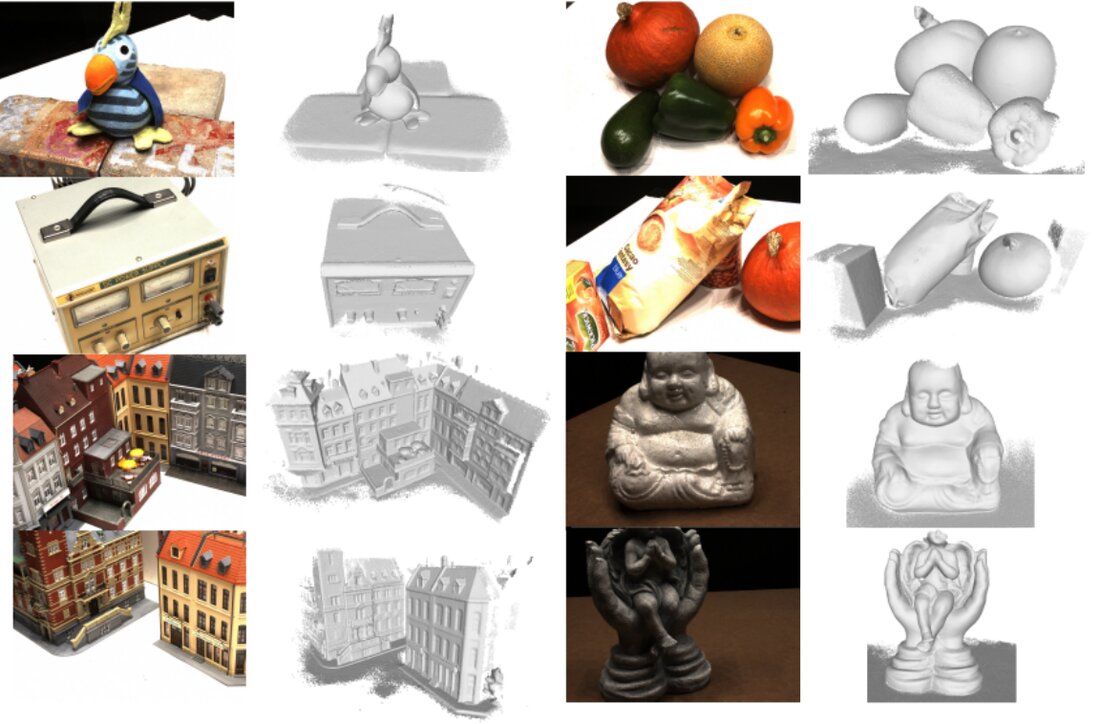
DTU[13] 是受控环境下的多视图立体基准。论文的做法是:用 MASt3R 在图像对之间做全分辨率匹配,用真值相机三角化,再用几何一致性后处理去掉离群点;不在 DTU 上训练或微调。指标是毫米级的 accuracy、completeness 和 Chamfer。
| 方法 | 训练方式 | Accuracy ↓ | Completeness ↓ | Overall ↓ |
|---|---|---|---|---|
| DUSt3R | 零样本 | 2.677 | 1.741 | 0.805 |
| PatchmatchNet | 在 DTU 训练 | 0.427 | 0.277 | 0.352 |
| GeoMVSNet | 在 DTU 训练 | 0.331 | 0.259 | 0.295 |
| MASt3R | 零样本 | 0.403 | 0.344 | 0.374 |
MASt3R 的 Chamfer 从 DUSt3R 的 0.805 mm 降到 0.374 mm,已经接近在 DTU 上专门训练的 PatchmatchNet(0.352)和 GeoMVSNet(0.295),而它没有见过 DTU 的相机设置、也没有用相机标定或位姿去辅助匹配。这张表是「匹配精度 + 三维一致性」最直接的证据:只有匹配足够准,三角化出来的点云才能到这个水平。
3.5 速度与消融
速度方面,论文给出的硬数字是 Map-free 上 比全量互最近邻快 64 倍,同时精度更高;理论上 FRM 的复杂度是 ,全量是 ,加速比 。论文没有在正文给固定硬件上的绝对毫秒数,速度以单 CPU 核心上的相对曲线和 64× 呈现;不同硬件和实现下绝对值会变,64× 是同一套代码内的相对值。
消融的核心结论已经在 2.2 里出现过,这里集中列一下(Map-free 验证集,I–IV 用 DPT-KITTI 深度,V 用 MASt3R 自己的深度):
| 变体 | 匹配对象 | VCRE AUC ↑ | 位姿 AUC ↑ | 旋转中位误差 ↓ |
|---|---|---|---|---|
| I:DUSt3R | 3D 点 | 0.704 | 0.344 | 9.4° |
| II:MASt3R | 3D 点 | 0.732 | 0.409 | 3.6° |
| III:只训练匹配损失 | 描述子 | 0.744 | 0.382 | 10.8° |
| IV:3D + 匹配联合 | 描述子 | 0.752 | 0.435 | 3.0° |
| V:IV + 自动米制深度 | 描述子 | 0.934 | 0.746 | 3.0° |
三条结论:描述子匹配优于三维点匹配(II vs IV);联合训练优于只训练匹配(III vs IV);米制深度显著提升定位(IV vs V,VCRE AUC 从 0.752 跳到 0.934)。最后一条尤其重要——它说明 MASt3R 的深度和匹配不是两个独立任务,而是共享同一个三维表示的两个出口。
四、局限性
论文在补充材料里列了四条局限,我照录并补充几条自己的观察。
作者承认的局限:
- 米制深度的可靠性。MASt3R 是首个在双目设置下做米制深度预测的方法,但本质上仍是数据驱动的,依赖训练分布的先验;在训练没覆盖的相机、尺度或场景上,米制深度没有理论保证。
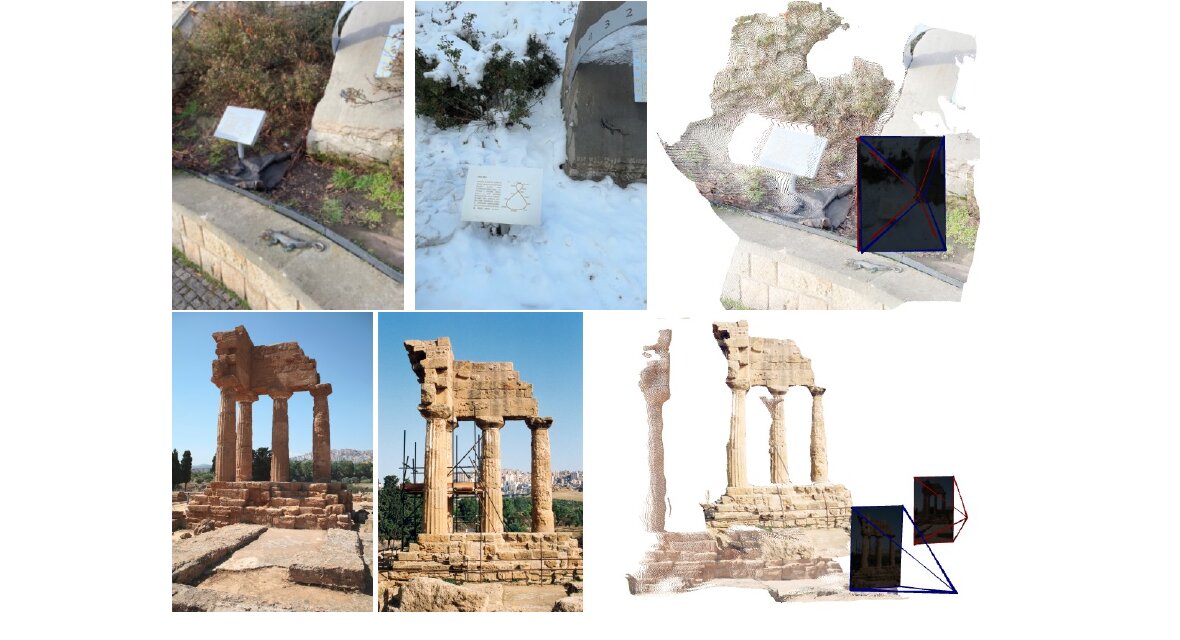
- 对剧烈变化不够鲁棒。论文说它能处理中等程度的变化(比如日夜),但遇到季节变化、施工脚手架这类显著变化会明显失败。原因是训练数据以静态、三维一致的数据为主,网络学会了拒绝「看起来像但几何不一致」的图像对;夏季/冬季的同一景点在它眼里就属于这一类。图 7 是论文给的两个例子:上排是季节变化导致相机估计错误,下排是脚手架导致场景变化。
- coarse-to-fine 在重复纹理上会失效。细匹配提升了精度,却丢掉了全局上下文;面对重复的窗户、栏杆、瓷砖,局部窗口无法判断自己对应的是哪一个重复单元,匹配变成病态问题。
- 可扩展性。论文只做成对匹配;要扩展到大规模图像集合,需要把 DUSt3R 的全局对齐接上来,但成对推理的成本随图像数量平方增长,除非先用检索剪枝。MASt3R-SfM 后来正是沿着这条路线做的。
我补充的观察:
- 分辨率上限。原生训练和推理都是最长边 512;coarse-to-fine 能缓解,但它不是免费的,窗口对的数量和重叠率都会影响速度。真实的高分辨率重建(比如 4K 航拍)仍需要更细的窗口策略。
- 24 维没有消融。论文只报了 ,没有 128/256 的对照;24 维好用不等于 24 维最优。如果下游需要更强的描述子判别力(比如大规模地点识别),维度可能要重新调。
- 内存账。 的图像,24 维描述子是每张 18.9 MB(fp32),两张 37.7 MB;128 维时两张就是 201 MB。论文的 FRM 只查询 3000 个种子,但描述子图本身要完整保留。这在嵌入式设备上不是小数目。
- 没有 MegaDepth-1500 位姿评测。论文的位姿实验集中在 Map-free、CO3Dv2/RealEstate10K 和 Aachen/InLoc,没有报告 MegaDepth-1500 的 AUC@5/10/20。如果读者在其他论文或复现里看到 MASt3R 的 MegaDepth 数字,它们通常来自不同的评测脚本和协议,不能直接和 DUSt3R 原论文的 MegaDepth 表横比;本文因此不列这张表。
- 许可证。代码和权重是 CC BY-NC-SA 4.0,非商用;训练数据(尤其 Map-free)还有各自的限制。商用落地要逐项确认。
五、结论与展望
MASt3R 的论点可以压缩成一句话:匹配本质上是一个三维问题,但三维重建本身并不自动给出好的匹配。DUSt3R 证明了点图可以做匹配,MASt3R 则证明了「在三维表示上再加一个显式匹配头」能把匹配从「能用」推到「好用」:InfoNCE 让描述子学会精确区分像素,FRM 让稠密匹配变得可负担,coarse-to-fine 让 512 像素的模型能处理高分辨率图像。
从结果看,它在 Map-free 上把 VCRE AUC 从 0.697 拉到 0.933,在 DTU 零样本重建上把 Chamfer 从 0.805 mm 降到 0.374 mm,在 Aachen 夜间 top1 做到 70.2/88.0/97.4;同时保留了 DUSt3R 的几何一致性,不需要 RANSAC 之外的额外几何后处理。对实践者来说,最有价值的三个开关是:
- :匹配数量与速度的旋钮,默认 3000,场景越大小心调大。
--coarse_to_fine:高分辨率图像必开,512 像素以下可以关掉省时间。- 深度模式:要米制位姿就用自动深度,要纯匹配对比就用外部 DPT。
往后看,MASt3R 留下的方向也很清楚。MASt3R-SfM[14] 已经把成对匹配接到全局对齐上,做成完整的无约束 SfM;RoMa v2、FlexGlue 等工作则在匹配的精度、效率或灵活性上继续推进。一个自然的下一步是把 MASt3R 的三维先验和这些匹配器的稀疏/稠密查询机制结合起来:既保留三维一致性,又把计算集中到真正需要的区域。另一个方向是长期变化——论文的失败案例说明,纯数据驱动的模型对季节和施工变化仍然脆弱,更多样的训练数据或在线自适应的几何校验可能是解药。
六、上手
官方仓库提供了完整的推理、训练和视觉定位脚本。安装步骤按 README 走(conda + PyTorch + ASMK):
安装 MASt3R
git clone --recursive https://github.com/naver/mast3r
cd mast3r

conda create -n mast3r python=3.11 cmake=3.14.0
conda activate mast3r
conda install pytorch torchvision pytorch-cuda=12.1 -c pytorch -c nvidia  # use the correct version of cuda for your system
pip install -r requirements.txt
pip install -r dust3r/requirements.txt
pip install -r dust3r/requirements_optional.txt

# ASMK,用于视觉定位的检索
pip install cython
git clone https://github.com/jenicek/asmk
cd asmk/cython/
cythonize *.pyx
cd ..
pip install .
权重可以用 Hugging Face 自动下载,也可以手动放到 checkpoints/:
下载权重
mkdir -p checkpoints/
wget https://download.europe.naverlabs.com/ComputerVision/MASt3R/MASt3R_ViTLarge_BaseDecoder_512_catmlpdpt_metric.pth -P checkpoints/
最小匹配示例(原文节选:保留了模型加载、推理、描述子提取、FRM 和边界过滤,略去可视化部分):
两张图的匹配
from mast3r.model import AsymmetricMASt3R
from mast3r.fast_nn import fast_reciprocal_NNs

import mast3r.utils.path_to_dust3r
from dust3r.inference import inference
from dust3r.utils.image import load_images

if __name__ == '__main__':
    device = 'cuda'
    model_name = "naver/MASt3R_ViTLarge_BaseDecoder_512_catmlpdpt_metric"
    # you can put the path to a local checkpoint in model_name if needed
    model = AsymmetricMASt3R.from_pretrained(model_name).to(device)
    images = load_images(['dust3r/croco/assets/Chateau1.png', 'dust3r/croco/assets/Chateau2.png'], size=512)
    output = inference([tuple(images)], model, device, batch_size=1, verbose=False)

    # at this stage, you have the raw dust3r predictions
    view1, pred1 = output['view1'], output['pred1']
    view2, pred2 = output['view2'], output['pred2']

    desc1, desc2 = pred1['desc'].squeeze(0).detach(), pred2['desc'].squeeze(0).detach()

    # find 2D-2D matches between the two images
    matches_im0, matches_im1 = fast_reciprocal_NNs(desc1, desc2, subsample_or_initxy1=8,
                                                   device=device, dist='dot', block_size=2**13)

    # ignore small border around the edge
    H0, W0 = view1['true_shape'][0]
    valid_matches_im0 = (matches_im0[:, 0] >= 3) & (matches_im0[:, 0] < int(W0) - 3) & (
        matches_im0[:, 1] >= 3) & (matches_im0[:, 1] < int(H0) - 3)

    H1, W1 = view2['true_shape'][0]
    valid_matches_im1 = (matches_im1[:, 0] >= 3) & (matches_im1[:, 0] < int(W1) - 3) & (
        matches_im1[:, 1] >= 3) & (matches_im1[:, 1] < int(H1) - 3)

    valid_matches = valid_matches_im0 & valid_matches_im1
    matches_im0, matches_im1 = matches_im0[valid_matches], matches_im1[valid_matches]
训练一个 demo(CO3D 子集,4 卡):
训练命令(demo 设置)
# download and prepare the co3d subset
mkdir -p data/co3d_subset
cd data/co3d_subset
git clone https://github.com/facebookresearch/co3d
cd co3d
python3 ./co3d/download_dataset.py --download_folder ../ --single_sequence_subset
rm ../*.zip
cd ../../..
python3 datasets_preprocess/preprocess_co3d.py --co3d_dir data/co3d_subset --output_dir data/co3d_subset_processed --single_sequence_subset

# download the pretrained dust3r checkpoint
mkdir -p checkpoints/
wget https://download.europe.naverlabs.com/ComputerVision/DUSt3R/DUSt3R_ViTLarge_BaseDecoder_512_dpt.pth -P checkpoints/

torchrun --nproc_per_node=4 train.py \
    --train_dataset "1000 @ Co3d(split='train', ROOT='data/co3d_subset_processed', aug_crop='auto', aug_monocular=0.005, aug_rot90='diff', mask_bg='rand', resolution=[(512, 384), (512, 336), (512, 288), (512, 256), (512, 160)], n_corres=8192, nneg=0.5, transform=ColorJitter)" \
    --test_dataset "100 @ Co3d(split='test', ROOT='data/co3d_subset_processed', resolution=(512,384), n_corres=1024, seed=777)" \
    --model "AsymmetricMASt3R(pos_embed='RoPE100', patch_embed_cls='ManyAR_PatchEmbed', img_size=(512, 512), head_type='catmlp+dpt', output_mode='pts3d+desc24', depth_mode=('exp', -inf, inf), conf_mode=('exp', 1, inf), enc_embed_dim=1024, enc_depth=24, enc_num_heads=16, dec_embed_dim=768, dec_depth=12, dec_num_heads=12, two_confs=True)" \
    --train_criterion "ConfLoss(Regr3D(L21, norm_mode='?avg_dis'), alpha=0.2) + 0.075*ConfMatchingLoss(MatchingLoss(InfoNCE(mode='proper', temperature=0.05), negatives_padding=0, blocksize=8192), alpha=10.0, confmode='mean')" \
    --test_criterion "Regr3D_ScaleShiftInv(L21, norm_mode='?avg_dis', gt_scale=True, sky_loss_value=0) + -1.*MatchingLoss(APLoss(nq='torch', fp=torch.float16), negatives_padding=12288)" \
    --pretrained "checkpoints/DUSt3R_ViTLarge_BaseDecoder_512_dpt.pth" \
    --lr 0.0001 --min_lr 1e-06 --warmup_epochs 1 --epochs 10 --batch_size 4 --accum_iter 4 \
    --save_freq 1 --keep_freq 5 --eval_freq 1 --disable_cudnn_benchmark \
    --output_dir "checkpoints/mast3r_demo"
Aachen 视觉定位(top20 检索 + coarse-to-fine):
Aachen Day-Night 定位
python3 visloc.py --model_name MASt3R_ViTLarge_BaseDecoder_512_catmlpdpt_metric \
    --dataset "VislocAachenDayNight('/path/to/prepared/Aachen-Day-Night-v1.1/', subscene='night', pairsfile='fire_top50', topk=20)" \
    --pixel_tol 5 --pnp_mode poselib --reprojection_error_diag_ratio 0.008 \
    --output_dir /path/to/output/Aachen-Day-Night-v1.1/night/loc \
    --coarse_to_fine --max_batch_size 48 --c2f_crop_with_homography
几个实用提醒:
- 论文的完整训练用 14 个数据集、65 万对/epoch、35 个 epoch;README 的正式超参用的是 50 个 epoch、warmup 8、、匹配损失权重 0.075,和论文不完全一致。复现论文数字时不要混用两套配置。
- 权重是 CC BY-NC-SA 4.0,非商用;Map-free 等数据集还有各自的许可证,训练前要逐项确认。
- 视觉定位脚本依赖 ASMK 和检索文件;Aachen 的
database_and_query_images.zip需要手动下载,具体步骤在 DUSt3R 的dust3r_visloc/README.md。 - 如果只想快速试匹配,不必装 ASMK:上面的最小示例只依赖模型、
dust3r和fast_nn.py。
参考
- Leroy, Cabon, Revaud. Grounding Image Matching in 3D with MASt3R. ECCV 2024. arXiv · 代码
- Sun, Shen, Wang, Bao, Zhou. LoFTR: Detector-Free Local Feature Matching with Transformers. CVPR 2021. arXiv · 代码
- Lindenberger, Sarlin, Pollefeys. LightGlue: Local Feature Matching at Light Speed. ICCV 2023. arXiv · 代码
- Edstedt, Athanasiadis, Wadenbäck, Felsberg. DKM: Dense Kernelized Feature Matching for Geometry Estimation. CVPR 2023. arXiv · 代码
- Edstedt, Nordström, et al. RoMa v2: Harder Better Faster Denser Feature Matching. ECCV 2026. arXiv · 代码
- Lindenberger, Sarlin, Miksik, Pollefeys. FlexGlue: Sparse-to-Dense Feature Matching and Visual Disambiguation. arXiv 2610.32976, 2026. arXiv · 代码
- Wang, Leroy, Cabon, Chidlovskii, Revaud. DUSt3R: Geometric 3D Vision Made Easy. CVPR 2024. arXiv · 代码
- Johnson, Douze, Jégou. Billion-scale Similarity Search with GPUs. IEEE Transactions on Big Data, 2019. arXiv · 代码
- van den Oord, Li, Vinyals. Representation Learning with Contrastive Predictive Coding. arXiv 1807.03748, 2018. arXiv
- Arnold, Wynn, Vicente, Garcia-Hernando, Monszpart, Prisacariu, Turmukhambetov, Brachmann. Map-free Visual Relocalization: Metric Pose Relative to a Single Image. ECCV 2022. arXiv
- Sattler, Maddern, Toft, Torii, Hesch, Pollefeys. Benchmarking 6DOF Outdoor Visual Localization in Changing Conditions. CVPR 2018. arXiv
- Taira, Okutomi, Sattler, Cimpoi, Pollefeys, Sivic, Pajdla, Torii. InLoc: Indoor Visual Localization with Dense Matching and View Synthesis. TPAMI 2019. arXiv
- Aanæs, Jensen, Vogiatzis, Tola, Dahl. Large-Scale Data for Multiple-View Stereopsis. IJCV 2016. DOI
- Duisterhof, Zust, Weinzaepfel, Leroy, Cabon, Revaud. MASt3R-SfM: a Fully-Integrated Solution for Unconstrained Structure-from-Motion. arXiv 2409.19152, 2024. arXiv