· 88 min read
论文解读:MVLoMa,把成对局部匹配变成星形多视图匹配
TL;DR MVLoMa 把「中心图 × 多个邻居图」的星形匹配,从 次独立的两两匹配变成一次联合前向[1]。它冻结一个多视图几何基础模型(默认 DA3-Giant),把最后一层已经跨视图融合过的 token 接到 LoMa 的可训练描述子头里,再用「每视图自注意力 + 中心↔邻居双向交叉注意力」的星形匹配器,一次输出所有中心–邻居边的稀疏对应;监督端用可见性过滤的 GT 和 3 px 对极误差负样本,压掉高置信度的几何外点。在 25 视图星形协议下,四个数据集的宏平均 AUC@1°/5°/10° 达到 58.65/85.41/90.99,高于 LoMa-L 的 57.40/84.44/90.06;在 2048 关键点的成本设置下,matcher 对 24 条边一次前向耗时 203 ms,比逐对匹配的 447 ms 快 2.20×,Transformer FLOPs 省 37.0%,代价是匹配器峰值显存从 176 MiB 涨到 979 MiB。
- 论文:MVLoMa: Multi-View Local Feature Matching with Any Geometry Foundation Model,Xinyang Lu、Shengzhe Wei、Sheng Tang、Weiqi Zhang、Juntong Fang、Zesong Li,Kosmo Research / 哈尔滨工业大学 / 清华大学,2026 年 10 月 22 日。
- 代码:无(未开源,项目页标注 “CodeSoon”);项目页 有摘要、图表和数据集说明。
- 前作与背景:LoMa(MVLoMa 直接继承它的描述子头和 dual-softmax 接口)、站内 FlexGlue 解读;不熟悉局部特征匹配的读者可以先看 SuperGlue、LightGlue 和 LoFTR。
一、动机:匹配器的计算单位,和几何证据的单位对不上
图像匹配是三维视觉的接口:SfM 用它建立 track,视觉定位用它把查询图和地图连起来,SLAM 用它跟踪关键帧。过去十年,匹配器的计算单位一直是两张图——SuperGlue、LightGlue、LoMa 在两张图的关键点之间算一个 score matrix[2, 3, 4];LoFTR、RoMa、RoMa v2 在两张图的稠密特征之间回归对应[5, 6, 7]。这个单位很自然,因为对极几何、RANSAC、相对位姿估计都是两视图的工具。
但下游真正拿到的证据往往不是一对图,而是一组互相重叠的图。论文抓住的是最典型的一种结构:星形图(star graph)。一张中心图 和它的 个邻居 ,中心与每个邻居都共视,邻居之间不一定共视。SfM 在局部子问题里会这样组织图像,视觉定位会把查询图和地图邻域这样连起来,关键帧跟踪也会围绕当前帧形成一个局部窗口。
成对匹配器处理星形图的方式是调用 次。这带来三个问题,论文的动机部分说得很清楚:
- 重复计算。中心图的描述子和中心侧注意力在每个 edge 上都会被重新算一遍。
- 边与边之间没有信息交换。匹配器在决定一条边的对应时,看不到其他邻居的支持或反对证据。
- 歧义无法被第三张图解决。重复纹理、部分遮挡、弱基线都可能让某一对图里的匹配模棱两可,而另一个邻居本来可以把它定下来。
第三点最要命:它不是「多花点算力」的问题,而是证据没有被用上。把成对匹配器简单 batch 起来,能摊薄 Python 和 kernel launch 开销,但每条边仍然是独立状态,中心侧计算仍然重复。
已有的多视图匹配器试图把上下文从孤立图像对移到图像组:CoMatcher 做 groupwise 交互[8],MV-RoMa 把稠密多视图对应聚成 track[9]。但它们的输出是稠密对应或 track,不是星形图需要的「每条中心–邻居边一个稀疏 score matrix」;而下游 RANSAC 恰好需要后者。MV-RoMa 在 25 视图下还会显存不足,论文只能用 13 视图分组评测。
另一个被忽视的资源是多视图几何基础模型。DUSt3R、MASt3R 从图像对学习前馈几何表示[10, 11],VGGT、π³、DA3 把输入扩展到视图集合,在视图之间交换 token[12, 13, 14]。这些模型通常被用来解码相机、深度或点图,匹配则交给另一套系统。MVLoMa 的问题是:既然基础模型已经把这个星形图编码过一遍,为什么不用它最后一层的、已经跨视图融合过的 token 来做匹配?这样既不用单独跑一个 DINOv2,也不用为每条边重复编码中心图。
论文的贡献可以概括为三条:
- 把星形图上的稀疏匹配形式化,用一次前向输出全部中心–邻居对应,而不是逐边调用;
- 用冻结的多视图几何基础模型 token 作为几何感知描述子输入,默认 DA3-Giant,并验证 π³、VGGT、VGGT-Ω;
- 采用 RoMa v2 的可见性过滤 GT,并引入对极几何负样本损失,专门压高置信度外点。
下面这个部件把三种信息流放在一起对比。先点「成对独立」,再点「星形联合」,注意中心节点是复制了五份还是只有一份,以及邻居之间有没有边。
二、预备知识:从关键点匹配到星形图
2.1 局部特征匹配在做什么
稀疏局部特征匹配的流程可以拆成四步:
- 检测关键点。在每张图上找可重复的像素位置,例如 SuperPoint、ALIKED、DaD[15]。MVLoMa 沿用 LoMa 的 DaD 关键点,每张图 4096 个。
- 提描述子。在每个关键点周围提一个向量,希望同一个 3D 点在不同视角下的向量接近。传统方法是 SIFT,学习方法是 CNN / ViT 特征。
- 算相似度矩阵。对中心图的 个关键点和邻居图的 个关键点,两两算内积,得到 的 score matrix 。
- 分配 + 几何验证。用 dual-softmax、互最近邻等规则把矩阵变成离散匹配,再交给 RANSAC 估计相对位姿。
对一对图来说,dual-softmax 是最常见的分配方式:先对每一行做 softmax,再对每一列做 softmax,两个概率相乘得到匹配置信度。如果一行一列互相是最大值,且置信度超过阈值,就接受这对匹配。它的好处是可微、训练稳定;缺点是归一化只在当前图像对内进行,一个 keypoint 在另一张图里的竞争者是同一张图的所有 keypoint,而不是其他邻居。
LoMa 的贡献之一是把「冻结的 DINOv2 特征 + 可训练的 VGG / Conv Refiner」这套描述子做得足够强,再用 dual-softmax 匹配。MVLoMa 直接继承了 LoMa 的描述子头、DaD 关键点和 dual-softmax 接口,改的是描述子的来源和注意力的范围。
用 RANSAC 做几何验证时,匹配器输出的是每条边的一组对应点;RANSAC 在每条边上独立采样、估计基础矩阵或本质矩阵,最后用内点数或重投影误差评估。评价指标 AUC@ 是相对位姿误差累积曲线下的面积:误差小于 的图像对越多,AUC 越高。 是很严的阈值,能暴露那些在 / 下被平均掉的精确匹配错误。
2.2 对极几何:一条线判断匹配对不对
两视图之间有一个与场景结构无关的约束[16]。设中心图相机矩阵为 ,邻居图相机矩阵为 ,则基础矩阵
其中 是平移向量的反对称矩阵。对中心图上的齐次坐标 ,它在邻居图上的对极线是 ;一个候选匹配 到这条线的距离是
如果两视图的 relative pose 已知,那么正确匹配的 应该接近 0;反之,一个置信度很高但 很大的匹配,几乎一定是几何外点。MVLoMa 的负样本损失就是围绕这个量做的:不是等 RANSAC 去丢外点,而是在训练时直接把这类高置信度错误压下去。
注意这里的 来自 ground-truth 外参,只在训练时可用;推理时当然不知道 ,所以负样本损失是一个训练信号,不是推理过滤器。推理仍然靠 dual-softmax + 互最大 + RANSAC。
2.3 星形图与多视图几何基础模型
星形图 有一个中心 和 个邻居。它的边只连接中心和邻居:,邻居之间没有边。这个结构的好处是中心是共享的:同一个中心 keypoint 可以在多条边上出现,天然形成候选 track;坏处是邻居之间的信息只能通过中心中转。
多视图几何基础模型的共同套路是:用 ViT 把每张图 token 化,在视图内做 self-attention,在视图间做 cross-attention,最后输出每张图对齐的 token 或点图。DUSt3R / MASt3R 主要处理图像对;VGGT、π³、DA3 处理任意数量的视图。它们通常还会接一个几何头,解码深度、相机位姿或 pointmap。
MVLoMa 只取最后一层、经过多视图融合的 per-image token,不碰几何头。这样做的理由有三点:
- token 已经在整个星形图上交换过信息,天然带跨视图上下文;
- 冻结基础模型,避免为了匹配任务 fine-tune 一个很大的几何编码器,破坏它的通用先验;
- 同一个编码器前向既可以给匹配用,也可以给原本的几何头用,不额外引入一个冻结的 DINOv2 描述子骨干。
「Any Geometry Foundation Model」里的 any 有一个前提:编码器必须在多视图融合后暴露空间对齐的 per-image token,并且 token 的网格能和图像像素对应上。DA3-Giant 满足这个条件,π³、VGGT、VGGT-Ω 也被拿来做对照;不是任意一个几何模型都能直接 plug-and-play。
三、核心方法
3.1 问题定义与总体架构
给定星形图 ,目标是同时预测 个对应集合
每个 只包含中心–邻居的稀疏匹配。成对匹配器会对每个 独立调用一次,每次重新编码中心图、重新算中心侧注意力,并且在看到其他邻居之前就做完决定。MVLoMa 的数据流反过来:
- 冻结的多视图几何基础模型先编码整个星形图,得到每个视图的几何感知 token;
- 可训练的 VGG + Conv Refiner + MLP 把这些 token 和图像特征融合成描述子场;
- 在 4096 个 DaD 关键点上采样描述子,送入星形匹配器;
- 匹配器先做每视图自注意力,再做中心→邻居和邻居→中心的交叉注意力;
- 对每条边独立做 dual-softmax,输出该边的 score matrix 和稀疏匹配。
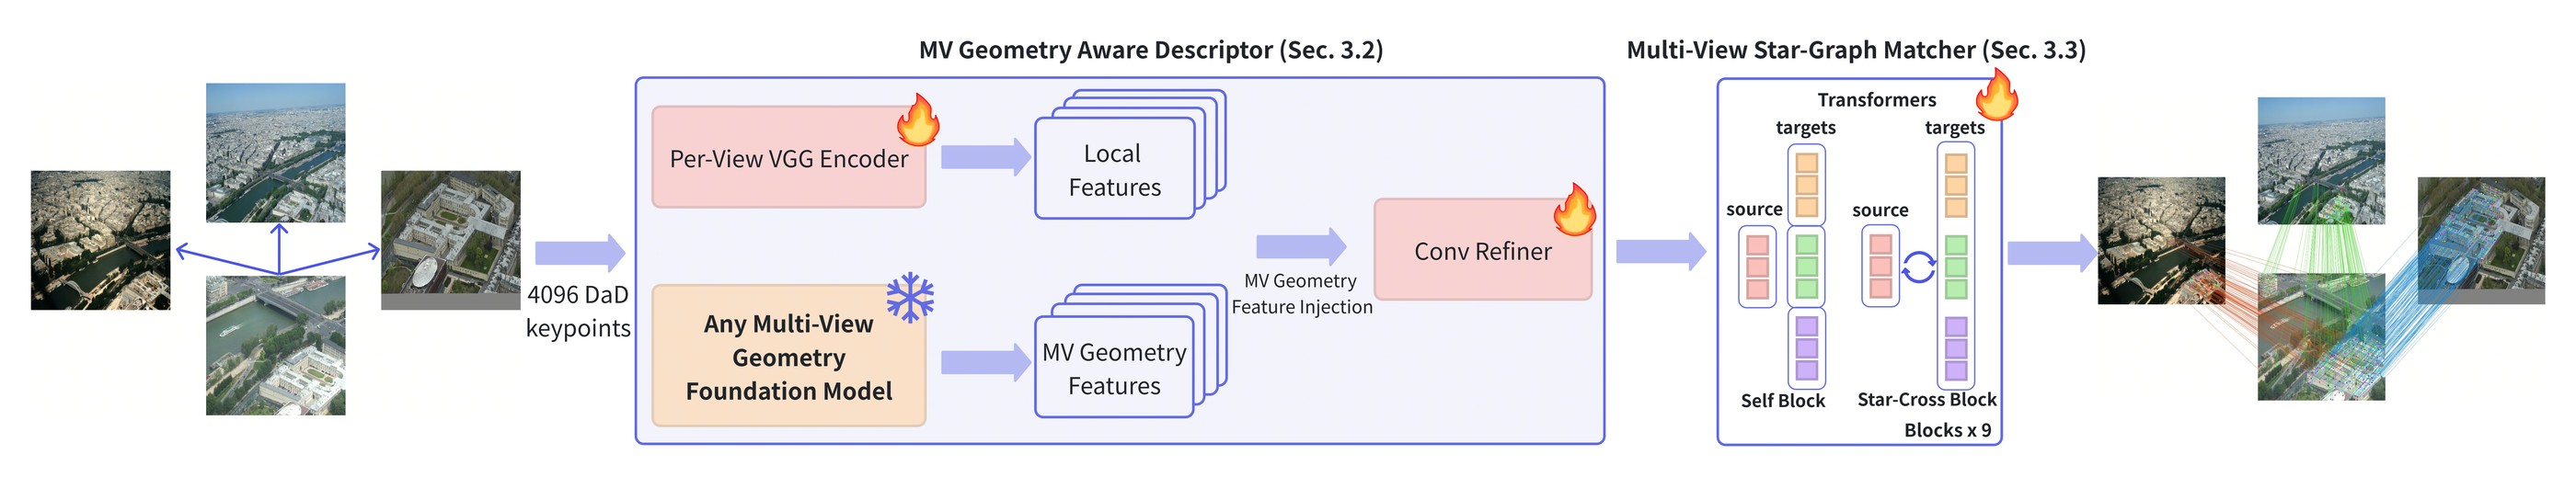
这张图里最值得看的是两条数据流的汇合点:基础模型的 token 不是用来解码点图,而是直接进入描述子头;匹配器也不是在每对图上各跑一遍,而是在整个星形图上跑一遍,最后才把每条边的 score matrix 拆出来。联合推理发生在描述子和上下文层,输出仍然是标准的两两 score matrix,所以下游 RANSAC 不需要改。
3.2 几何感知描述子:把基础模型的跨视图 token 接进 LoMa
设第 张图的最后一层基础模型特征图为 。它的 token 在空间上与图像网格对齐,而且已经包含其他星形视图的信息。MVLoMa 保留 LoMa 的可训练结构,只把原来冻结的 DINOv2-L 特征[17]换成 :
其中 包含 Conv Refiner 和 MLP 投影,负责把不同编码器的特征维度映射到统一的描述子维度 。然后按 LoMa 的方式在 DaD 关键点处采样描述子,得到每条边的 keypoint descriptor。
这个设计的关键在于多视图上下文在 assignment 之前就进入了描述子场。描述子不是「每张图独立提完再匹配」,而是「基础模型已经在整组图上交换过信息,再采样成稀疏描述子」。后续匹配器只需要在选中的关键点上做任务特定的通信,不用再从零建立跨视图上下文。
和 LoMa 的差别可以总结成一张表:
| LoMa | MVLoMa | |
|---|---|---|
| 冻结的语义特征 | DINOv2-L | 多视图几何基础模型的最后一层 token(默认 DA3-Giant) |
| 跨视图上下文 | 无,匹配阶段才交互 | 描述子阶段已经融合 |
| 中心描述子 | 每条边重新提 | 整个星形图提一次,所有边共享 |
| 可训练部分 | VGG + Conv Refiner + matcher | 同样的描述子头 + matcher,基础模型冻结 |
| 输出 | 每条边一个 score matrix | 每条边一个 score matrix(接口不变) |
论文的 Table 3 做了一个受控消融:训练数据、分辨率、星形匹配器、损失和优化配置全部固定,只换冻结的描述子输入。四列是 HyperSim 和 AerialMD 各取 与 两个重叠阈值。DA3-G 四列分别是 69.27 / 61.14 / 77.97 / 48.16 AUC@1°,DINOv2-G 是 68.11 / 49.70 / 77.56 / 47.51,DINOv2-L 是 67.72 / 48.29 / 77.33 / 47.08。差距最大的是 HyperSim 的低重叠子集():DA3-G 比 DINOv2-G 高 11.44 分,比 DINOv2-L 高 12.85 分;到了 AerialMD,两者只差 0.4–1.1 分。DINOv2-G 和 DINOv2-L 几乎一样,说明不是把 2D 骨干放大就行,跨视图几何信息才是关键。
为什么不让基础模型也参与训练?论文的理由是成本和先验:fine-tune 一个大的几何编码器很贵,而且可能破坏它的通用几何表示。冻结之后,可训练部分只有描述子头和匹配器,优化目标和 LoMa 接近,训练成本可控。代价是描述子的几何质量被冻结编码器锁死——这是后面局限里要回来看的一点。
3.3 星形图注意力:中心广播,邻居回写
描述子已经有跨视图上下文,但匹配仍然需要在选中的关键点上做任务特定的通信。最直接的做法是每条边跑一遍 LoMa,但这样中心状态仍然是独立的;另一个极端是全连接注意力,让所有邻居两两交互。论文选择了中间路线:用星形拓扑本身作为注意力模式。
匹配器有 层。每层先对每个视图独立做 self-attention,并加旋转位置编码(RoPE)[18]:
然后把所有邻居的描述子拼起来,记作 。中心先查询所有邻居:
接着所有邻居查询更新后的中心:
这三条公式就是整个星形注意力的核心。它有两个刻意的省略:
- 邻居之间不互相 attend。输出只连接中心和邻居,邻居–邻居的注意力不会直接产生任何一条输出边;在全连接里为它付钱不划算。
- 没有 view embedding,交叉注意力也没有位置编码。邻居集合是无序的,给每个邻居一个可学习的 view id 会把「第几个邻居」这种任意顺序写进模型;位置信息已经在每视图 self-attention 的 RoPE 里,交叉注意力只按内容匹配。
这个数据流的效果是:中心先把所有邻居的证据聚合一遍,邻居再拿更新后的中心做一次条件化。一个在单对图里模棱两可的中心 keypoint,可以被第三个邻居支持或否定;而每条边仍然保留自己的输出。和「把所有邻居拼成一个大 attention」相比,它省掉了邻居–邻居的二次开销;和「逐对跑 LoMa」相比,它让中心状态在所有边之间共享。
对每个邻居 ,用更新后的描述子算 score matrix ,再做只在当前图像对内归一化的 dual-softmax:
互最大且 的条目组成 。这里有两个细节值得强调:
- 归一化仍然限制在单条边内,所以邻居之间不会为了同一个中心 keypoint 互相竞争;中心描述子是共享的,同一个中心 keypoint 可以一致地连到多个邻居,候选 star track 是共享描述子的副产品,不需要后处理 track snapping。
- 每条边仍然有自己的 和 ,所以 RANSAC 仍然可以逐边估计相对位姿;MVLoMa 没有把输出变成一个全局 track 集合。
下面这个部件把 5×5 的玩具 score matrix 拆开给你看:拖动温度 和阈值 ,观察行 softmax、列 softmax、两者乘积,以及「互最大」和「过阈值」两个条件如何共同决定接受哪些匹配。默认矩阵里有一个近似歧义:第 3 个中心点在邻居图的第 3、4 个 keypoint 上分数接近,但第 4 个 keypoint 的列最大值在另一个中心点,所以它会被互最大条件排除。
3.4 监督:可见性过滤的 GT 与对极几何负样本
有了共享中心和跨边上下文,还需要保证监督信号本身是几何正确的。论文从两个方面下手。
正样本:可见性过滤。 用 ground-truth 深度和位姿把中心图的像素重投影到邻居图,可以得到稠密的伪对应。但朴素 warp 会把被遮挡、出界、深度无效的像素也当成有效目标。MVLoMa 沿用 RoMa v2 的做法,只保留满足以下条件的正样本:
- 源像素深度有效;
- 重投影落在目标图像内;
- 通过预设的遮挡检查;
- 通过目标深度一致性检查。
这几条过滤掉的是标签噪声。如果没有它们,描述子头和 assignment 头会去拟合一些根本不存在的对应,尤其是遮挡边界和物体背面。
负样本:对极几何违反。 dual-softmax 的 matching loss 通过行、列竞争隐式压低非匹配项,matchability loss 判断一个 keypoint 是否有对应;但两者都没有显式惩罚「高置信度、互最大、但几何上错误」的匹配。这类外点最难缠:它们能通过互最大筛选,RANSAC 会把它们当外点,但在匹配器看来置信度很高。
论文的做法是:在最后一层,取所有互最大且 的匹配 ,用 ground-truth 外参算基础矩阵 ,再算每个匹配的对极误差。误差超过 px 的匹配组成负样本集合
对每个负样本,在每一层都加一个二分类式的惩罚:
负样本集合为空时损失为 0。最终 matcher 的损失是 LoMa 的 dual-softmax loss、matchability loss 和这个负样本损失的加权和:
其中 。负样本在最后一层挖掘(只惩罚模型真正会输出的错误),但在每一层监督(把纠正信号传回整个匹配器)。
Table 2 的消融很直接:HyperSim 上完整模型 52.84/78.42/84.34,去掉 GT 过滤是 51.93/77.75/83.77,去掉负样本损失是 51.04/76.96/83.19。负样本损失在严格阈值上的影响更大(@1° 掉 1.80,而 GT 过滤掉 0.91),这和「高置信度外点最伤 RANSAC」的直觉一致。Mip-NeRF 360 上趋势相同但幅度小一些(73.85 → 73.69 → 72.72 @1°)。
下面这个部件把两个监督信号放在一张示意图里。拖动 ,或者关掉「可见性过滤」/「对极负损失」,看哪些正样本会被过滤、哪些高置信度错误匹配会被当成负样本。
3.5 复杂度:为什么星形比逐对便宜
论文把 matcher 的计算量拆成两项。设星形图有 个视图,每个视图 个关键点,隐藏维度 ,匹配器 层。单对 LoMa 每层大约
FLOPs。逐对匹配要做 次,所以
星形匹配只算一次中心侧 self-attention、投影和 FFN,邻居侧仍然各自算,所以
两者的交叉注意力项其实相同,因为 :中心查询所有邻居,和「每个邻居各自查询中心」的总元素数一样。省下来的是重复的中心侧 self-attention、线性投影和 FFN。
取 、、,理论比值是
时理论加速 1.59×;实测 matcher-only 延迟从 446.96 ms 降到 203.09 ms,是 2.20×。实测比理论高,是因为 24 次逐对调用还要付 Python / module 调用和 kernel launch 的固定开销,而星形实现用更大的连续矩阵,GPU 利用率更好。反过来, 时两者输出完全相同,实测 0.99×,正好是一个 sanity check。
代价是显存:25 视图下 matcher 峰值显存从 176 MiB 涨到 979 MiB。星形把中心与所有邻居的 token 放在一次前向里,注意力矩阵和中间激活都更大;这是「用显存换重复计算」的典型交易。
四、实验
4.1 协议与训练设置
实验的核心协议是 25 视图星形图:每组 25 帧,第 0 帧是中心,第 1–24 帧是邻居,评测全部 24 条中心–邻居边。这个协议刻意模拟局部多视图子问题,而不是随机抽不相关的图像对。对于只能接受 张图的多视图方法,把 24 个邻居分成大小为 的组,保证覆盖的边和两视图基线完全一样,避免「多视图方法抽到了更容易的 pair」这种不公平。MV-RoMa 在 25 视图下显存不足,所以用 13 视图分组,按同样的覆盖规则评测。
四个主基准覆盖不同场景:
- HyperSim:合成室内场景,几何和外观都很有挑战[19];
- ScanNet++:真实室内扫描,带网格真值[20];
- Mip-NeRF 360:无界室外场景,视角变化大[21];
- Tanks and Temples:大规模室外重建基准[22]。
编码器和视图数消融额外用 MegaDepth-X 和 TerraSky3D[23];描述子骨干消融用 AerialMD(AerialMegaDepth)的评测对[24]。每条边用 PoseLib 的 RANSAC 估计相对位姿,阈值 2.5 px[25];指标是 AUC@1°/5°/10°,位姿误差同时包含旋转和平移误差。每个 baseline 用它原论文规定的输入分辨率,MVLoMa 报 504 和 784 两个 DA3-G 分辨率。
训练方面,默认配置是:冻结 DA3-G 编码器,用公开的 LoMa-L checkpoint 初始化,4096 个 DaD 关键点,9 层匹配器,分辨率 784;用一张 A800、batch size 1、AdamW,描述子学习率 、匹配器学习率 ,EMA decay 0.999。附录写的是 200k 次迭代:前 100k 固定四视图,后 100k 从 2–8 个视图均匀采样;正文的 GT/loss 消融则是固定四视图、100k 次迭代。训练混合包括 MegaDepth、MegaDepth (Re-MVS)、MegaDepth-X、HyperSim、ScanNet++、BlendedMVS、AerialMD、TerraSky3D 和 TartanAir[26, 19, 20, 23, 24],各数据集的采样权重和 overlap 采样范围在附录 Table 7。
这里有一个读论文时要留意的点:HyperSim、ScanNet++、TerraSky3D 既出现在训练混合里,又出现在评测里。论文正文没有给出场景级划分;附录 Table 7 只对 TerraSky3D 注明使用开源 JSON split,HyperSim 和 ScanNet++ 只给了采样权重与 overlap 范围。如果底层用的是各自的标准场景 split,这没问题,但读者不能只凭主表数字判断跨数据集泛化。至少 HyperSim 和 ScanNet++ 上的提升,应该理解为「同分布/同数据集协议下的提升」,而不是完全未见过的场景。
4.2 主结果:稀疏多视图 vs 稠密两视图
Table 1 是全文最重要的一张表。每个单元格是 AUC@1°/5°/10°,最后一列是四个数据集的宏平均。
| 方法 | HyperSim | ScanNet++ | Mip-NeRF 360 | T&T | 平均 |
|---|---|---|---|---|---|
| LightGlue | 20.20/47.34/55.72 | 22.84/61.83/74.49 | 51.28/83.46/90.02 | 52.42/84.69/91.08 | 36.69/69.33/77.83 |
| LoMa-L | 51.99/77.00/82.86 | 37.68/75.57/85.14 | 71.69/93.25/96.50 | 68.22/91.96/95.74 | 57.40/84.44/90.06 |
| RoMa | 45.06/64.82/69.78 | 36.81/73.88/83.70 | 75.42/93.27/95.88 | 66.56/90.99/95.01 | 55.96/80.74/86.09 |
| RoMa v2 | 52.93/80.65/86.92 | 33.02/73.33/84.58 | 74.81/94.16/97.00 | 67.06/91.32/95.37 | 56.95/84.87/90.97 |
| MV-RoMa (13) | 37.00/58.51/64.51 | 35.80/71.57/81.67 | 74.45/92.93/95.61 | 66.04/90.56/94.75 | 53.32/78.39/84.14 |
| MVLoMa (504) | 53.35/78.99/84.76 | 38.03/74.72/84.67 | 73.90/94.04/96.97 | 68.08/91.91/95.74 | 58.34/84.91/90.53 |
| MVLoMa (784) | 53.90/80.02/85.99 | 38.44/75.68/85.33 | 74.29/94.08/96.97 | 67.96/91.84/95.68 | 58.65/85.41/90.99 |
几个结论:
- 宏平均三档全胜。784 模型在 1°/5°/10° 都是第一,分别比 LoMa-L 高 1.25/0.97/0.93 分,比 RoMa v2 高 1.70/0.54/0.02 分。10° 上对 RoMa v2 基本是打平(90.99 vs 90.97),优势主要在严格阈值。
- 不是所有数据集都赢。Mip-NeRF 360 的 AUC@1° 仍然是稠密两视图 RoMa 最强(75.42),RoMa v2 也有 74.81,MVLoMa 是 74.29;Tanks and Temples 的 AUC@1° 仍然是 LoMa-L 最强(68.22 vs 67.96)。MVLoMa 的卖点是宏平均和多视图覆盖,不是每个单点都刷新。
- 分辨率 504 和 784 很接近。差距主要在 HyperSim 的严格阈值(53.90 vs 53.35),其他基准差距在 0.1–0.6 分之间。这说明星形匹配的收益不是靠「更高分辨率硬堆」出来的,至少在 504 上已经成立。
- MV-RoMa 的 13 视图成绩不能直接和 25 视图比。它少看了一半邻居,且输出是稠密 track 而不是稀疏边;这个对比更多是「同协议下的可用性」而不是严格同预算。论文也很克制地没有把它当作主要对手。
一个容易被忽略的细节:LightGlue 在 HyperSim / ScanNet++ 上 AUC@1° 只有 20.20 / 22.84,远低于 LoMa 和 RoMa。这不是说 LightGlue 很差,而是这个协议用了 4096 个 DaD 关键点、25 视图星形图,且评测的是极严格阈值;LightGlue 原生的关键点和参数并不是为这个设置调的。跨方法比较时,输入分辨率和关键点预算的公平性比单看一个数字更重要。
4.3 消融:几何特征、GT 过滤、负样本
GT 过滤与负样本损失。 Table 2 用 DA3-G、四视图训练、784 测试,只改监督:
| 变体 | HyperSim @1/5/10 | Mip-NeRF 360 @1/5/10 |
|---|---|---|
| 完整 | 52.84/78.42/84.34 | 73.85/93.96/96.92 |
| 去掉 GT 过滤 | 51.93/77.75/83.77 | 73.69/93.85/96.83 |
| 去掉负样本损失 | 51.04/76.96/83.19 | 72.72/93.42/96.55 |
两个组件都有用,但作用点不同:GT 过滤去掉的是错误的正样本,负样本损失压的是高置信度的错误匹配。在 HyperSim 的 @1° 上,负样本损失贡献 1.80 分,GT 过滤贡献 0.91 分;在更粗的阈值上差距缩小到 0.6–0.8 分。Mip-NeRF 360 上负样本损失仍然是更大的因素(1.13 vs 0.16 @1°)。这和「严格阈值最怕几何外点」的判断一致。
描述子骨干。 Table 3 固定其他所有变量,只换冻结的描述子输入:
| 骨干 | HyperSim o>0.35 | HyperSim o>0.05 | AerialMD o>0.35 | AerialMD o>0.05 |
|---|---|---|---|---|
| DA3-G | 69.27 | 61.14 | 77.97 | 48.16 |
| DINOv2-G | 68.11 | 49.70 | 77.56 | 47.51 |
| DINOv2-L | 67.72 | 48.29 | 77.33 | 47.08 |
HyperSim 低重叠子集(o>0.05)的差距最大:DA3-G 比 DINOv2-G 高 11.44 分,比 DINOv2-L 高 12.85 分。DINOv2-G 和 DINOv2-L 几乎一样,说明「把 2D 骨干从 L 换成 G」本身不解决问题;跨视图几何融合才是增益来源。这个消融是全文最有说服力的一个,因为它把「多视图匹配器」和「几何特征」两个因素分开了。
基础模型编码器。 Table 4 在同样的 2–8 视图训练、25 视图测试、784 分辨率下比较四个冻结编码器(只列 AUC@1°,完整三档见论文):
| 编码器 | HyperSim | MegaDepth-X | TerraSky3D |
|---|---|---|---|
| DA3-G | 53.90 | 18.88 | 55.53 |
| π³ | 51.50 | 18.37 | 53.77 |
| VGGT | 52.28 | 18.05 | 53.21 |
| VGGT-Ω | 52.07 | 18.43 | 55.21 |
DA3-G 在三个数据集上都最好;VGGT-Ω 在 MegaDepth-X 和 TerraSky3D 上很接近(18.43 vs 18.88,55.21 vs 55.53),但在 HyperSim 上低 1.83 分。论文的结论是「编码器的质量仍然重要」,但没有证明 DA3-G 的某个具体属性单独导致了优势。这个保留是对的:四个编码器的训练数据、分辨率、token 语义都不同,不能简单归因。
4.4 视图数:不是越多越好
Table 5 固定评测边,只改变一次联合处理的邻居数(2/4/7/13/25 视图),模型用 2–8 视图训练、25 视图测试。下面是各数据集的 AUC@1° 和宏平均:
| 视图数 | HyperSim | Mip-NeRF 360 | T&T | TerraSky3D | 平均 @1/5/10 |
|---|---|---|---|---|---|
| 2 | 52.51 | 73.96 | 67.63 | 54.76 | 62.21/86.63/91.34 |
| 4 | 53.79 | 74.31 | 67.85 | 54.58 | 62.63/87.12/91.92 |
| 7 | 53.90 | 74.32 | 67.89 | 54.97 | 62.77/87.11/91.89 |
| 13 | 54.47 | 74.20 | 67.92 | 55.39 | 63.00/87.36/92.09 |
| 25 | 53.90 | 74.29 | 67.96 | 55.53 | 62.92/87.45/92.17 |
三个观察:
- 两视图明显最差。宏平均 62.21/86.63/91.34,比最好的多视图结果低约 0.8 分。两视图时星形退化成一个中心加一个邻居,没有跨邻居证据;评测边数不变,所以这个下降干净地隔离了「联合多视图交互」的收益。
- 13 视图的 @1° 最高,25 视图的 @5°/10° 最高。增益不是单调的:HyperSim 的 @1° 从 13 到 25 反而从 54.47 掉到 53.90;TerraSky3D 则一路涨到 25。更多的邻居既带来支持证据,也可能带来 distractors 和更难的 baseline。
- 训练 2–8 视图,测试 25 视图,仍然能外推。这是论文比较大胆的设置;结果说明星形匹配器没有过拟合到固定视图数,但也说明「加视图」不是免费的万灵药。
下面这个部件把宏平均曲线画出来。点不同的视图数,看三档 AUC 的位置;默认停在 13 视图,因为它是 @1° 的峰值,而 25 视图是 @5°/10° 的峰值。
4.5 成本:2.20× 是 matcher-only 的数字
Table 6 用 2048 个关键点、9 层 LoMa-L、A800、batch 1 测 matcher-only 的 FLOPs 和延迟。25 视图时:
- 逐对:24 条边,16.235 TFLOPs,446.96 ms;
- 星形:1 次前向,10.234 TFLOPs,203.09 ms;
- FLOPs 降 37.0%,实测加速 2.20×;
- 匹配器峰值显存:176 MiB → 979 MiB。
13 视图时实测加速 2.25×,比 25 视图还高一点;7 视图 1.88×,4 视图 1.56×,2 视图 0.99×。2 视图的 0.99× 很重要:它说明星形实现没有在退化情况下偷偷改变输出,逐对和星形的结果一致,只是多了一点调度开销。
理论加速在 25 视图是 1.59×,实测 2.20×,差额来自逐对调用的固定开销。这个数字容易被误读成「整个系统快 2.20×」——不是。它只包含 matcher,不含冻结的 DA3-G 编码器前向、描述子提取、RANSAC 和 I/O。实际系统里,25 个视图的 DA3-G 前向很可能才是大头;论文没有报端到端延迟,这是评估上的一個空白。
另外,成本表用的是 2048 个关键点,主实验用的是 4096 个。注意力矩阵随 增长,4096 下星形匹配的显存和延迟都会更高;论文没有单独报 4096 的峰值显存。所以 979 MiB 应该理解为「这个成本分析设置下的下界」,不是主实验的显存占用。
下面这个部件把 Table 6 的 FLOPs 和延迟画成两条曲线。拖到 25 视图,看星形曲线和逐对曲线分开多少;再拖回 2 视图,确认两者重合。
4.6 定性结果
下面从论文附录里选了三组星形匹配可视化;附录本身按数据集分组,BlendedMVS、HyperSim、MegaDepth、MegaDepth-X、TerraSky3D 都有例子,这里各取一组室外街景、航拍和室内场景。每个例子有一个中心图和五个邻居,连线按边着色;中心图在下方,邻居围绕在上方。重点看三件事:中心 keypoint 是否在多条边上重复出现(共享描述子形成的候选 track)、重复纹理处是否被其他邻居纠正、以及弱纹理区域是否仍然失败。
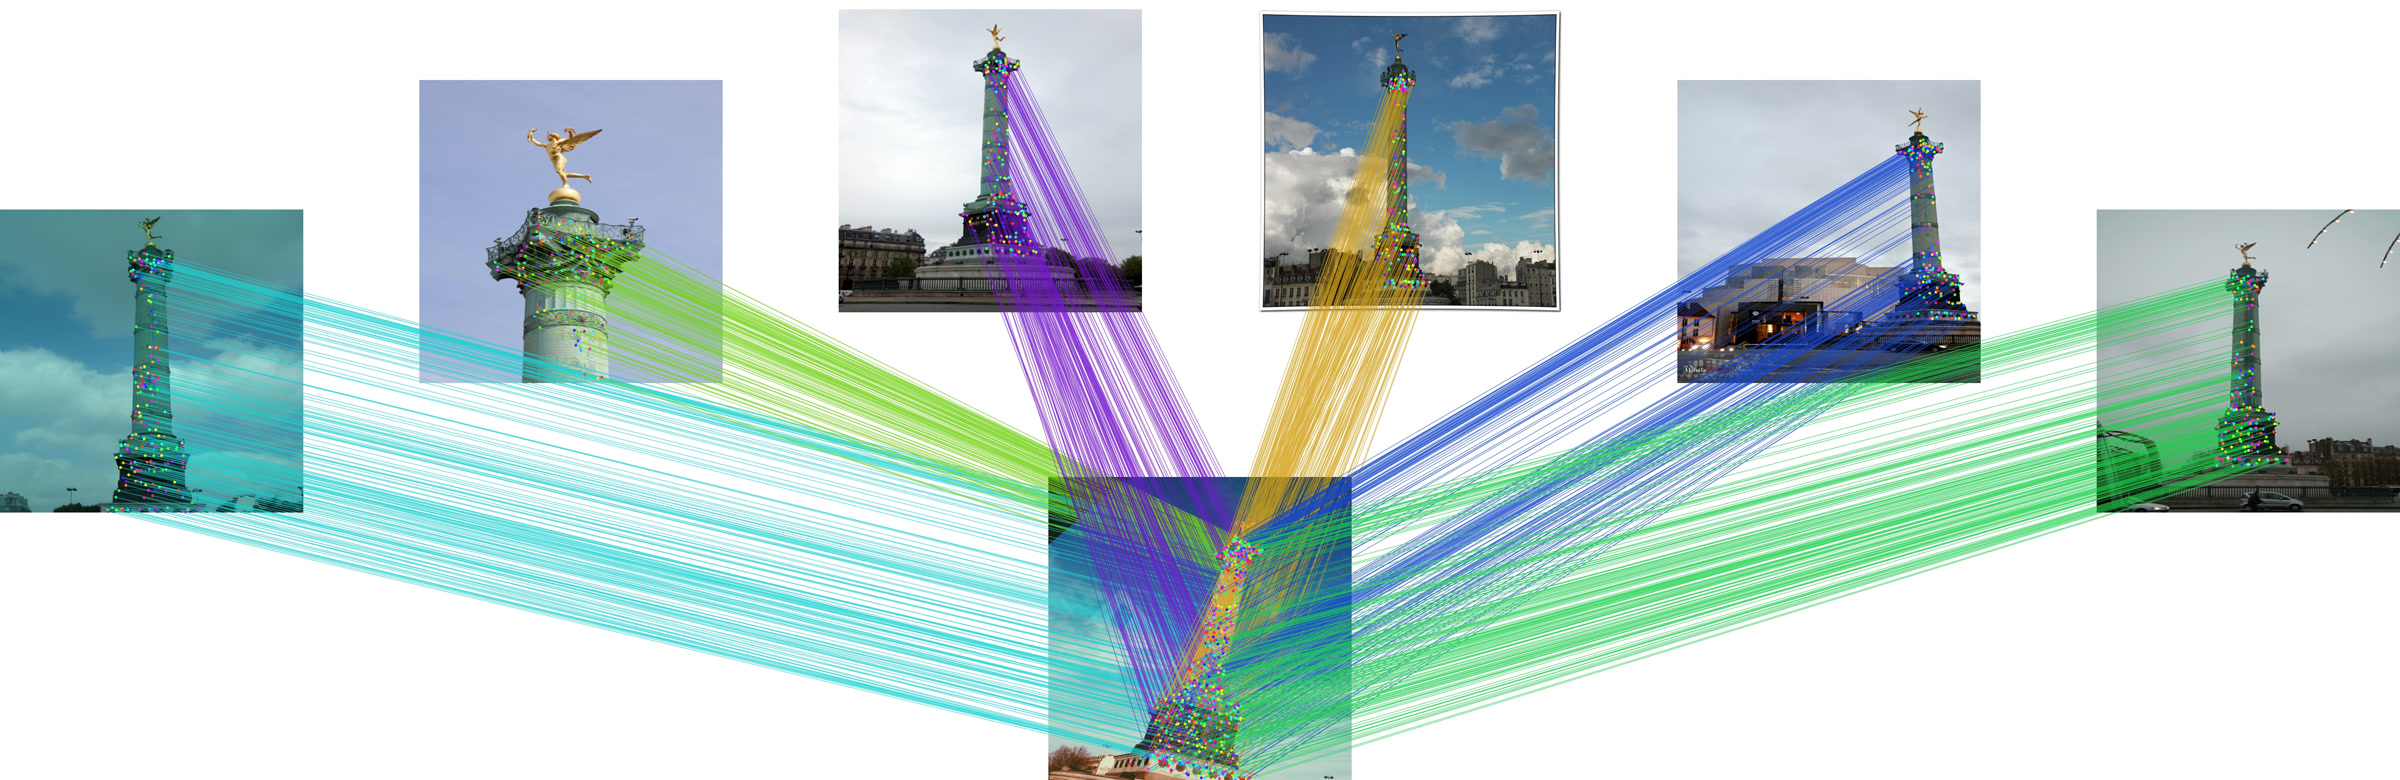
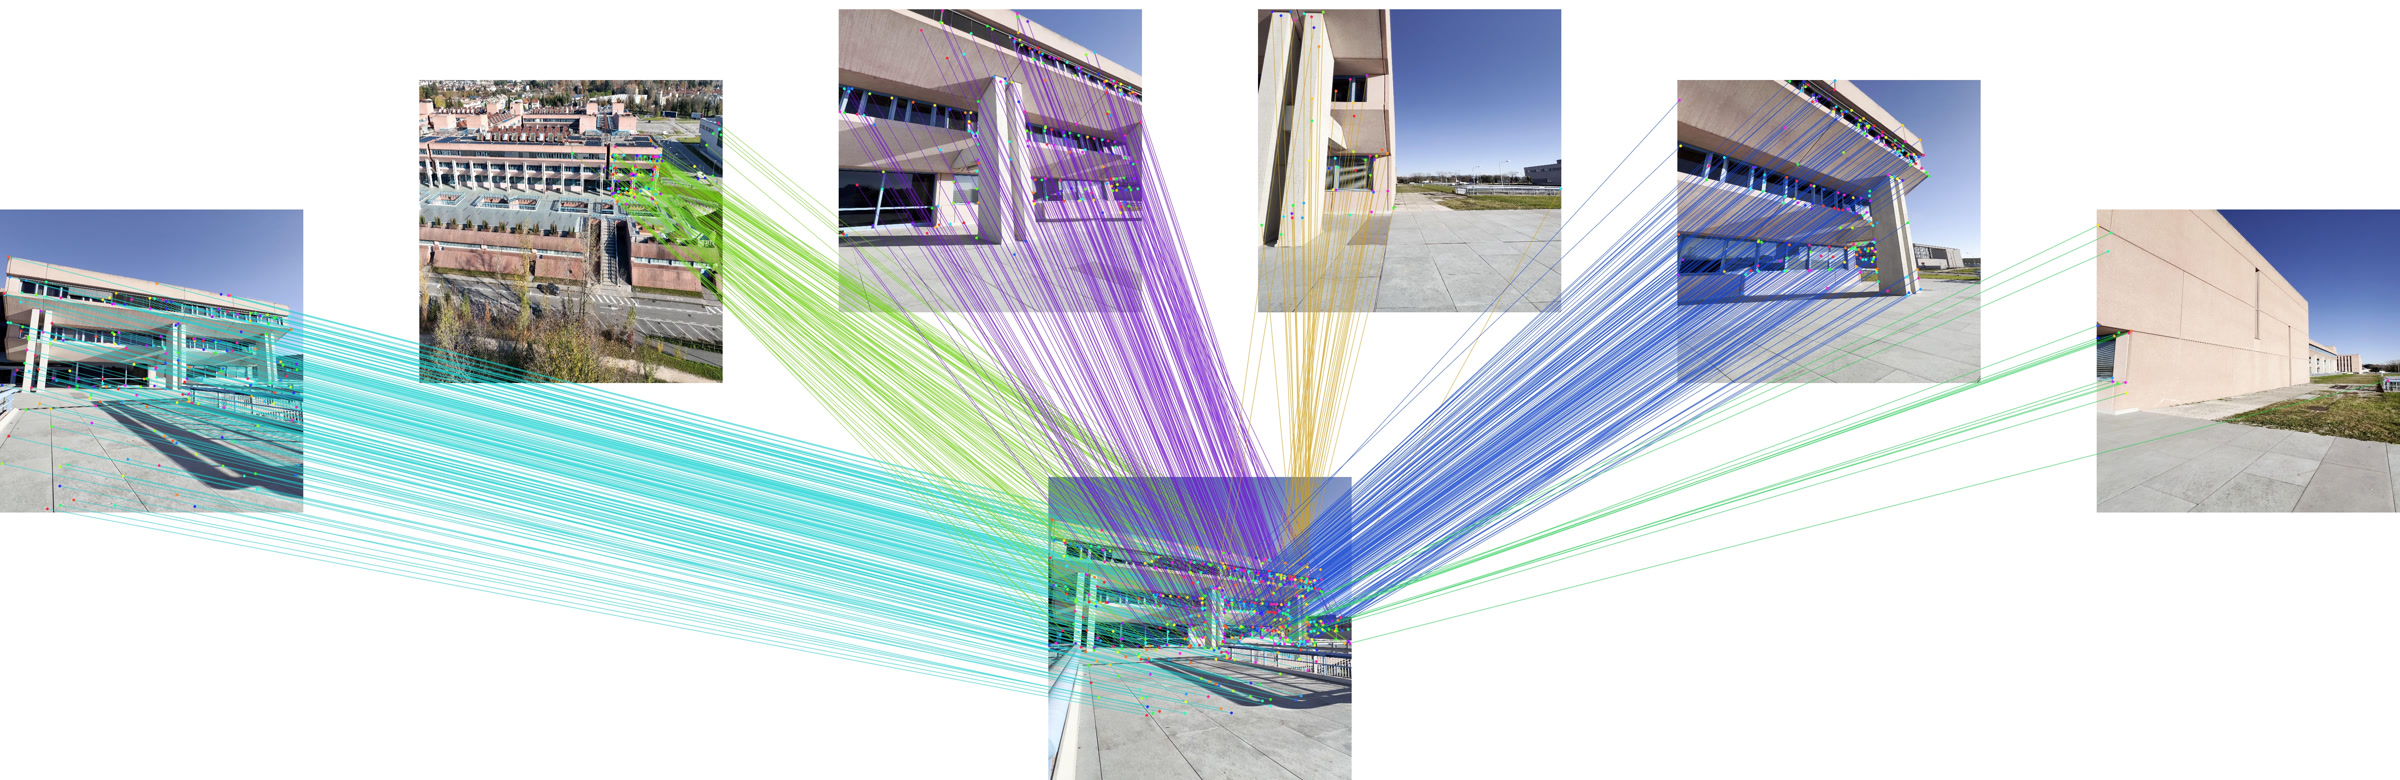
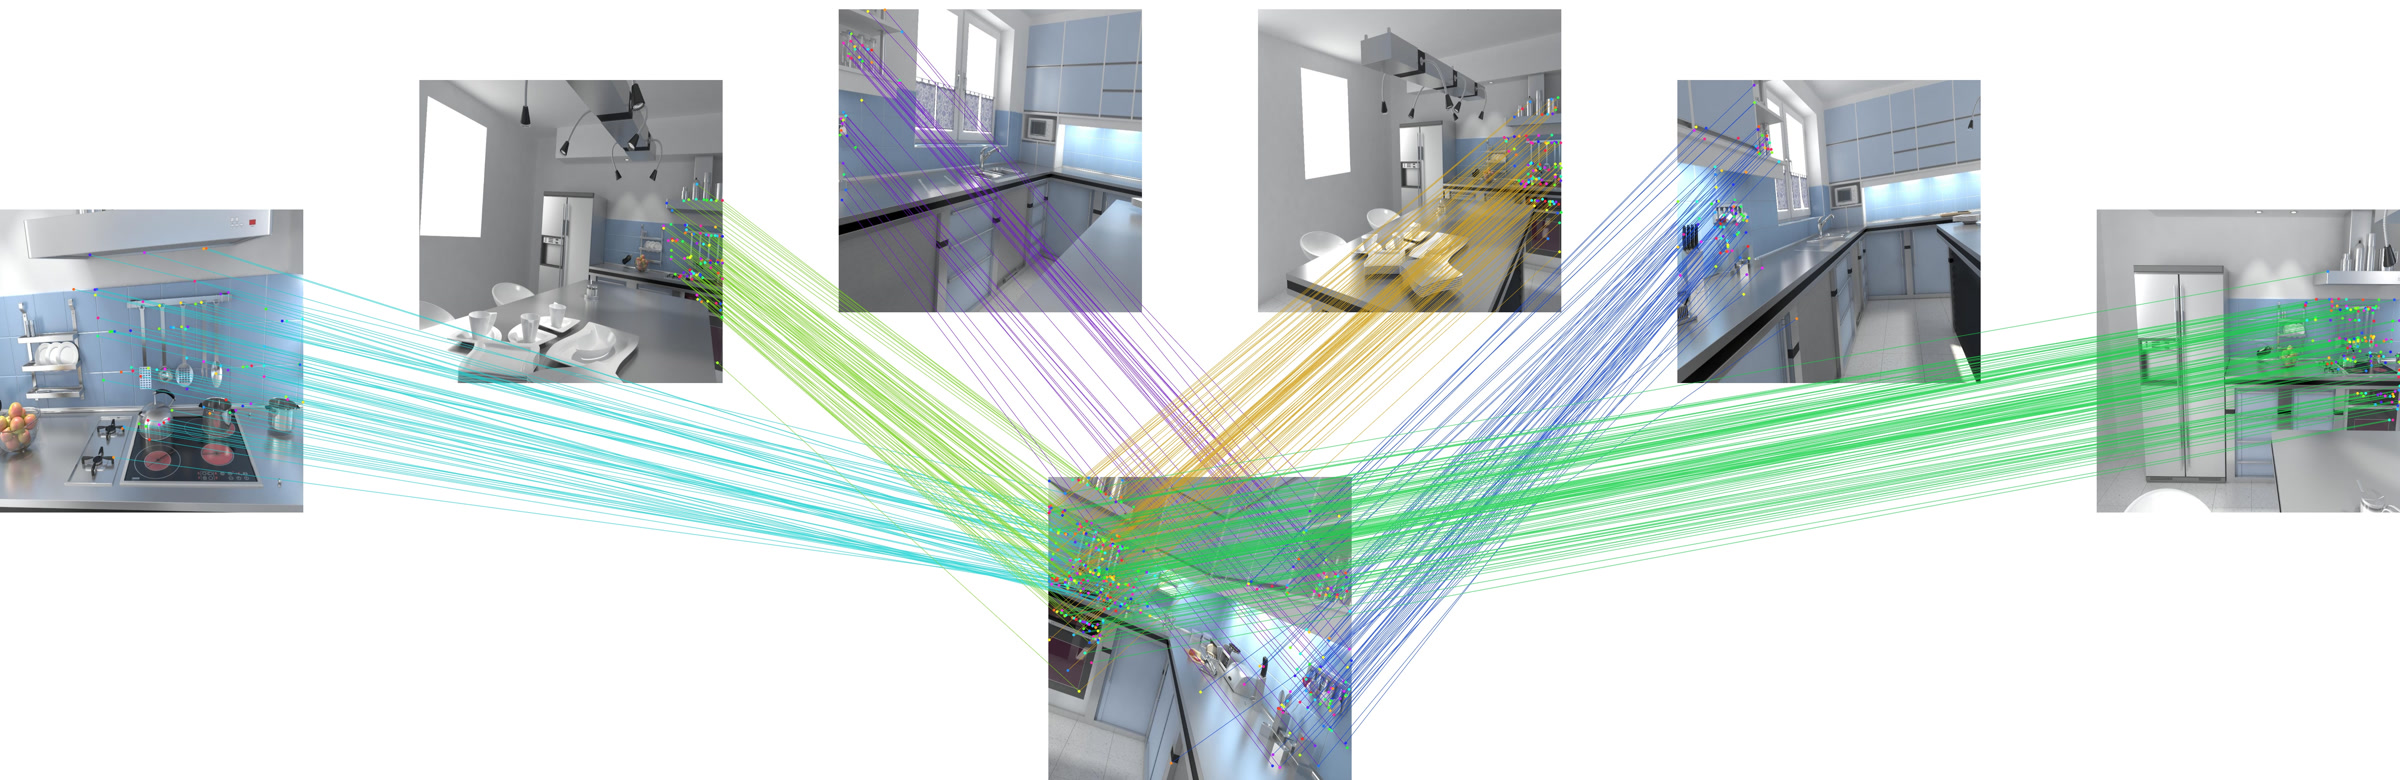
这三张图是开发阶段的可视化,不是精挑细选的失败分析;论文附录明确说它们来自 development experiments。它们能说明匹配在复杂场景里确实在工作,但不能替代定量评测。尤其是第二张航拍图,颜色密集的区域看起来匹配很多,读者无法从图上判断有多少是几何正确的——真正的结论还是得回到 Table 1 和 Table 5。
五、局限与评价
5.1 论文自己承认的
论文在 Section 5 里列得比较坦诚:
- 依赖冻结基础模型的几何质量。纹理弱或不确定的区域仍然会给出稀疏、模糊的匹配;基础模型错了,匹配头很难救回来。
- 邻居之间不直接交换信息。星形拓扑只让中心中转,邻居–邻居的约束(例如三视图循环一致性)没有被显式建模。
- 显存随关键点和视图数增长。25 视图、2048 关键点已经要 979 MiB;主实验的 4096 关键点会更高。
- 训练 2–8 视图,评测 25 视图。外推有效,但视图数收益不是单调的;论文没有证明「更多视图总是更好」。
- 只评了相对位姿。没有接入完整 global SfM,也没有评绝对位姿、重定位或重建质量;匹配器与全局优化的相互作用未知。
- 代码和权重尚未发布。论文说会随发表释放,但当前项目页只有 “CodeSoon”,复现性暂时无法独立验证。
5.2 我自己再补几条
- 2.20× 不是端到端加速。它只测 matcher;DA3-G 编码器前向、描述子提取和 RANSAC 都没算。对一个已经要跑多视图基础模型的系统,端到端收益可能小得多;反过来,如果基础模型本来就要跑(例如同时要深度/位姿),matcher 的节省才有意义。论文应该补一个 end-to-end latency,哪怕只报单卡、固定 25 视图。
- 主表缺少 CoMatcher。CoMatcher 是论文自己在相关工作中点名的 groupwise 匹配器,但 Table 1 里没有它。MV-RoMa 因为 OOM 只能 13 视图,比较已经不完全对等;再加上 CoMatcher 缺席,多视图匹配器之间的横向比较仍然不完整。可能是因为输出形式/任务不完全可比,但论文没有解释。
- 宏平均掩盖了数据集差异。Mip-NeRF 360 @1° 输给 RoMa/RoMa v2,T&T @1° 输给 LoMa-L;这两个「输」在宏平均里被 HyperSim 和 ScanNet++ 的增益抵消了。如果应用场景是室外大基线或精细稠密匹配,MVLoMa 不一定是最佳选择。
- 训练/评测集有重叠风险。HyperSim、ScanNet++、TerraSky3D 都在训练混合里,也都在评测里;正文没有场景级 split,附录只对 TerraSky3D 注明开源 JSON split。标准 split 下这可能完全合法,但读者需要额外核对,不能把这几项直接当作跨域泛化。
- 没有显式的多视图循环一致性。每条边独立做 dual-softmax 和对极负样本,邻居之间的一致性只通过共享中心间接体现。一个中心 keypoint 可能同时匹配到邻居 A 和 B,但 A–B 之间的对应不一定被检查;在重复纹理场景,这仍然可能产生一致的错误 track。加一个轻量的三视图 cycle 检查,或者让邻居–邻居做稀疏的、只针对候选 track 的通信,是很自然的下一步。
- 中心选择没有被讨论。星形图假定中心是固定的;如果中心本身遮挡严重或纹理弱,所有边都会受影响。论文没有做「换中心」的消融,也没有学习 view selection。实际 SfM 里中心往往是启发式选的,这个假设值得研究。
- 「Any foundation model」有接口成本。要接一个新编码器,必须保证多视图融合后的 token 空间对齐、维度可投影、分辨率匹配;这不是零成本 plug-and-play。Table 4 只试了四个编码器,而且 DA3-G 明显最好,「any」目前更像「几种主流编码器」。
- 没有失败案例分析。论文的定性图都是成功例子;纹理弱、遮挡重、动态物体、低重叠的失败模式没有系统展示。对一篇讲鲁棒匹配的论文,失败分析比成功图更有信息量。
六、结论与展望
MVLoMa 的故事线其实很简单:匹配器的计算单位应该和几何证据的单位对齐。星形图是 SfM、定位、关键帧跟踪里最常见的局部结构;逐对匹配不仅重复计算中心,还丢掉了跨邻居的证据。MVLoMa 的答案是三层复用:
- 复用基础模型的几何表示:冻结的多视图编码器已经把整个星形图编码过一遍,最后一层 token 直接拿来做描述子,不再单独跑 DINOv2;
- 复用中心表示:星形注意力让中心只算一次,所有边共享;每条边仍然保留自己的 score matrix,RANSAC 接口不变;
- 复用几何约束:用可见性过滤的 GT 去掉错误正样本,用对极负样本压掉高置信度外点。
结果上,它在 25 视图宏平均上超过 LoMa-L 和 RoMa v2,严格阈值收益更明显;代价是显存和「依赖冻结几何特征」。它不是一个「全面替代稠密匹配」的方法,而是一个在星形结构里更合适的稀疏匹配原语:如果你的系统本来就要跑多视图几何基础模型、又需要逐边稀疏对应给 RANSAC,那么 MVLoMa 的设计是顺的;如果你只匹配一对图,或者显存很紧,逐对 LoMa / RoMa 仍然更简单。
给实践者的几条建议:
- 先确认你的结构真的是星形。如果邻居之间也大量共视,星形拓扑会浪费邻居–邻居的约束;如果邻居之间几乎不共视,星形就是对的。
- 先算端到端账。把基础模型前向、描述子、matcher、RANSAC 都算进去,再判断 2.20× 的 matcher 加速是否值得 979 MiB 的显存。
- 不要只看宏平均。室外大基线看 Mip-NeRF 360 和 T&T 的单点结果,室内重复纹理看 HyperSim / ScanNet++,按你的场景选。
- 等代码。项目页目前是 CodeSoon;在权重和训练配置释放之前,复现和二次开发都有风险。
往后看,最值得期待的方向是让邻居之间做稀疏的、有选择的通信:不是全连接,而是只对共享中心 keypoint 形成的候选 track 做三视图一致性检查;再结合 view selection,决定哪些邻居值得放进星形图。另一个方向是把 MVLoMa 接进完整的 global SfM,看看局部匹配的增益能不能传到最后的重建质量,而不是停在相对位姿 AUC 上。论文自己也把「学习 view selection / confidence-aware neighbor aggregation」列为未来工作,这两个方向都比继续堆视图数更有意思。
参考
- Lu, Wei, Tang, Zhang, Fang, Li. MVLoMa: Multi-View Local Feature Matching with Any Geometry Foundation Model. arXiv 2610.31321, 2026. arXiv · 项目页
- Sarlin, DeTone, Malisiewicz, Rabinovich. SuperGlue: Learning Feature Matching with Graph Neural Networks. CVPR 2020. arXiv · 代码
- Lindenberger, Sarlin, Pollefeys. LightGlue: Local Feature Matching at Light Speed. ICCV 2023. arXiv · 代码
- Nordström, Edstedt, et al. LoMa: Local Feature Matching Revisited. ECCV 2026. arXiv · 代码
- Sun, Shen, Wang, Bao, Zhou. LoFTR: Detector-Free Local Feature Matching with Transformers. CVPR 2021. arXiv · 代码
- Edstedt, Sun, Bökman, Wadenbäck, Felsberg. RoMa: Robust Dense Feature Matching. CVPR 2024. arXiv · 代码
- Edstedt, Nordström, et al. RoMa v2: Harder Better Faster Denser Feature Matching. ECCV 2026. arXiv · 代码
- Zhang, Xia, Dong, Shen, Yue, Zheng. CoMatcher: Multi-View Collaborative Feature Matching. CVPR 2025. arXiv
- Lee, Kang, Yoo. MV-RoMa: From Pairwise Matching into Multi-View Track Reconstruction. CVPR 2026. arXiv
- Wang, Leroy, Cabon, Chidlovskii, Revaud. DUSt3R: Geometric 3D Vision Made Easy. CVPR 2024. arXiv · 代码
- Leroy, Cabon, Revaud. Grounding Image Matching in 3D with MASt3R. ECCV 2024. arXiv · 代码
- Wang, Chen, Karaev, Vedaldi, Rupprecht, Novotny. VGGT: Visual Geometry Grounded Transformer. CVPR 2025. arXiv · 代码
- Wang, Zhou, Zhu, Chang, Zhou, Li, Chen, Pang, Shen, He. π³: Permutation-Equivariant Visual Geometry Learning. arXiv 2507.13347, 2025. arXiv
- Lin, Chen, Liew, Chen, Li, Shi, Feng, Kang. Depth Anything 3: Recovering the Visual Space from Any Views. arXiv 2511.10647, 2025. arXiv
- Edstedt, Bökman, Wadenbäck, Felsberg. DaD: Distilled Reinforcement Learning for Diverse Keypoint Detection. arXiv 2503.07347, 2025. arXiv · 代码
- Hartley, Zisserman. Multiple View Geometry in Computer Vision. Cambridge University Press, 2004. DOI
- Oquab, Darcet, Moutakanni, et al. DINOv2: Learning Robust Visual Features without Supervision. TMLR 2024. arXiv · 代码
- Su, Lu, Pan, Wen, Liu. RoFormer: Enhanced Transformer with Rotary Position Embedding. Neurocomputing 2024. arXiv
- Roberts, Ramapuram, Ranjan, et al. Hypersim: A Photorealistic Synthetic Dataset for Holistic Indoor Scene Understanding. ICCV 2021. arXiv · 代码
- Yeshwanth, Liu, Nießner, Dai. ScanNet++: A High-Fidelity Dataset of 3D Indoor Scenes. ICCV 2023. arXiv · 代码
- Barron, Mildenhall, Verbin, Srinivasan, Hedman. Mip-NeRF 360: Unbounded Anti-Aliased Neural Radiance Fields. CVPR 2022. arXiv
- Knapitsch, Park, Zhou, Koltun. Tanks and Temples: Benchmarking Large-Scale Scene Reconstruction. ACM TOG 2017. 项目页
- D'Urso, Hu, Sormann, Rossi, Fraundorfer. TerraSky3D: Multi-View Reconstructions of European Landmarks in 4K. CVPRW 2026. arXiv
- Vuong, Ghosh, Ramanan, Narasimhan, Tulsiani. AerialMegaDepth: Learning Aerial-Ground Reconstruction and View Synthesis. CVPR 2025. arXiv
- Larsson, et al. PoseLib: Minimal Solvers for Camera Pose Estimation. GitHub. GitHub
- Li, Snavely. MegaDepth: Learning Single-View Depth Prediction from Internet Photos. CVPR 2018. arXiv · 项目页