· 73 min read
论文解读:XFeat,把局部特征匹配压进 CPU 实时预算
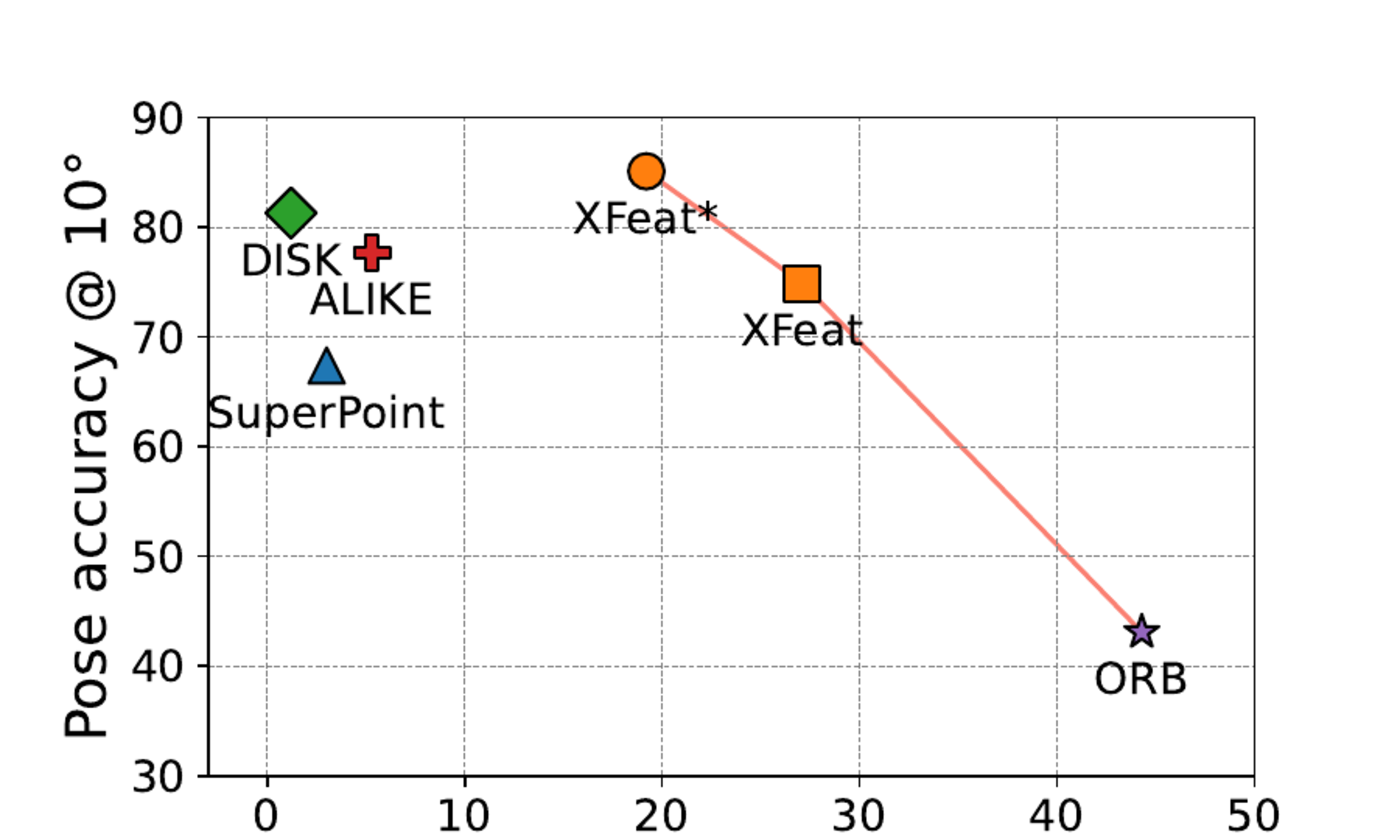
TL;DR XFeat 是 CVPR 2024 的轻量局部特征网络[1],目标不是再刷一项匹配精度,而是把「检测 + 描述 + 匹配」整体压进没有 GPU 的实时预算。它的做法很克制:23 层卷积、从 4 通道起步、每下采样一次就把通道数大约翻三倍,把大部分计算留给低分辨率层;检测头不接在描述子特征上,而是把原图切成 8×8 块,用 1×1 卷积直接分类 65 个位置(64 个格内位置 + dustbin)。同一个 backbone 同时给出稀疏关键点、64 维稠密描述子和可靠性图,半稠密的 XFeat* 再用一个 8×8 偏移分类 MLP 把粗匹配精化到像素级。VGA 输入、i5-1135G7 CPU 上 XFeat 27.1 FPS、XFeat* 19.2 FPS,而 SuperPoint 3.0、ALIKE 5.3、DISK 1.2 FPS;MegaDepth-1500 上 XFeat* 的 AUC@20 为 77.1、Acc@10 为 85.1,均高于 DISK*(75.3 / 81.3),速度快 16 倍。官方代码与权重以 Apache-2.0 开源,训练脚本也在仓库里。
- 论文:XFeat: Accelerated Features for Lightweight Image Matching,Guilherme Potje、Felipe Cadar、André Araujo、Renato Martins、Erickson R. Nascimento,UFMG / Université de Bourgogne / Google Research / Université de Lorraine / Microsoft,CVPR 2024,pp. 2682–2691。
- 代码:github.com/verlab/accelerated_features(Apache-2.0;
weights/xfeat.pt随仓库提供,推理、训练、MegaDepth-1500 / ScanNet-1500 评测脚本齐全)。 - 前作 / 生态:SuperPoint、ALIKE、ALIKED、DISK、LoFTR、LightGlue、XoFTR。
一、动机:精度竞赛的账单落在 上
局部特征的三件事——检测、描述、匹配——在过去几年被深度模型逐一接管,但精度提升的账单主要记在计算量上。SuperPoint 用 VGG 式 backbone 在 分辨率输出 256 维描述子[2];ALIKE 把描述子头做得更轻,却仍要在接近原图的分辨率上保留最终特征图[3];DISK 用 U-Net 和策略梯度训练,128 维描述子在 MegaDepth-1500 上很强,但 VGA CPU 只有 1.2 FPS[4];LoFTR[5]、DKM[6] 这类 detector-free / dense matcher 把匹配精度推得更高,代价是 transformer 和稠密特征图;LightGlue 把稀疏匹配器加速了,但它本身仍是 transformer,MegaDepth-1500 上 0.31 对/秒[7]。
问题在于,局部特征和分类网络对分辨率的要求相反。分类可以把输入缩到 224,局部特征却需要高分辨率才能给出像素级对应;而卷积的计算量是
其中 是第 层的空间尺寸, 是输入/输出通道数, 是卷积核大小。早期层的 最大,恰恰是最贵的地方。把通道整体砍掉会伤精度,用 depthwise separable convolution 在分类网络里很有效,但局部特征 backbone 通常更浅、输入更大,这一招的收益有限。
XFeat 的选择是:保持分辨率,压缩早期通道,把深度和容量挪到低分辨率层。具体落到三条贡献上:
- 一个 featherweight CNN backbone,在资源受限设备上直接跑,不依赖硬件特定的算子优化;
- 一个极简的可学习关键点分支,用 卷积在原图的 块上做分类,适合很小的 backbone;
- 一个仅依赖粗描述子的匹配精化模块,让半稠密匹配也能在 CPU 上实时。
论文的动机图(图 1)把这件事讲得很直白:横轴是 VGA 下的 FPS,纵轴是 MegaDepth-1500 的相对位姿 Acc@10°。XFeat 和 XFeat* 连成一条位于右上方的 Pareto 前沿;DISK 在左上但只有 1.2 FPS,ALIKE 在 5.3 FPS,SuperPoint 在 3.0 FPS,ORB 在 44.3 FPS 但精度掉到 43.1。
二、核心方法
2.1 总体架构:一个 backbone,三个输出
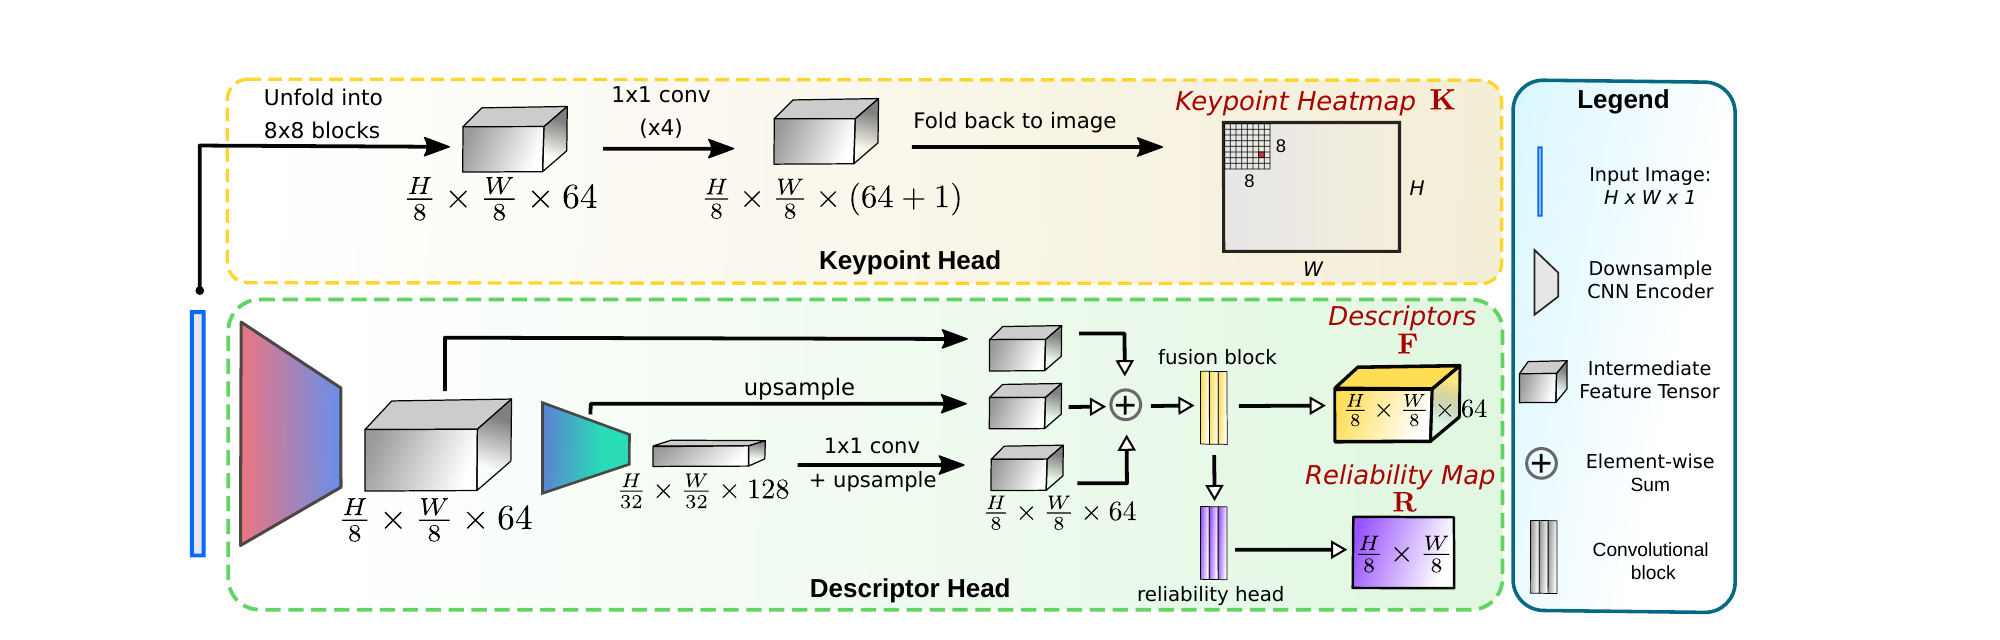
XFeat 的输入是灰度图(RGB 先按通道取平均),先做一次 InstanceNorm,然后进入 6 个卷积 block。输出有三样:
- 描述子图 ;
- 可靠性图 ,表示每个位置的描述子「能被自信匹配」的无条件概率;
- 关键点 logits ,每个 单元对应 64 个格内位置加一个 dustbin。
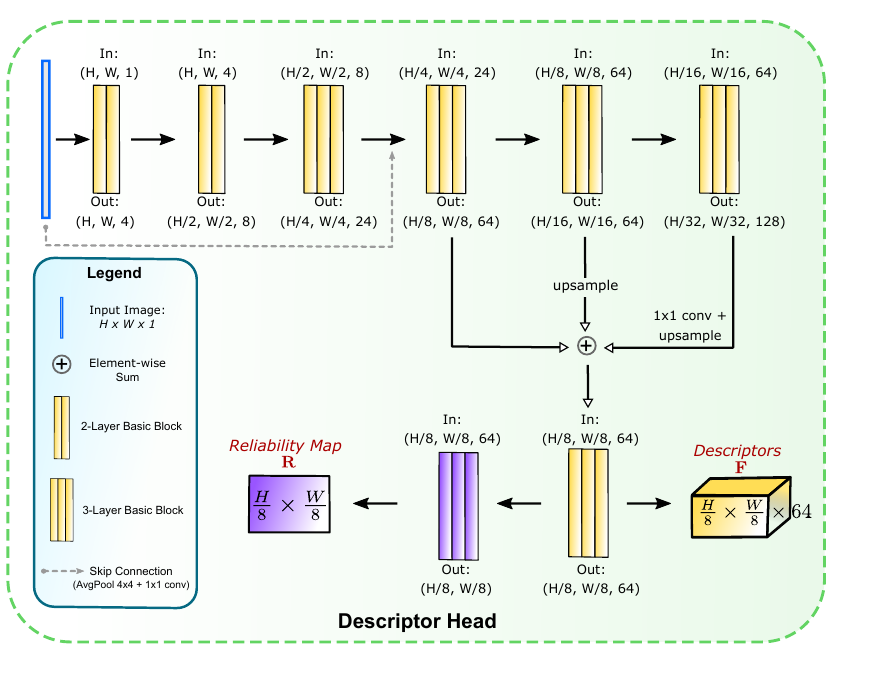
描述子不是只取最后一层。网络把 、、 三个尺度的中间特征双线性上采样到 ,逐元素相加,再过一个 3 层 fusion block,得到 ;可靠性图由 再接一个小卷积头回归。这样做的目的是在不显著增加计算量的前提下扩大感受野,让 的特征也能「看到」 的上下文。
最关键的结构差异在关键点分支:它不接在描述子特征上,而是直接接在原图上。原图被展开成 的非重叠块,每个块变成一个 64 维向量,然后连续过四个 卷积,输出 65 类 logits。也就是说,检测器看到的始终是低层像素结构,而不是已经被描述子任务重塑过的高层特征。
论文在消融里专门验证了「解耦检测」的必要性。把关键点头改成接在描述子特征上(类似 SuperPoint 的 joint 训练),稀疏模式的 AUC@5° 从 42.6 微升到 42.9,但半稠密的 XFeat* 从 50.2 掉到 39.7。作者的解释是:小网络的中间嵌入容量有限,让描述子特征同时承担检测任务,会削弱它在不可重复区域上的表达能力,而半稠密匹配的精化恰恰依赖这些区域的粗描述子。
代码:backbone、三个头和匹配精化 MLP(官方 modules/model.py,原文照录)
class BasicLayer(nn.Module):
	"""
	  Basic Convolutional Layer: Conv2d -> BatchNorm -> ReLU
	"""
	def __init__(self, in_channels, out_channels, kernel_size=3, stride=1, padding=1, dilation=1, bias=False):
		super().__init__()
		self.layer = nn.Sequential(
									  nn.Conv2d( in_channels, out_channels, kernel_size, padding = padding, stride=stride, dilation=dilation, bias = bias),
									  nn.BatchNorm2d(out_channels, affine=False),
									  nn.ReLU(inplace = True),
									)

	def forward(self, x):
	  return self.layer(x)

class XFeatModel(nn.Module):
	"""
	   Implementation of architecture described in
	   "XFeat: Accelerated Features for Lightweight Image Matching, CVPR 2024."
	"""

	def __init__(self):
		super().__init__()
		self.norm = nn.InstanceNorm2d(1)


		########### ⬇️ CNN Backbone & Heads ⬇️ ###########

		self.skip1 = nn.Sequential(	 nn.AvgPool2d(4, stride = 4),
			  						 nn.Conv2d (1, 24, 1, stride = 1, padding=0) )

		self.block1 = nn.Sequential(
										BasicLayer( 1,  4, stride=1),
										BasicLayer( 4,  8, stride=2),
										BasicLayer( 8,  8, stride=1),
										BasicLayer( 8, 24, stride=2),
									)

		self.block2 = nn.Sequential(
										BasicLayer(24, 24, stride=1),
										BasicLayer(24, 24, stride=1),
									 )

		self.block3 = nn.Sequential(
										BasicLayer(24, 64, stride=2),
										BasicLayer(64, 64, stride=1),
										BasicLayer(64, 64, 1, padding=0),
									 )
		self.block4 = nn.Sequential(
										BasicLayer(64, 64, stride=2),
										BasicLayer(64, 64, stride=1),
										BasicLayer(64, 64, stride=1),
									 )

		self.block5 = nn.Sequential(
										BasicLayer( 64, 128, stride=2),
										BasicLayer(128, 128, stride=1),
										BasicLayer(128, 128, stride=1),
										BasicLayer(128,  64, 1, padding=0),
									 )

		self.block_fusion =  nn.Sequential(
										BasicLayer(64, 64, stride=1),
										BasicLayer(64, 64, stride=1),
										nn.Conv2d (64, 64, 1, padding=0)
									 )

		self.heatmap_head = nn.Sequential(
										BasicLayer(64, 64, 1, padding=0),
										BasicLayer(64, 64, 1, padding=0),
										nn.Conv2d (64, 1, 1),
										nn.Sigmoid()
									)


		self.keypoint_head = nn.Sequential(
										BasicLayer(64, 64, 1, padding=0),
										BasicLayer(64, 64, 1, padding=0),
										BasicLayer(64, 64, 1, padding=0),
										nn.Conv2d (64, 65, 1),
									)


  		########### ⬇️ Fine Matcher MLP ⬇️ ###########

		self.fine_matcher =  nn.Sequential(
											nn.Linear(128, 512),
											nn.BatchNorm1d(512, affine=False),
									  		nn.ReLU(inplace = True),
											nn.Linear(512, 512),
											nn.BatchNorm1d(512, affine=False),
									  		nn.ReLU(inplace = True),
											nn.Linear(512, 512),
											nn.BatchNorm1d(512, affine=False),
									  		nn.ReLU(inplace = True),
											nn.Linear(512, 512),
											nn.BatchNorm1d(512, affine=False),
									  		nn.ReLU(inplace = True),
											nn.Linear(512, 64),
										)

	def _unfold2d(self, x, ws = 2):
		"""
			Unfolds tensor in 2D with desired ws (window size) and concat the channels
		"""
		B, C, H, W = x.shape
		x = x.unfold(2,  ws , ws).unfold(3, ws,ws)                             \
			.reshape(B, C, H//ws, W//ws, ws**2)
		return x.permute(0, 1, 4, 2, 3).reshape(B, -1, H//ws, W//ws)


	def forward(self, x):
		"""
			input:
				x -> torch.Tensor(B, C, H, W) grayscale or rgb images
			return:
				feats     ->  torch.Tensor(B, 64, H/8, W/8) dense local features
				keypoints ->  torch.Tensor(B, 65, H/8, W/8) keypoint logit map
				heatmap   ->  torch.Tensor(B,  1, H/8, W/8) reliability map

		"""
		#dont backprop through normalization
		with torch.no_grad():
			x = x.mean(dim=1, keepdim = True)
			x = self.norm(x)

		#main backbone
		x1 = self.block1(x)
		x2 = self.block2(x1 + self.skip1(x))
		x3 = self.block3(x2)
		x4 = self.block4(x3)
		x5 = self.block5(x4)

		#pyramid fusion
		x4 = F.interpolate(x4, (x3.shape[-2], x3.shape[-1]), mode='bilinear')
		x5 = F.interpolate(x5, (x3.shape[-2], x3.shape[-1]), mode='bilinear')
		feats = self.block_fusion( x3 + x4 + x5 )

		#heads
		heatmap = self.heatmap_head(feats) # Reliability map
		keypoints = self.keypoint_head(self._unfold2d(x, ws=8)) #Keypoint map logits

		return feats, keypoints, heatmap
2.2 Featherweight backbone:早下采样,通道三倍增长
XFeat 的基本单元叫 basic layer:一个 或 卷积,接 BatchNorm(affine=False)和 ReLU;需要下采样时把卷积步长设为 2。6 个 block 的通道数依次是
对应的空间分辨率是 、、、、、。整个 backbone 共 23 层卷积。注意通道数不是 VGG 式的「每下采样一次翻倍」,而是大约三倍增长:,到 64 后保持一层,最后到 128。论文的说法是,传统的翻倍策略要求早期就有较多通道,而早期的 又最大;从 4 通道起步、用三倍增长补偿容量,可以把参数和计算量挪到低分辨率层,同时保持 128 通道的最终宽度。
block 2 的输入还加了一条 skip connection:原图先做 平均池化,再用 卷积升到 24 通道,与 block 1 的输出相加。论文说这条 skip 在预实验中「略微提升性能」,于是保留下来。它给 分辨率的特征补了一条更短的梯度路径,也把原始像素的均值信息带进中层。
为了直观看出「早下采样 + 三倍增长」省在哪,我按官方 XFeatModel 的 27 次卷积(23 层 backbone + 三个头 + skip)逐层累加了乘加次数,并构造了一个对照:核大小、步长、层数完全不变,只把通道换成 VGG 式的 。640×480 输入下:
- XFeat:约 1.87 GMACs,0.66M 参数,前两级占总计算量的 14.7%;
- VGG 式对照:约 177.53 GMACs,28.57M 参数,前两级占 32.0%;
- 两者的下采样次数、卷积层数、最深特征的理论感受野完全相同(约 293 px,stride 32)。
这不是论文里的实测 baseline,而是我按结构做的玩具核算,但它把式 (1) 的结论放大了:把首层从 4 通道换成 64 通道,计算量涨约 95 倍,而感受野一点没变。下面的部件可以拖动输入宽度,看两套预算如何随分辨率缩放。
消融也说明「省」不能省错地方。把最后三个 block 的通道从 64 砍到 32(表 5 的 ii),参数量是更小了,但稀疏 AUC@5° 从 42.6 掉到 37.4,半稠密从 50.2 掉到 40.7。XFeat 的预算不是简单「越小越好」,而是把通道放在分辨率已经降下来的位置:那里每个通道的乘加更便宜,容量却仍然有用。
2.3 关键点分支:把 像素块变成 65 类分类
关键点头的输入不是特征图,而是原图。具体做法是:
- 把 的原图切成 的非重叠块,每个块展平成 64 维,得到 的张量;
- 过四个 卷积(前三个各 64 通道,最后一个输出 65 通道);
- 每个 单元产生 65 个 logits:前 64 个对应格内 64 个像素位置,第 65 个是 dustbin(该单元没有关键点)。
这相当于把「关键点在哪」变成「每个 单元里,64 个位置选一个,或者一个都不选」。 卷积只混合通道、不混合空间,计算量是 量级,比在 特征上堆 卷积便宜得多;同时它保留了块内的空间粒度,不需要上采样就能回到像素级。
监督信号来自 ALIKE-tiny 的知识蒸馏。对每个单元,把教师关键点坐标 映射成线性下标
没有关键点时设 。训练时对负样本(dustbin)做 的降采样,避免类别极度不平衡,然后用 NLL 损失。作者选 ALIKE-tiny 而不是更大的教师,理由是 tiny backbone 更关注角点、线段、斑点这类低层结构,和这个只有 感受野的检测分支更匹配。
推理时,65 类 logits 先做 softmax,丢掉 dustbin,把剩下 64 个概率折回 的关键点热图;然后做 的 NMS(阈值 0.05),每个关键点的分数取
其中 用最近邻插值、 用双线性插值到像素坐标。最后按分数保留 top-k(论文默认 4,096),描述子在对应位置从 双三次插值并 L2 归一化。
代码:关键点热图解码与 NMS(官方 modules/xfeat.py,原文照录)
	def get_kpts_heatmap(self, kpts, softmax_temp = 1.0):
		scores = F.softmax(kpts*softmax_temp, 1)[:, :64]
		B, _, H, W = scores.shape
		heatmap = scores.permute(0, 2, 3, 1).reshape(B, H, W, 8, 8)
		heatmap = heatmap.permute(0, 1, 3, 2, 4).reshape(B, 1, H*8, W*8)
		return heatmap

	def NMS(self, x, threshold = 0.05, kernel_size = 5):
		B, _, H, W = x.shape
		pad=kernel_size//2
		local_max = nn.MaxPool2d(kernel_size=kernel_size, stride=1, padding=pad)(x)
		pos = (x == local_max) & (x > threshold)
		pos_batched = [k.nonzero()[..., 1:].flip(-1) for k in pos]

		pad_val = max([len(x) for x in pos_batched])
		pos = torch.zeros((B, pad_val, 2), dtype=torch.long, device=x.device)

		#Pad kpts and build (B, N, 2) tensor
		for b in range(len(pos_batched)):
			pos[b, :len(pos_batched[b]), :] = pos_batched[b]

		return pos
2.4 描述子与可靠性:64 维, 分辨率
描述子头输出 的稠密特征。64 维是刻意的选择:匹配代价是 ,比 128/256 维省一半到四分之三;在 CPU 上,描述子维度和匹配矩阵往往比 backbone 更早成为瓶颈。论文表 1 里 XFeat 的 MIR 是 0.55,高于 SuperPoint 的 0.35 和 ALIKE 的 0.47,说明低维并没有让匹配变得更含糊。
可靠性图 是另一个输出。它估计的是「这个位置的描述子能否被自信匹配」的无条件概率,训练时用 dual-softmax 的匹配置信度作为目标:对描述子相似度矩阵 做行/列 softmax,取两个方向的最大概率之积
再用 L1 损失监督 和 去拟合 ,且梯度只回传到 。这个图有三个用途:给关键点分数加权、在半稠密模式里选 top-k 个最可信的位置、以及作为匹配前的轻量筛选。
稀疏匹配本身很直接:两张图的描述子做 mutual nearest neighbor(MNN),可选的余弦相似度阈值在 match() 里默认 0.82,但 match_xfeat() 默认不设阈值(min_cossim=-1)。论文的表格用的是 MNN + RANSAC,没有额外的学习型匹配器。
2.5 半稠密 XFeat*:粗匹配 + 偏移分类
XFeat* 不复用稀疏关键点,而是直接在 的稠密描述子图上工作:
- 把输入图缩放到两个尺度(论文 0.65 和 1.3;代码默认 0.6 和 1.3),分别前向;
- 每个尺度按可靠性图取 top-k,总共 10,000 个特征(代码里低尺度占 20%,高尺度占 80%);
- 对粗描述子做 MNN,得到一批粗匹配;
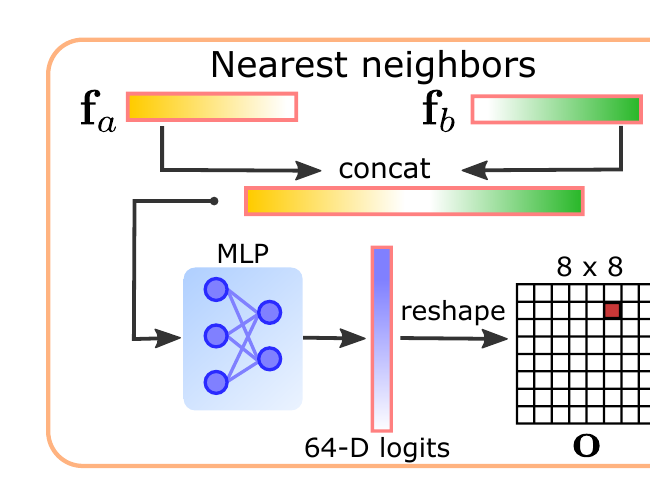
- 对每个粗匹配,把两个 64 维描述子拼成 128 维,送入一个 4 层 MLP(128→512→512→512→512→64),输出 64 个 logits,reshape 成 的偏移分类图;
- 取 argmax 得到格内偏移 ,再用 softmax 的期望做亚像素化;置信度是 ,低于阈值(论文 0.2,代码 0.25)的匹配丢掉。
偏移分类的含义是:粗匹配只知道两个描述子单元在 分辨率上对应,但不知道它们在各自 像素块内的精确位置。MLP 只看这对描述子,就要判断「从 的单元中心到真正的对应点,在 网格里偏移多少」。搜索空间只有 64 类,所以这个头非常小;它不需要高分辨率特征图,也不需要 transformer 的全局注意力。
精化模块的代价很小。论文说,在 10,000 个描述子时它只增加约 11% 的推理成本;因为精化发生在 MNN 之后,只对已经匹配上的对做一次 MLP,计算量与匹配数成正比,而不是与像素数成正比。
消融里,去掉精化后 XFeat* 的 AUC@5° 从 50.2 掉到 38.6,是表 5 中最大的单项跌幅。这也解释了为什么 XFeat* 能在 19.2 FPS 下把 Acc@10° 做到 85.1:粗描述子负责召回,轻量分类头负责定位,两者分开。
代码:双尺度稠密特征提取(官方 modules/xfeat.py,原文照录)
	def extract_dualscale(self, x, top_k, s1 = 0.6, s2 = 1.3):
		x1 = F.interpolate(x, scale_factor=s1, align_corners=False, mode='bilinear')
		x2 = F.interpolate(x, scale_factor=s2, align_corners=False, mode='bilinear')

		B, _, _, _ = x.shape

		mkpts_1, feats_1 = self.extractDense(x1, int(top_k*0.20))
		mkpts_2, feats_2 = self.extractDense(x2, int(top_k*0.80))

		mkpts = torch.cat([mkpts_1/s1, mkpts_2/s2], dim=1)
		sc1 = torch.ones(mkpts_1.shape[:2], device=mkpts_1.device) * (1/s1)
		sc2 = torch.ones(mkpts_2.shape[:2], device=mkpts_2.device) * (1/s2)
		sc = torch.cat([sc1, sc2],dim=1)
		feats = torch.cat([feats_1, feats_2], dim=1)

		return mkpts, sc, feats
代码:偏移亚像素化与匹配精化(官方 modules/xfeat.py,原文照录)
	def subpix_softmax2d(self, heatmaps, temp = 3):
		N, H, W = heatmaps.shape
		heatmaps = torch.softmax(temp * heatmaps.view(-1, H*W), -1).view(-1, H, W)
		x, y = torch.meshgrid(torch.arange(W, device =  heatmaps.device ), torch.arange(H, device =  heatmaps.device ), indexing = 'xy')
		x = x - (W//2)
		y = y - (H//2)

		coords_x = (x[None, ...] * heatmaps)
		coords_y = (y[None, ...] * heatmaps)
		coords = torch.cat([coords_x[..., None], coords_y[..., None]], -1).view(N, H*W, 2)
		coords = coords.sum(1)

		return coords

	def refine_matches(self, d0, d1, matches, batch_idx, fine_conf = 0.25):
		idx0, idx1 = matches[batch_idx]
		feats1 = d0['descriptors'][batch_idx][idx0]
		feats2 = d1['descriptors'][batch_idx][idx1]
		mkpts_0 = d0['keypoints'][batch_idx][idx0]
		mkpts_1 = d1['keypoints'][batch_idx][idx1]
		sc0 = d0['scales'][batch_idx][idx0]

		#Compute fine offsets
		offsets = self.net.fine_matcher(torch.cat([feats1, feats2],dim=-1))
		conf = F.softmax(offsets*3, dim=-1).max(dim=-1)[0]
		offsets = self.subpix_softmax2d(offsets.view(-1,8,8))

		mkpts_0 += offsets* (sc0[:,None]) #*0.9 #* (sc0[:,None])

		mask_good = conf > fine_conf
		mkpts_0 = mkpts_0[mask_good]
		mkpts_1 = mkpts_1[mask_good]

		return torch.cat([mkpts_0, mkpts_1], dim=-1)
2.6 训练与损失:四项损失,6:4 混合数据
训练数据是 MegaDepth 的真实场景对加 COCO 的合成 warp 对,比例 6:4。所有图像 resize 到 (代码默认 (800, 608)),batch 为 10 对,Adam,初始学习率 ,每 30,000 次更新衰减 0.5,总共 160,000 次迭代。在一张 RTX 4090 上约 36 小时,训练加实时合成 warp 共占 6.5 GB 显存。论文特别提到磁盘 I/O 是主要瓶颈,因为 MegaDepth 的原图与深度图要从磁盘反复读。
合成 warp 同时做几何和光度变换,在 GPU 上实时生成。消融 (i) 去掉合成数据后,稀疏 AUC@5° 从 42.6 只掉到 41.5,但半稠密从 50.2 掉到 33.9——合成数据对精化模块尤其重要,因为它提供了大量可控的像素级对应。
四项损失分别是:
描述子 dual-softmax 损失。 对匹配的描述子集 ,计算相似度矩阵 ,对行和列分别做 softmax,取对角线元素的负对数似然,两个方向相加:
可靠性 L1 损失。 用 dual-softmax 的置信度 作为目标,监督可靠性图:
精化偏移 NLL 损失。 对每个匹配,由真值对应算出它在 网格里的偏移类别 ,对 MLP 的 64 个 logits 做 NLL:
关键点 NLL 损失。 对每个 单元的 65 类 logits 做 NLL,标签来自 ALIKE-tiny 的关键点位置或 dustbin:
总损失是四项的线性组合:
论文没有在正文给出 的具体值;官方 train.py 的做法是把四项损失各自算完后取平均,其中关键点位置损失额外乘 2、可靠性 L1 额外乘 3,精化损失在 coordinate_classification_loss 里按置信度加权并乘 2。这和论文 Eq. (5) 的「无加权 NLL」并不完全一致,属于发表后的实现漂移。
代码:描述子 dual-softmax 损失(官方 modules/training/losses.py,原文照录)
def dual_softmax_loss(X, Y, temp = 0.2):
    if X.size() != Y.size() or X.dim() != 2 or Y.dim() != 2:
        raise RuntimeError('Error: X and Y shapes must match and be 2D matrices')

    dist_mat = (X @ Y.t()) * temp
    conf_matrix12 = F.log_softmax(dist_mat, dim=1)
    conf_matrix21 = F.log_softmax(dist_mat.t(), dim=1)

    with torch.no_grad():
        conf12 = torch.exp( conf_matrix12 ).max(dim=-1)[0]
        conf21 = torch.exp( conf_matrix21 ).max(dim=-1)[0]
        conf = conf12 * conf21

    target = torch.arange(len(X), device = X.device)

    loss = F.nll_loss(conf_matrix12, target) + \
           F.nll_loss(conf_matrix21, target)

    return loss, conf
代码:关键点蒸馏损失(官方 modules/training/losses.py,原文照录)
def alike_distill_loss(kpts, img):

    C, H, W = kpts.shape
    kpts = kpts.permute(1,2,0)
    img = img.permute(1,2,0).expand(-1,-1,3).cpu().numpy() * 255

    with torch.no_grad():
        alike_kpts = torch.tensor( extract_alike_kpts(img), device=kpts.device )
        labels = torch.ones((H, W), dtype = torch.long, device = kpts.device) * 64 # -> Default is non-keypoint (bin 64)
        offsets = (((alike_kpts/8) - (alike_kpts/8).long())*8).long()
        offsets =  offsets[:, 0] + 8*offsets[:, 1]  # Linear IDX
        labels[(alike_kpts[:,1]/8).long(), (alike_kpts[:,0]/8).long()] = offsets

    kpts = kpts.view(-1,C)
    labels = labels.view(-1)

    mask = labels < 64
    idxs_pos = mask.nonzero().flatten()
    idxs_neg = (~mask).nonzero().flatten()
    perm = torch.randperm(idxs_neg.size(0))[:len(idxs_pos)//32]
    idxs_neg = idxs_neg[perm]
    idxs = torch.cat([idxs_pos, idxs_neg])

    kpts = kpts[idxs]
    labels = labels[idxs]

    with torch.no_grad():
        predicted = kpts.max(dim=-1)[1]
        acc =  (labels == predicted)
        acc = acc.sum() / len(acc)

    kpts = F.log_softmax(kpts)
    loss = F.nll_loss(kpts, labels, reduction = 'mean')

    return loss, acc
代码:精化偏移损失(官方 modules/training/losses.py,原文照录)
def coordinate_classification_loss(coords1, pts1, pts2, conf):
    '''
        Computes the fine coordinate classification loss, by re-interpreting the 64 bins to 8x8 grid and optimizing
        for correct offsets after warp
    '''
    #Do not backprop coordinate warps
    with torch.no_grad():

        coords1_detached = pts1 * 8

        #find offset
        offsets1_detached = (coords1_detached/8) - (coords1_detached/8).long()
        offsets1_detached = (offsets1_detached * 8).long()
        labels1 = offsets1_detached[:, 0] + 8*offsets1_detached[:, 1]

    #pdb.set_trace()
    coords1_log = F.log_softmax(coords1, dim=-1)

    predicted = coords1.max(dim=-1)[1]
    acc =  (labels1 == predicted)
    acc = acc[conf > 0.1]
    acc = acc.sum() / len(acc)

    loss = F.nll_loss(coords1_log, labels1, reduction = 'none')

    #Weight loss by confidence, giving more emphasis on reliable matches
    conf = conf / conf.sum()
    loss = (loss * conf).sum()

    return loss * 2., acc
三、实验结果
3.1 设置
相对位姿在 MegaDepth-1500[8] 和 ScanNet-1500[9] 上评测,单应性在 HPatches[10] 上评测,视觉定位在 Aachen day-night[11] 上用 HLoc[12] 评测。MegaDepth 图像最长边缩到 1,200,ScanNet 用默认 VGA;Aachen 最长边 1,024。所有方法取 top 4,096 个关键点,带 ∗ 的取 top 10,000。对比方法覆盖手工特征 ORB、轻量学习型 SiLK[13] / SuperPoint / ALIKE / ZippyPoint[14],以及更重的 DISK[4]。匹配统一用 MNN,RANSAC 用 LO-RANSAC(MegaDepth/ScanNet)或 MAGSAC++(HPatches)。指标是 AUC@{5°,10°,20°}、Acc@10°、平均内点率(MIR)、内点数(#inliers)和 VGA CPU FPS。
3.2 MegaDepth-1500:严格阈值不占优,松阈值和半稠密占优
表 1 是最核心的一组数。先把结论说清楚:XFeat 并不是所有指标都第一。稀疏模式下,ALIKE 的 AUC@5° 是 49.4,DISK 是 53.8,XFeat 只有 42.6;XFeat 的强项在更松的阈值、内点率和速度。半稠密的 XFeat* 则把 AUC@20° 做到 77.1、Acc@10° 做到 85.1,分别超过 DISK* 的 75.3 和 81.3,而速度是 19.2 FPS 对 1.2 FPS。
| 方法 | AUC@5° | AUC@10° | AUC@20° | Acc@10° | MIR | #inliers | FPS |
|---|---|---|---|---|---|---|---|
| SiLK | 14.7 | 21.5 | 29.3 | 31.9 | 0.17 | 235 | 2.8 |
| SuperPoint | 37.3 | 50.1 | 61.5 | 67.4 | 0.35 | 495 | 3.0 |
| DISK | 53.8 | 65.9 | 75.0 | 81.3 | 0.72 | 1231 | 1.2 |
| DISK* | 55.2 | 66.8 | 75.3 | 81.3 | 0.71 | 1997 | 1.2 |
| ORB | 17.9 | 27.6 | 39.0 | 43.1 | 0.25 | 288 | 44.3 |
| ZippyPoint | 23.6 | 34.9 | 46.3 | 51.8 | 0.23 | 192 | — |
| ALIKE | 49.4 | 61.8 | 71.4 | 77.7 | 0.47 | 333 | 5.3 |
| XFeat | 42.6 | 56.4 | 67.7 | 74.9 | 0.55 | 892 | 27.1 |
| XFeat* | 50.2 | 65.4 | 77.1 | 85.1 | 0.74 | 1885 | 19.2 |
表 1:MegaDepth-1500 相对位姿估计。FPS 是 VGA 下 30 帧平均,硬件为 i5-1135G7 CPU;∗ 表示 10k 关键点。ZippyPoint 的 FPS 论文只标了「+」,没有给出可比数值。
几个值得注意的对比:
- XFeat vs SuperPoint:AUC@20° 67.7 对 61.5,MIR 0.55 对 0.35,内点数 892 对 495,速度 27.1 对 3.0 FPS。XFeat 在 AUC@20°、MIR、内点数和速度上全面胜出,严格阈值 AUC@5° 也略高(42.6 对 37.3)。
- XFeat vs ALIKE:ALIKE 在 AUC@5°/10°/20° 上都更高(49.4/61.8/71.4 对 42.6/56.4/67.7),但 XFeat 的 MIR 更高(0.55 对 0.47)、内点更多(892 对 333),速度快 5 倍。论文的定位是「可比精度下的效率」,不是「全面超过 ALIKE」。
- XFeat vs DISK**:AUC@20° 77.1 对 75.3,Acc@10° 85.1 对 81.3,MIR 0.74 对 0.71;内点数 1885 对 1997,略少,但速度 16 倍。XFeat* 用 10k 特征,DISK* 也用 10k,这是公平对比。
- 为什么松阈值更强:作者的解释是,XFeat 在 分辨率上插值描述子、在 网格上预测偏移,严格阈值下定位精度不如全分辨率特征;但 RANSAC 之后,更密的匹配和更高的内点率会补回来。
3.3 ScanNet-1500:室内泛化是亮点
ScanNet-1500 是室内场景,和 MegaDepth 的室外地标分布差异很大,所有方法都没有在 ScanNet 上重训。XFeat 和 XFeat* 在这里明显领先:
| 方法 | AUC@5° | AUC@10° | AUC@20° |
|---|---|---|---|
| SuperPoint | 12.5 | 24.4 | 36.7 |
| DISK (4k / 10k) | 9.6 / 11.3 | 19.3 / 22.3 | 30.4 / 33.9 |
| ORB | 9.0 | 18.5 | 29.9 |
| ALIKE | 8.0 | 16.4 | 25.9 |
| XFeat | 16.7 | 32.6 | 47.8 |
| XFeat* | 18.4 | 34.7 | 50.3 |
表 2:ScanNet-1500 相对位姿估计。XFeat 的 AUC@20° 为 50.3,比 SuperPoint 高 13.6 个点,比 DISK* 高 16.4 个点。*
论文把这种泛化归因于两点:合成 COCO warp 让描述子不过度依赖地标图像的纹理;更大的感受野和更深的层数让它在室内弱纹理区域也能保持区分度。DISK 和 ALIKE 都在 MegaDepth 上训练,在 MegaDepth 严格阈值上很强,但到了 ScanNet 和 HPatches 就出现明显的「地标偏置」。
3.4 HPatches:单应性估计与最准的描述子持平
HPatches 分 illumination 和 viewpoint 两个子集,指标是平均单应性精度(MHA)@{3,5,7} 像素。XFeat 在 illumination 上的 MHA@3 是 95.0,和 SuperPoint/DISK 的 94.6 基本持平;viewpoint 上是 68.6,低于 DISK 的 77.5,略高于 ALIKE 的 68.2,也高于 SuperPoint 的 66.4。ORB 和 SiLK 在 illumination 子集上明显崩掉(74.6 / 78.5),说明手工特征和过于简单的训练策略在光照变化下不够稳。
这组结果和 MegaDepth 的严格阈值结论一致:XFeat 的描述子不是「最准」,但在轻量方法里属于第一梯队,而且它的 64 维描述子在存储和匹配上都更便宜。
3.5 Aachen day-night:和 SOTA 持平,速度快 9 倍
视觉定位用 HLoc:先用关键点匹配建 SfM 地图,再定位查询图像。Aachen day-night 的指标是位置/旋转误差在 、、 内的召回率。
白天,XFeat 在三个阈值上是 84.7 / 91.5 / 96.5,SuperPoint 是 87.4 / 93.2 / 97.0,DISK 是 86.9 / 95.1 / 97.8,ALIKE 是 85.7 / 92.4 / 96.7。XFeat 略低,但差距在 1–3 个点内。夜晚更 challenging:XFeat 是 77.6 / 89.8 / 98.0,SuperPoint 是 77.6 / 85.7 / 95.9,DISK 是 83.7 / 89.8 / 99.0,ALIKE 是 81.6 / 88.8 / 99.0。XFeat 在 上超过 SuperPoint,和 DISK 持平;在 上低于 DISK/ALIKE。
论文的结论是「和领先方法性能相似,但至少快 9 倍,描述子更紧凑」。这个说法是准确的:它不是每个阈值都最好,但在 HLoc 这种以稀疏匹配为主的管线里,XFeat 的速度优势可以直接换成更大的地图或更低的硬件成本。
3.6 消融、运行时间与学习型匹配器
表 5 的消融把每个设计拆开:
| 配置 | XFeat AUC@5° | XFeat* AUC@5° |
|---|---|---|
| Default | 42.6 | 50.2 |
| (i) 去掉合成数据 | 41.5 | 33.9 |
| (ii) 更小的模型(后三层 32 通道) | 37.4 | 40.7 |
| (iii) 关键点与描述子联合提取 | 42.9 | 39.7 |
| (iv) 去掉匹配精化 | — | 38.6 |
表 3:MegaDepth-1500 消融。半稠密模式对合成数据、解耦检测和精化模块都非常敏感;稀疏模式对联合提取几乎不敏感。
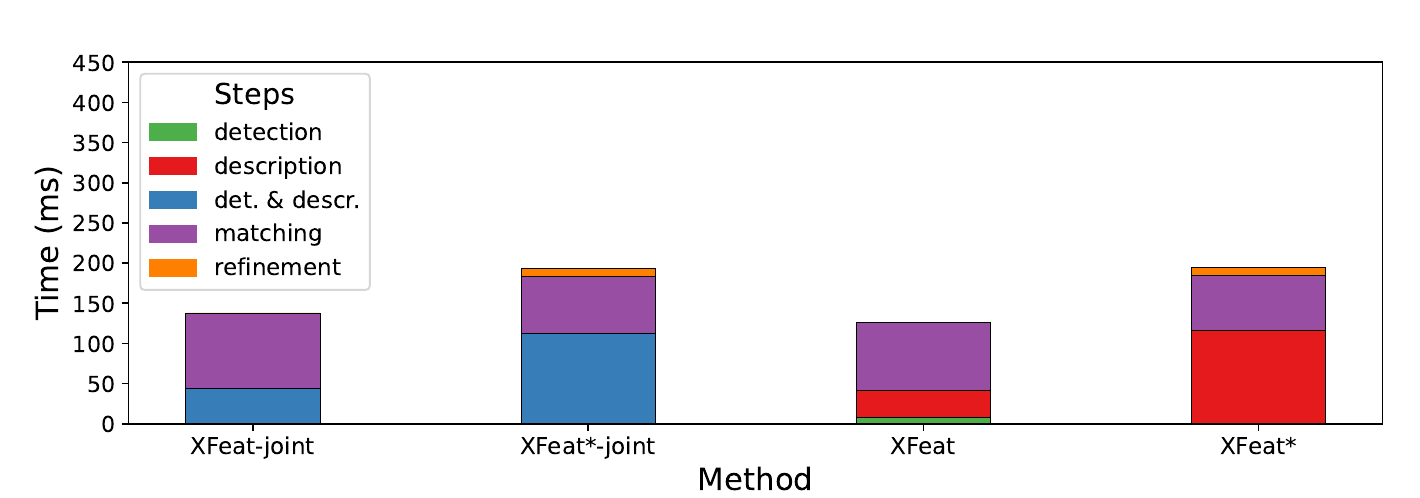
运行时间方面,图 5 把 XFeat 和 XFeat* 拆成检测、描述、匹配、精化四步。XFeat 的总时间约 130 ms,XFeat* 约 190 ms(i7-6700K,10k 特征);精化只占最上面一小条,和论文说的 11% 一致。精化之所以便宜,是因为它在 MNN 之后只对已匹配对做一次 MLP;匹配的大头仍然是描述子相似度矩阵。
在 Orange Pi Zero 3(Cortex-A53,480×360,标准 PyTorch,无部署优化)上,XFeat 1.8 FPS,ALIKE 0.58 FPS,SuperPoint 0.16 FPS。XFeat 是唯一超过 1 FPS 的学习型方法;SuperPoint 0.16 FPS 约 6.3 秒一帧。这个实验的意义不是「嵌入式实时」,而是「在 28 美元的板子上,学习型局部特征第一次变得可用」。
论文附录 F 还把 XFeat* 和 LoFTR、LightGlue、Patch2Pix 放在一起比(表 6):LoFTR 的 AUC@5° 是 68.3,但只有 0.06 对/秒;LightGlue 61.4,0.31 对/秒;Patch2Pix 47.8,0.05 对/秒;XFeat* 50.2,1.33 对/秒。XFeat* 比 LoFTR 低 18 个点,但快 22 倍。这不是同一类方法:LoFTR/LightGlue 用 transformer 做全局推理,XFeat* 用 MNN + 小 MLP 做局部精化。论文自己的定位也是「和 LightGlue 互补」——LightGlue 可以直接吃 XFeat 的特征,仓库里的 match_lighterglue 就是这么用的。
3.7 定性结果
图 6 是 MegaDepth-1500 的三个困难对。左边是强视角变化,XFeat* 的 R_err 0.65°、t_err 1.47°、701 个内点、MIR 0.73;DISK* 在同一对上是 19.89° / 70.37° / 24 个内点 / MIR 0.07。中间是强光照和重复结构,XFeat* 仍然给出 1.50° / 5.91° / 465 个内点;DISK* 是 34.05° / 43.09°。右边是 XFeat 对 ZippyPoint/ORB,XFeat 的 R_err 0.23°,ZippyPoint 1.23°,ORB 142.43°。
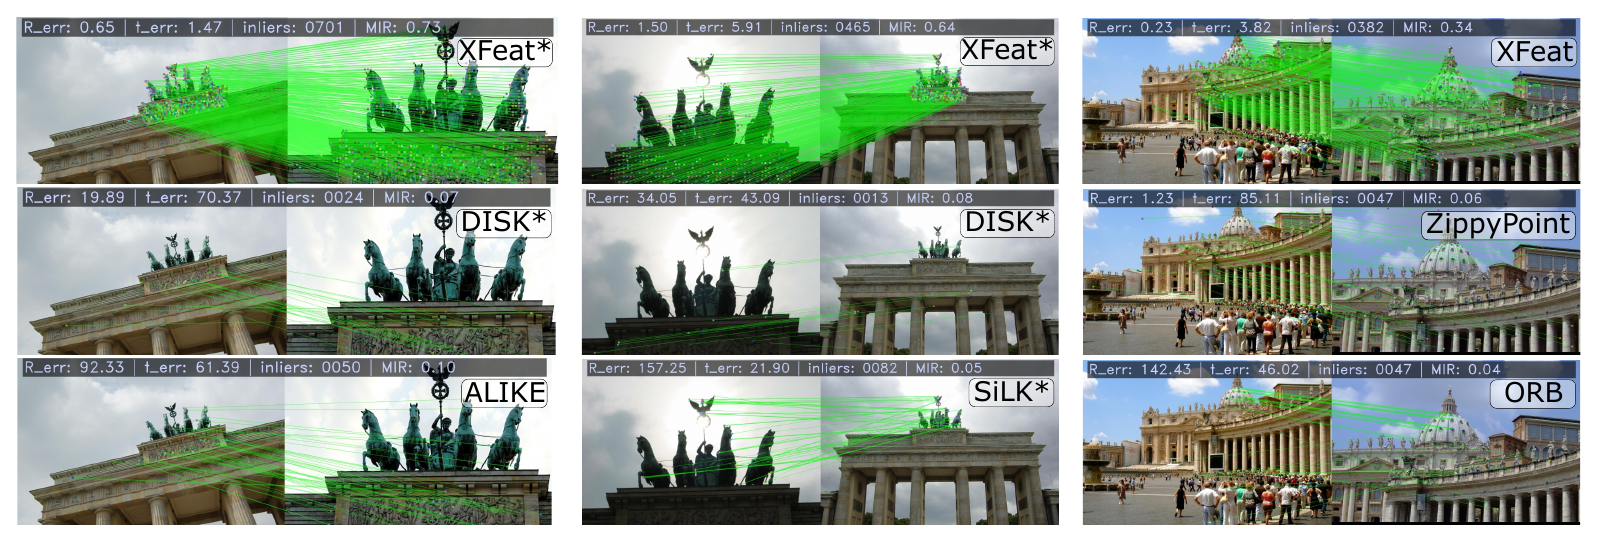
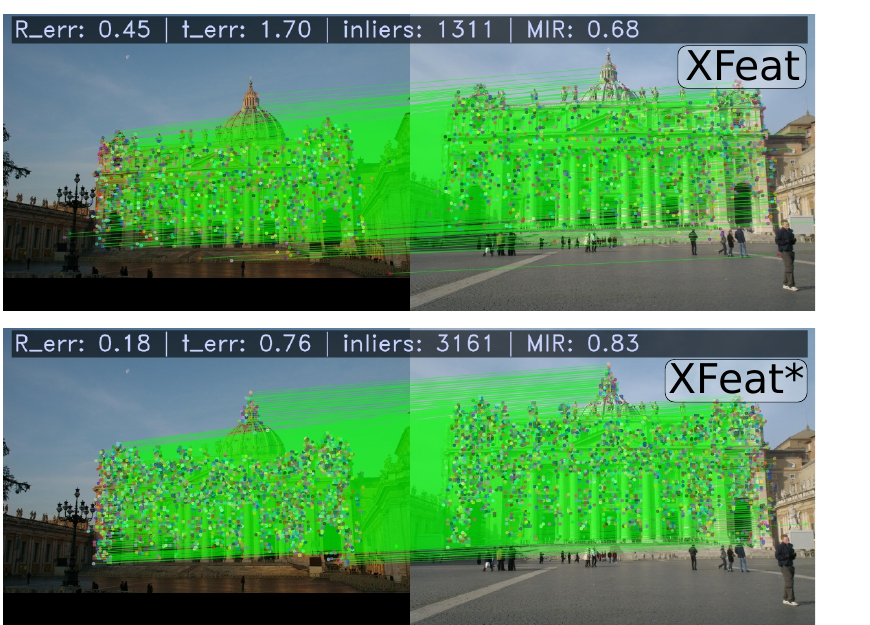
图 7 则是稀疏和半稠密的直接对比:同一对图像,XFeat 用 4,096 个关键点得到 1,311 个内点、MIR 0.68;XFeat* 用 10,000 个特征得到 3,161 个内点、MIR 0.83。半稠密的收益主要来自覆盖度,而不是单个匹配更准。
四、局限性
论文明确讨论的
- 严格阈值下的定位精度不是最强。 作者把这一点归因于描述子在 分辨率上插值、偏移在 网格上预测;因此 XFeat 的优势更多出现在较松的阈值(AUC@20°、Acc@10°)和 RANSAC 之后的内点率上。
- 对极端视角变化和高度歧义图像对,不如 transformer 匹配器。 附录 F 明确写道:XFeat 作为局部描述子,在 aggressive viewpoint changes 和 highly ambiguous pairs 上「offers limited robustness」,并建议和 LightGlue / LoFTR 的线性 transformer 结合使用。
- XFeat 的精化需要成对输入。* 稀疏特征可以按图独立缓存,半稠密的精化必须在匹配时看两张图的描述子对。论文的辩护是:粗特征仍然可以按图独立存储,精化只发生在匹配阶段,所以 SfM/定位的常规管线不变;但严格来说,这不是「完全独立的单图特征」。
- 论文没有专门的局限性章节。 上面三条是正文和附录里明确提到的;下面几条是我自己补充的观察,不是作者的原话。
我自己再补几条
- 稀疏模式是单尺度的。 官方
detectAndCompute只做一次前向,没有显式的图像金字塔;只有 XFeat* 用了 0.6/1.3 两个尺度。论文没有单独评测大幅尺度变化,实际使用时如果尺度差很大,稀疏模式的召回可能会先掉。这是我从代码里读出来的,不是论文的实验结论。 - 训练分辨率是 ,评测分辨率更高。 MegaDepth 最长边 1,200、Aachen 1,024,训练和测试存在分辨率错位;论文没有做分辨率消融。考虑到 XFeat 的检测头是固定的 网格,分辨率变化对格内偏移分类的影响值得单独测。
- 检测器完全依赖 ALIKE-tiny 的蒸馏。 论文解释了为什么选 tiny(低层结构匹配 感受野),但没有换教师、换关键点损失或自监督的对照实验。如果 ALIKE-tiny 在某个场景(比如弱纹理、重复结构)有系统性偏差,XFeat 会继承下来。
- 论文和代码有几处实现漂移。 半稠密尺度论文写 0.65/1.3,代码默认 0.6/1.3;精化置信度论文写 0.2,代码默认 0.25;训练分辨率论文写 ,代码默认
(800, 608);Eq. (5) 是无加权 NLL,代码的coordinate_classification_loss按置信度加权并乘 2。复现论文数字时要留意这些差异。 - 实验覆盖面有限。 论文只做了 MegaDepth、ScanNet、HPatches、Aachen 四组,没有 IMC、没有跨模态(红外/深度)、没有大尺度航拍。论文的「hardware-agnostic」也只验证了 x86 CPU 和 Cortex-A53,没有手机 NPU、GPU 或 WebAssembly 的实测。这些不是缺陷,但决定了它的适用边界。
五、结论与展望
XFeat 的故事线其实很简单:局部特征的精度很依赖分辨率,但分辨率的计算代价集中在早期层;与其把整个网络均匀缩小,不如把早期通道压到极低,再把容量挪到低分辨率层。 这个思路不新,但 XFeat 把它执行得很彻底:4 通道起步、三倍增长、23 层、64 维描述子、 输出,最后在 VGA CPU 上跑到 27.1 FPS。
第二个值得记住的设计是检测与描述解耦。SuperPoint 式的 joint 训练在小网络上会让描述子特征分心:稀疏模式下看不出来,半稠密模式下 AUC@5° 掉 10.5 个点。XFeat 用一条只接原图、只做 卷积的旁路把检测拿走,描述子分支就能专心做区分性。这个经验对任何「小 backbone + 多任务」的设计都适用。
第三个是半稠密匹配的精化方式。XFeat* 没有用高分辨率特征图,也没有用 transformer,而是把「像素级偏移」变成「 网格上的 64 类分类」,只对已匹配的描述子对做一次小 MLP。11% 的额外成本换来 AUC@5° 从 38.6 到 50.2,说明在很多任务里,粗匹配的召回才是瓶颈,精化不需要很重。
给实践者的建议:
- 如果你的管线是 CPU/边缘设备上的 SfM、视觉定位或 AR 前端,先试 XFeat 稀疏模式;4,096 个关键点、64 维描述子、27 FPS,替换 SuperPoint 通常能直接提速一个数量级。
- 如果需要稠密对应(比如相对位姿、单应性、神经渲染的初始化),用 XFeat*;10k 特征、19.2 FPS,精度接近 DISK*,但不要指望它超过 LoFTR/LightGlue。
- 如果场景视角变化很大、重复结构很多,把 XFeat 特征接到 LightGlue(仓库自带
match_lighterglue)或 LoFTR 的匹配器上;XFeat 负责快而稳的描述,transformer 负责全局歧义消解。 - 部署时先跑 ONNX / TensorRT / CoreML 的导出,再谈端侧实时;论文的 Orange Pi 实验是标准 PyTorch,1.8 FPS 不是优化后的上限。
未来方向也很清楚:稀疏模式的多尺度化、检测器教师的选择与自监督、量化/蒸馏后的端侧部署、以及和轻量 transformer 匹配器的更紧耦合。XFeat 已经把「特征提取」这一段的成本压得很低,接下来的瓶颈会更多落在匹配和后端优化上。
六、上手
官方仓库提供了完整的推理、训练和评测代码,权重 weights/xfeat.pt 随仓库提供。最小推理示例(来自 README):
import torch
from modules.xfeat import XFeat

xfeat = XFeat()
output = xfeat.detectAndCompute(torch.randn(1, 3, 480, 640), top_k=4096)[0]
# output: {'keypoints': (N,2), 'scores': (N,), 'descriptors': (N,64)}
也可以用 torch.hub 直接加载:
import torch
xfeat = torch.hub.load('verlab/accelerated_features', 'XFeat', pretrained=True, top_k=4096)
稀疏匹配用 match_xfeat(img1, img2),半稠密用 match_xfeat_star(img1, img2);两者都返回匹配点坐标。XFeat(top_k=...) 控制特征数,detectAndCompute 的 detection_threshold 控制 NMS 阈值(默认 0.05)。如果装了 Kornia,可以用 match_lighterglue 把 XFeat 的稀疏特征接到 LighterGlue 上。
安装命令(README 的 Python 3.8 + CPU 版 PyTorch)
git clone https://github.com/verlab/accelerated_features.git
cd accelerated_features
conda create -n xfeat python=3.8
conda activate xfeat
pip install torch==1.10.1+cpu -f https://download.pytorch.org/whl/cpu/torch_stable.html
pip install opencv-contrib-python tqdm
训练用 modules.training.train,默认就是论文的 xfeat_default:MegaDepth + 合成 COCO warp,6:4 混合,800×608,batch 10,160k 步。
训练命令(需要先准备 MegaDepth 和 coco_20k)
python3 -m modules.training.train \
  --training_type xfeat_default \
  --megadepth_root_path <path>/MegaDepth \
  --synthetic_root_path <path>/coco_20k \
  --ckpt_save_path /path/to/ckpts
评测 MegaDepth-1500 和 ScanNet-1500 的命令也在 README 里(含数据集下载):
评测命令(MegaDepth-1500 / ScanNet-1500)
python3 -m modules.dataset.download --megadepth-1500 --download_dir </path/to/desired/folder>
python3 -m modules.eval.megadepth1500 --dataset-dir </data/Mega1500> --matcher xfeat --ransac-thr 2.5
python3 -m modules.dataset.download --scannet-1500 --download_dir </path/to/desired/folder>
python3 -m modules.eval.scannet1500 --scannet_path </data/ScanNet1500> --output </data/ScanNet1500/output> && python3 -m modules.eval.scannet1500 --scannet_path </data/ScanNet1500> --output </data/ScanNet1500/output> --show
权重协议是 Apache-2.0,商用和二次训练都可以,但要注意仓库里第三方依赖(如 ALIKE 蒸馏用的 wrapper)各自的许可证。论文的训练代码是公开的,这一点比很多只放推理权重的局部特征工作要良心。
参考
- Potje, Cadar, Araujo, Martins, Nascimento. XFeat: Accelerated Features for Lightweight Image Matching. CVPR 2024. arXiv · 代码
- DeTone, Malisiewicz, Rabinovich. SuperPoint: Self-Supervised Interest Point Detection and Description. CVPR Workshops 2018. arXiv · 代码
- Zhao, Wu, Miao, Chen, Chen, Li. ALIKE: Accurate and Lightweight Keypoint Detection and Descriptor Extraction. IEEE Transactions on Multimedia, 2022. arXiv · 代码
- Tyszkiewicz, Fua, Trulls. DISK: Learning Local Features with Policy Gradient. NeurIPS 2020. arXiv · 代码
- Sun, Shen, Wang, Bao, Zhou. LoFTR: Detector-Free Local Feature Matching with Transformers. CVPR 2021. arXiv · 代码
- Edstedt, Athanasiadis, Wadenbäck, Felsberg. DKM: Dense Kernelized Feature Matching for Geometry Estimation. CVPR 2023. arXiv · 代码
- Lindenberger, Sarlin, Pollefeys. LightGlue: Local Feature Matching at Light Speed. ICCV 2023. arXiv · 代码
- Li, Snavely. MegaDepth: Learning Single-View Depth Prediction from Internet Photos. CVPR 2018. arXiv
- Dai, Chang, Savva, Halber, Funkhouser, Nießner. ScanNet: Richly-Annotated 3D Reconstructions of Indoor Scenes. CVPR 2017. arXiv
- Balntas, Lenc, Vedaldi, Mikolajczyk. HPatches: A Benchmark and Evaluation of Handcrafted and Learned Local Descriptors. CVPR 2017. CVF
- Sattler, Maddern, Toft, Torii, Hammarstrand, Stenborg, Safari, Okutomi, Pollefeys, Sivic, et al. Benchmarking 6DOF Outdoor Visual Localization in Changing Conditions. CVPR 2018. CVF
- Sarlin, Cadena, Siegwart, Dymczyk. From Coarse to Fine: Robust Hierarchical Localization at Large Scale. CVPR 2019. arXiv · 代码
- Gleize, Wang, Feiszli. SiLK: Simple Learned Keypoints. ICCV 2023. arXiv · 代码
- Kanakis, Maurer, Spallanzani, Chhatkuli, Van Gool. ZippyPoint: Fast Interest Point Detection, Description, and Matching through Mixed Precision Discretization. CVPR Workshops 2023. arXiv · 代码